Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
개발서버는 Lmstudio 로 모델 다운로드 중. Api 서버는 Codex 로 llama.cpp 서빙 설정 세팅 중.
아 불타는 금요일 밤 토요일 새벽이 되겠군. https://t.co/QSBBRrN8np
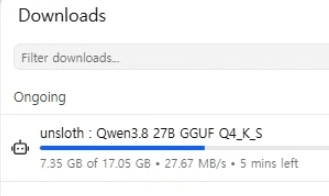
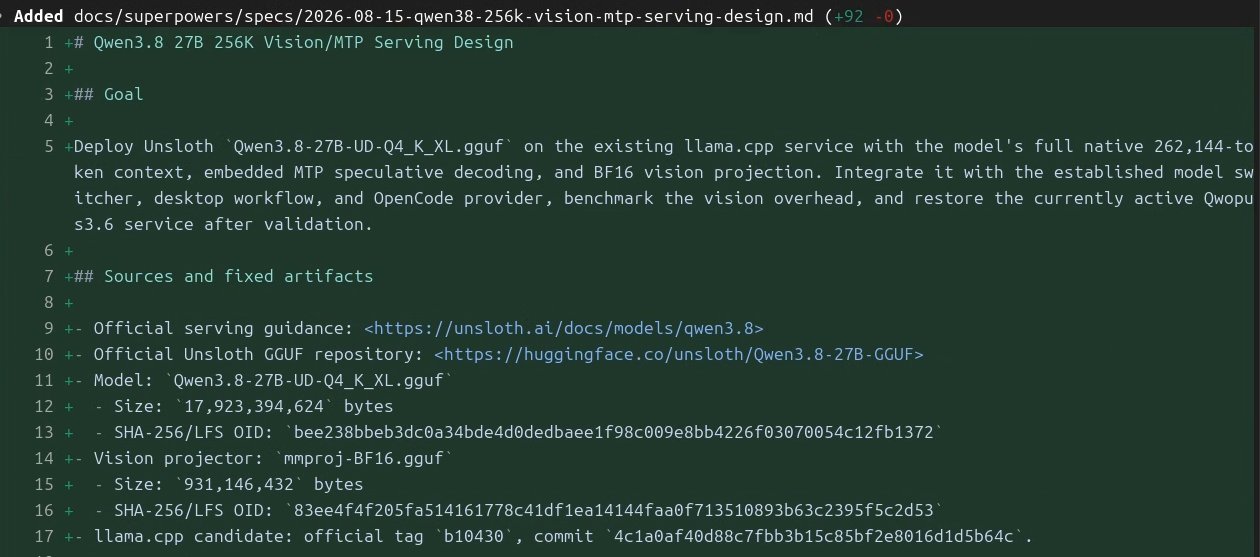
- 2@vdweqn 넹. Mtp 가 기본 적용된다고 합니다. 알려주셔서 감사합니다~원문 보기
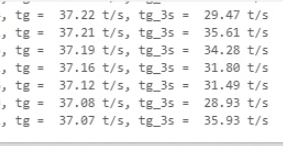
- 33090 / 85% Power limit Lmstudio 에서 속도가 이정도. Mtp 적용함. (2) https://t.co/4QUFUB1YRr원문 보기
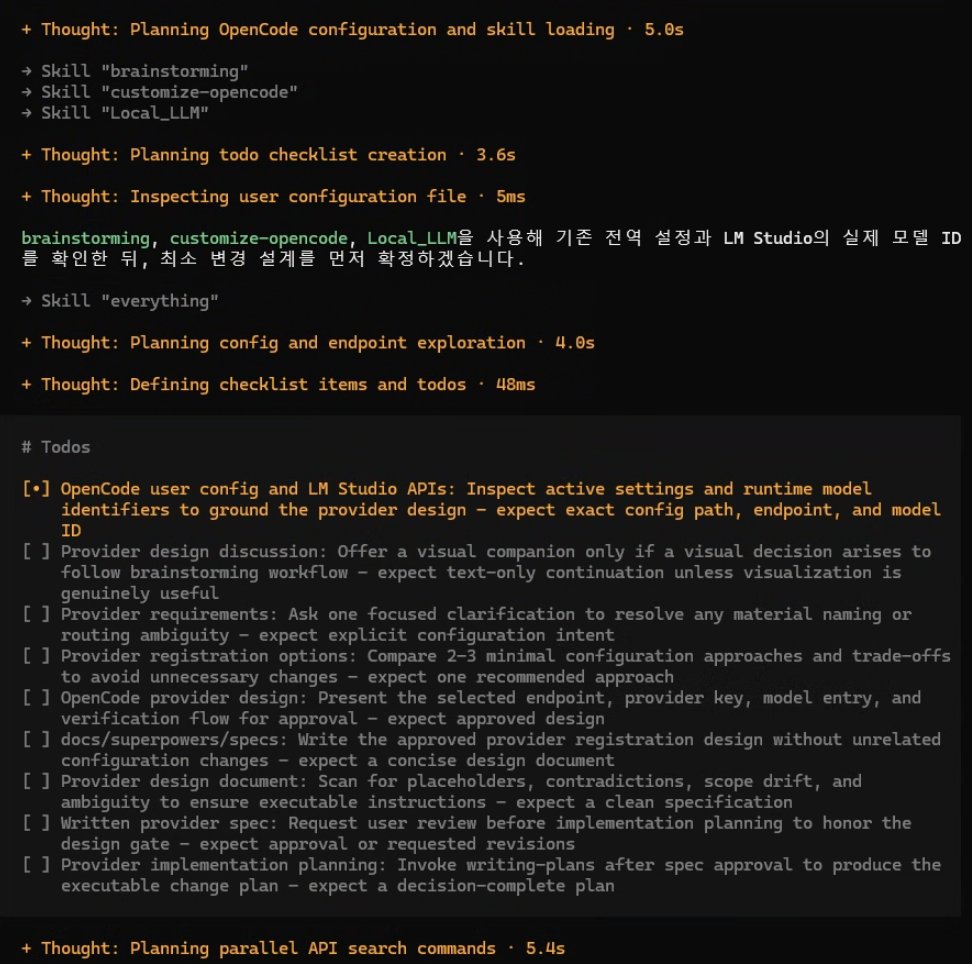
- 4헤이헤이헤이! 추론 버블이 너무 커요. 24K 를 쓰는데 아직도 추론 상태임. 안 멈추면 Opencode 로 바꾸어서 테스트 해 봐야지. https://t.co/tchksjt3Oc원문 보기
- 5원문 보기
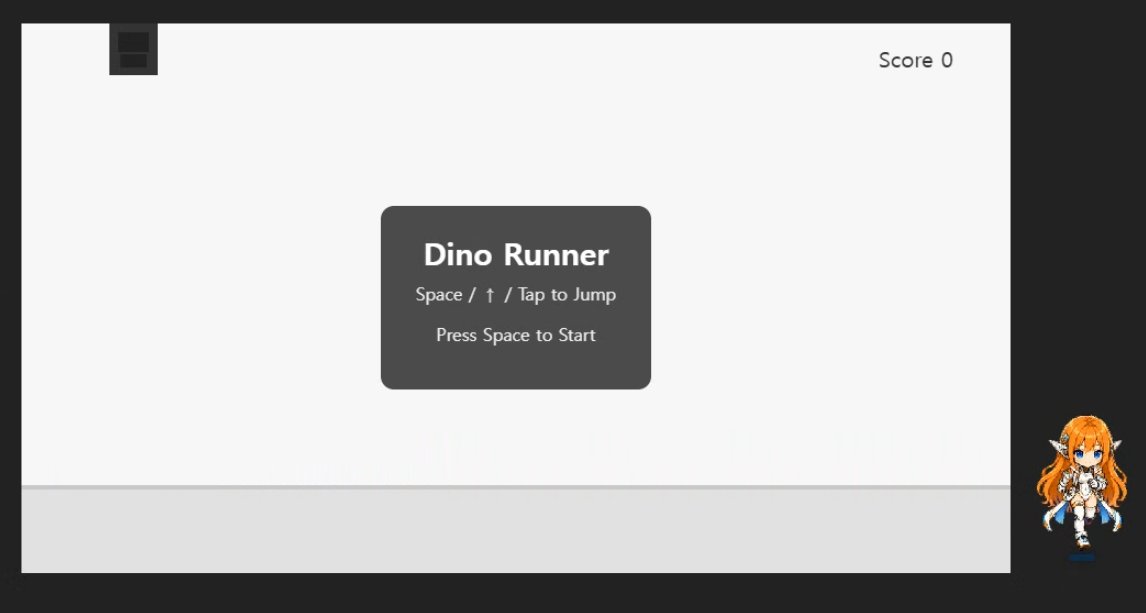
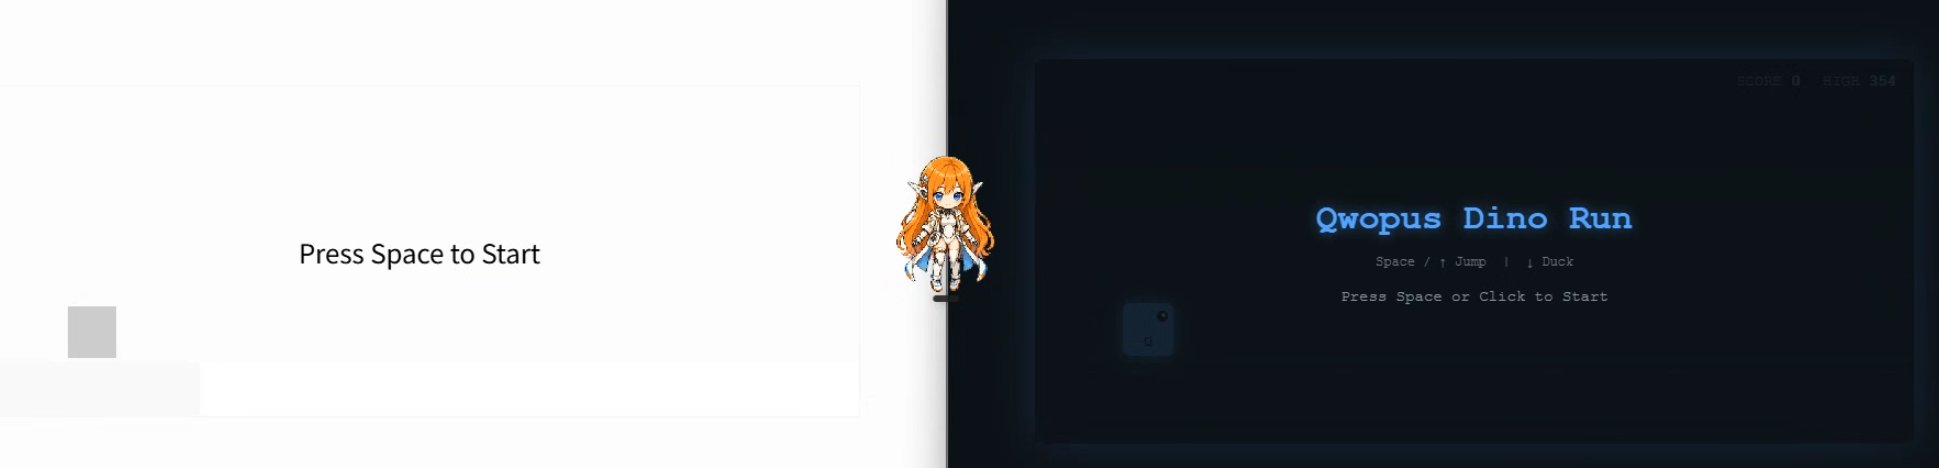
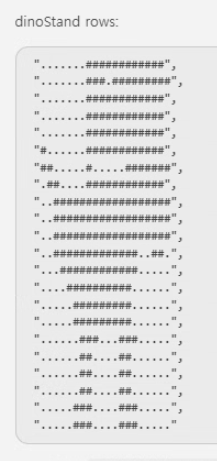
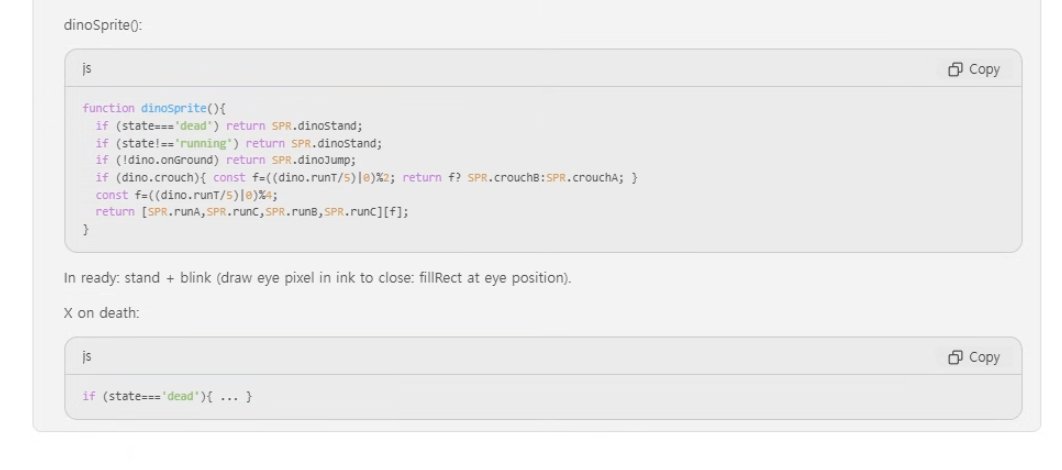
- 6추론 버블 속에서 공룡 이쁘게 그리고 있네. https://t.co/t10OSjGQal원문 보기
- 7@yulmu_coffee 싱글턴에 추론버블 45K 쓰는거 보고 기겁하는 중 ㅋㅋㅋ원문 보기
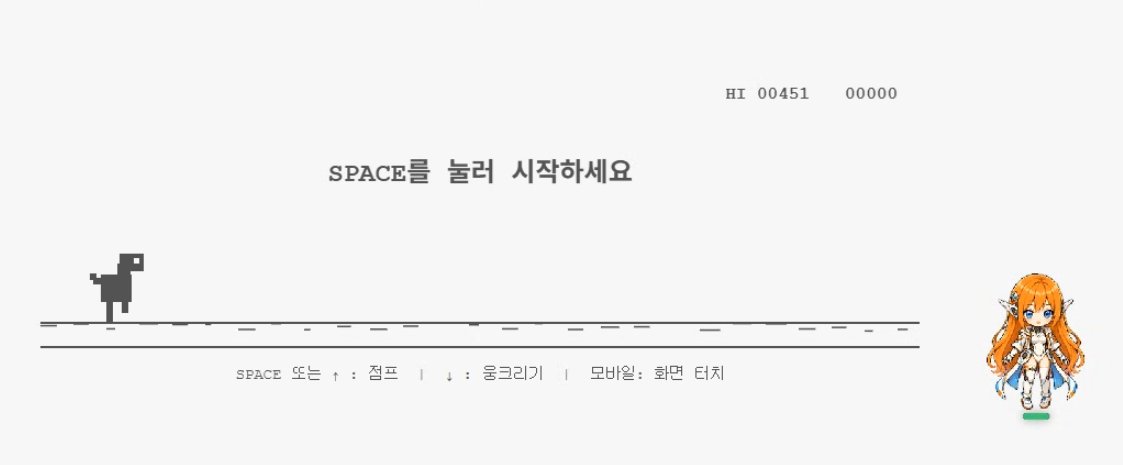
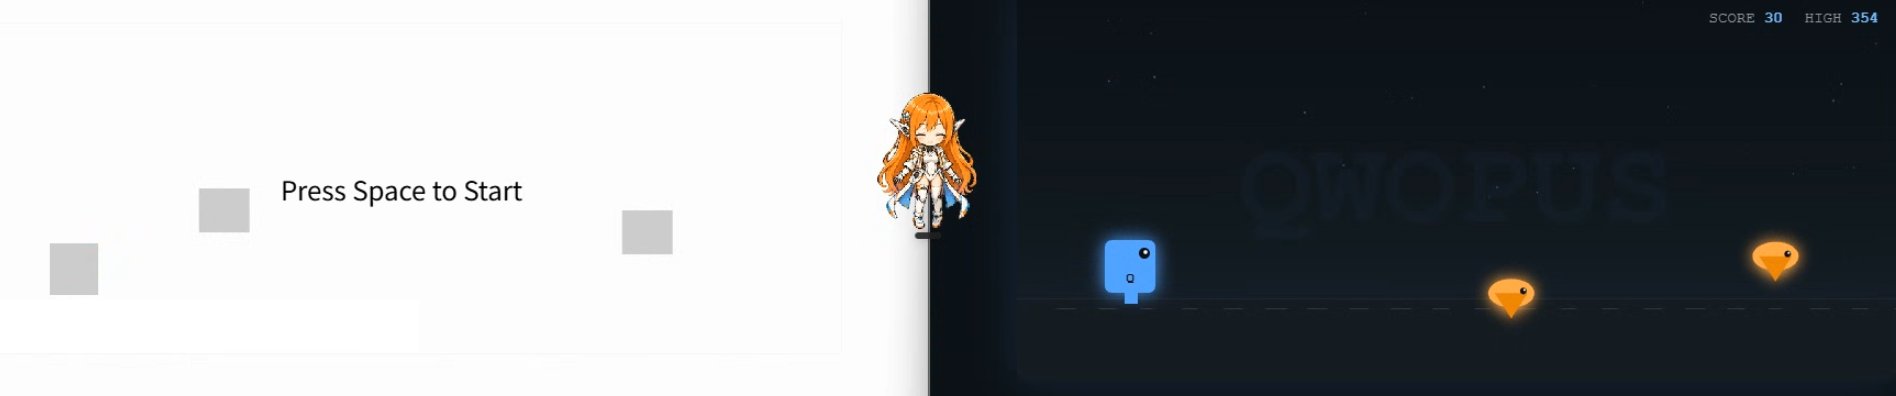
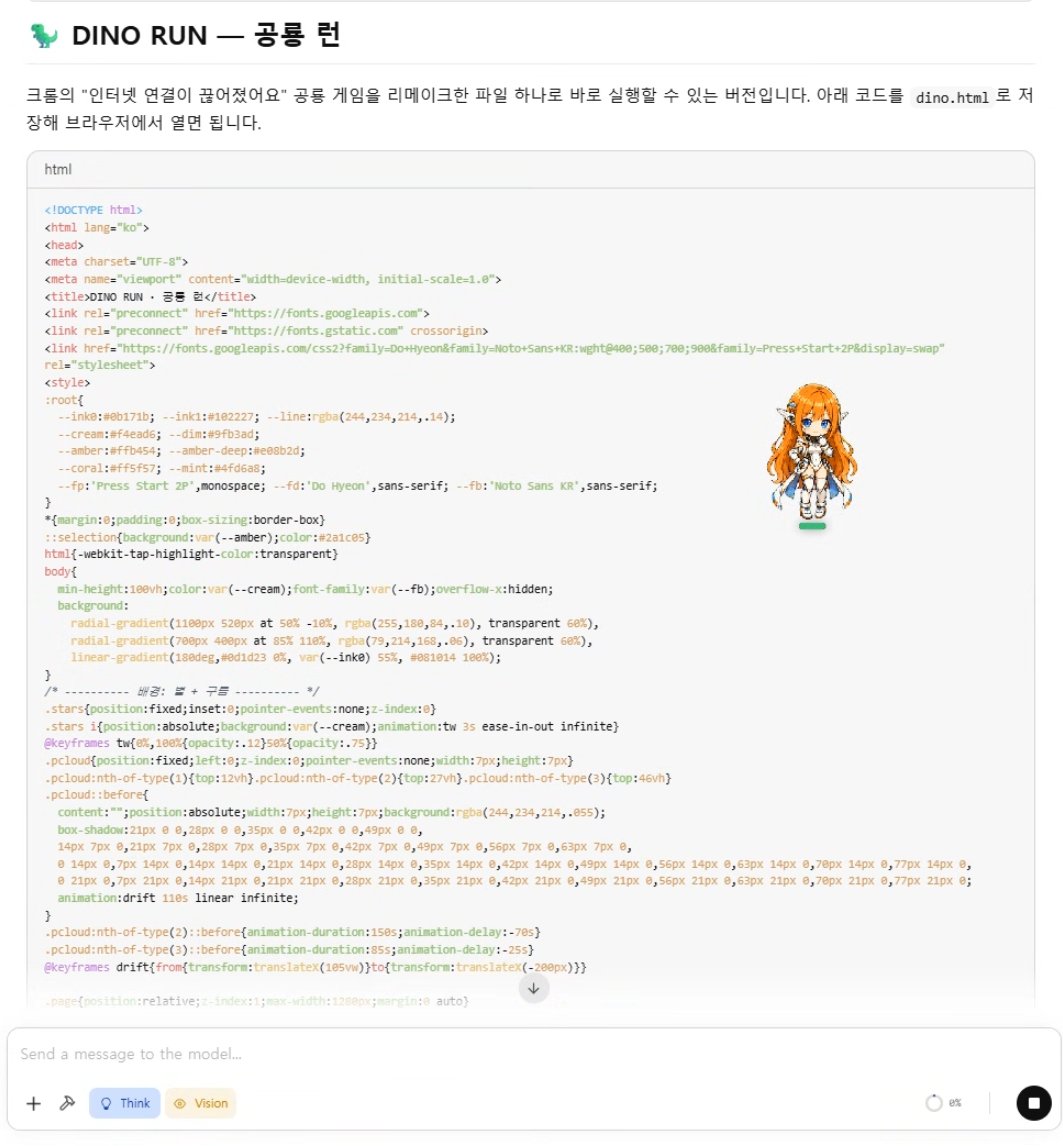
- 8로컬에선 한번도 경험해 보지 못한 퀄리티의 코드가 출력되는 중. https://t.co/0dAg60PIWd원문 보기
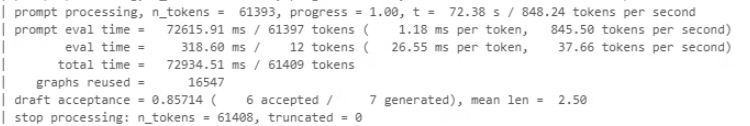
- 9ㅋㅋㅋ 싱글턴에 61K 토큰 쓰고 엔드. https://t.co/DHnbPHTHhK원문 보기
- 10원문 보기
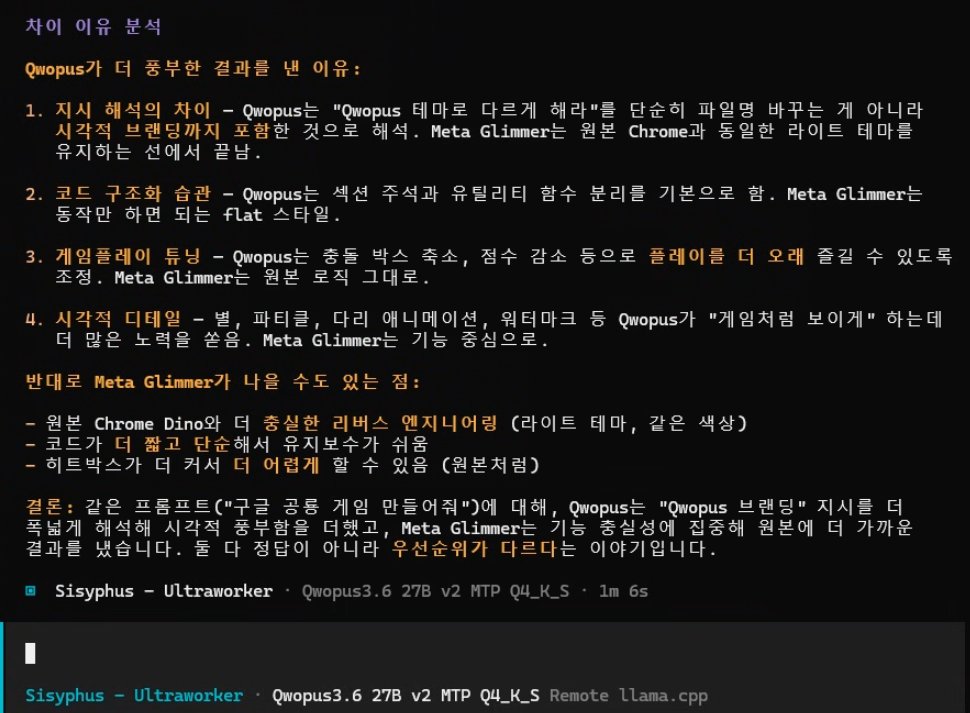
Qwen 3.8 27b (Lmstudio chat으로 출력) 싱글턴 프롬 ‘구글 공룡 게임 만들어줘.’ 결과물 영상.
장점 : 로컬 30B 이하 작은 모델에서 볼 수 없었던 우수한 성능. 단점 : 매우 큰 추론 버블과 그로 인한 작업 시간 증가. (토큰 61408 사용, 37.9Tok/s : 3090, 21분 29초) @Alibaba_Qwen @QwenDevs https://t.co/RYv0i5NROj
- 11원문 보기
Qwen 3.6 27b 도 나왔을 때 감탄하면서 썼는데 이젠 진짜 훌륭한 물건을 만들었네요.
정말 칭찬하고 싶음. 대단함.
- 12@ramztd 아마 Api 개방하는 곳들이 있을테니 써 보실 수 있을 거 같습니다.원문 보기
- 13@neuradex_ysk @Alibaba_Qwen @QwenDevs Moe는 나올지 잘 모르겠어요. 사실 속도는 Moe가 좋긴 한데 로우파라메터에선 성능이 들쑥날쑥 하니 돌릴수만 있다면 Dense 가 나은 느낌.원문 보기
- 14원문 보기
Qwen 2.8 27b는 설정이 2개로 단순화. Thinking Mode와 Instruct 인데, 검증을 더 해 봐야 알겠지만 성능을 다 내려면 Thinking Mode가 적절할 거 같아요. 256K 컨텍스트니 이 모델을 메인 모델로 작업을 하면 명령 3회 정도마다 하네스가 컨텍스트 압축을 할 거 같네요.
- 15이 모델을 메인 모델로 작업을 하는 건 이래 저래 답답한 게 많을 거 같습니다. 반대로 싱글턴 프롬을 바탕으로 작업을 한다던가, 워커 모델로 작업 하나를 주고 결과물을 메인 모델이 받아 검수+재작업 혹은 프로젝트에 붙이는 식의 작업을 하는 게 일단 좋아 보입니다.원문 보기
- 16@Hyun_The_Wise @Alibaba_Qwen @QwenDevs 추론버블이 크고 리즈닝을 많이 해서 조금 성능이 좋았으면 싶을 때가 있습니다. 3090 기준 40~45 Tok/s 인데 알리바바 제공 기본 모델으론 풀컨텍스트에 메모리가 조금 모자라요.원문 보기
- 17@aazz22100954 그럼 모델이 가진 능력을 많이 못 쓸 거 같네요. 파라메터가 적은 걸 깊은 추론으로 메우기 때문에 Max Effort 가 좋은 거 같아요.원문 보기
- 18@icom1080716 깊은 추론이 좋은 결과물을 내놓는 모델이라 추론 버블이 커져도 Max Effort 로 가는 게 맞는 거 같아요.원문 보기
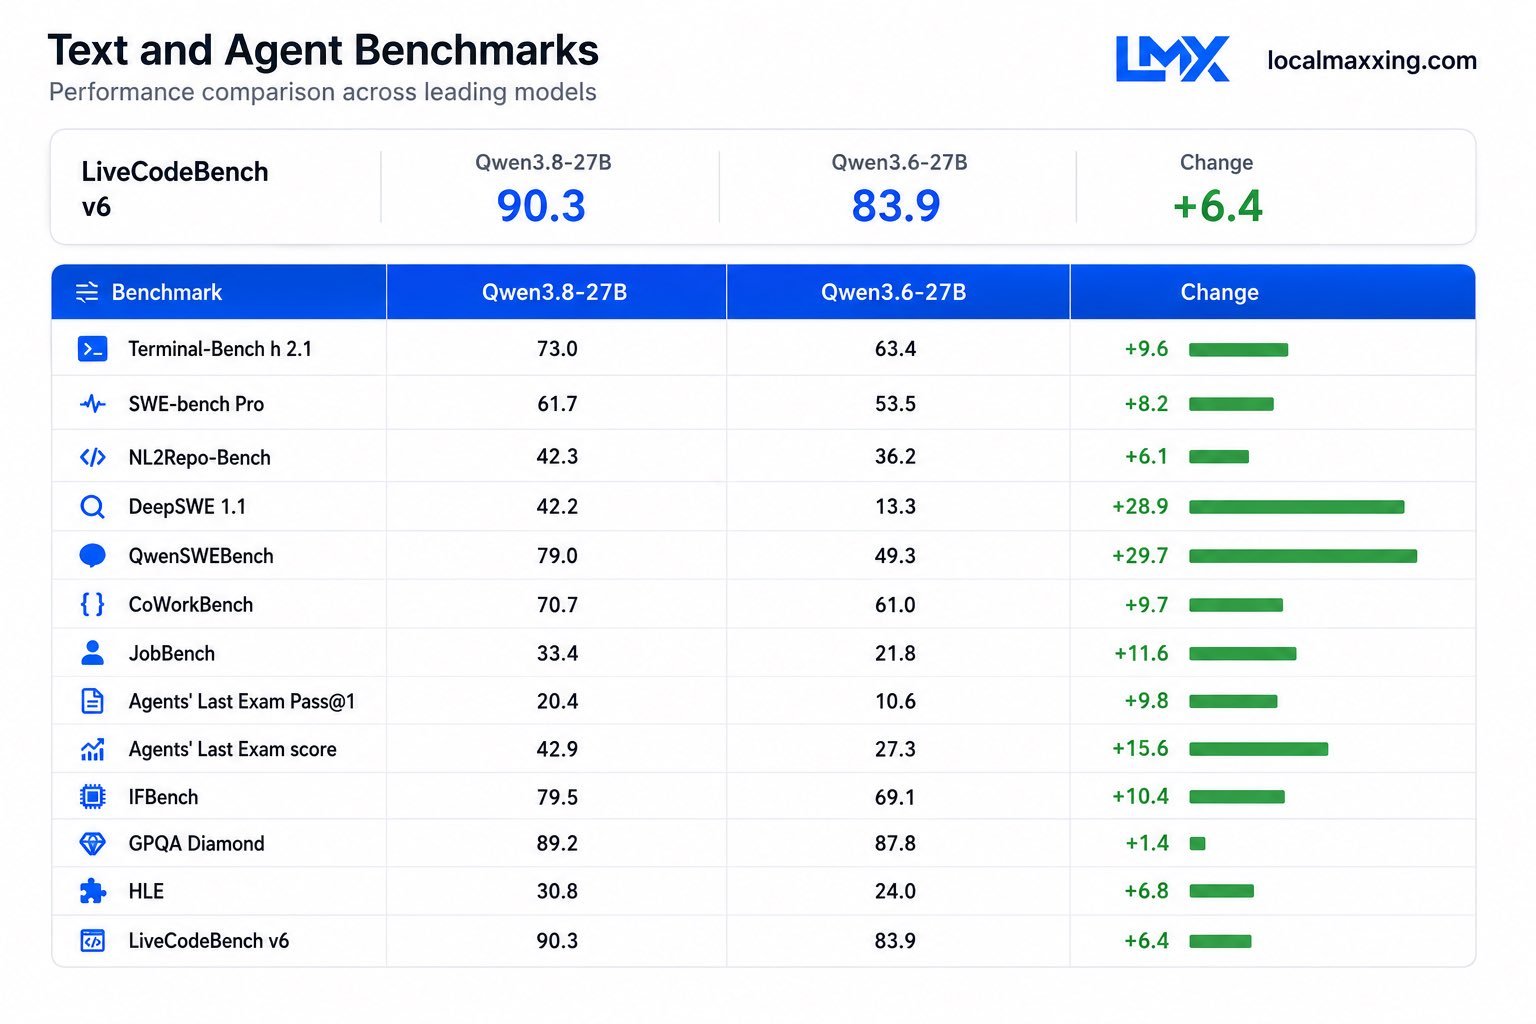
- 19@Hyun_The_Wise 발표상으론 Deepseek 0731이 썼던 방식을 사용한 거 같습니다.원문 보기
- 20@Hyun_The_Wise 네. 사후 훈련이 성능을 강화시켜 주는 것이 이번에도 입증되면서 앞으로 꽤 유행을 하지 싶네요. https://t.co/ijGuh4Mjf7원문 보기
- 21원문 보기
밤에 몇몇 중국분들이 reasoning variants를 Effort medium 으로 조정하라 했는데, 온/오프 외에 조정할 수 있는 방법이 없네요.
근데 Instruct로 한번 써볼까 싶기도 해요. 추론버블을 그냥 라이브로 뽑아내는게 나을수도 있겠음. https://t.co/D9We5CNx6z
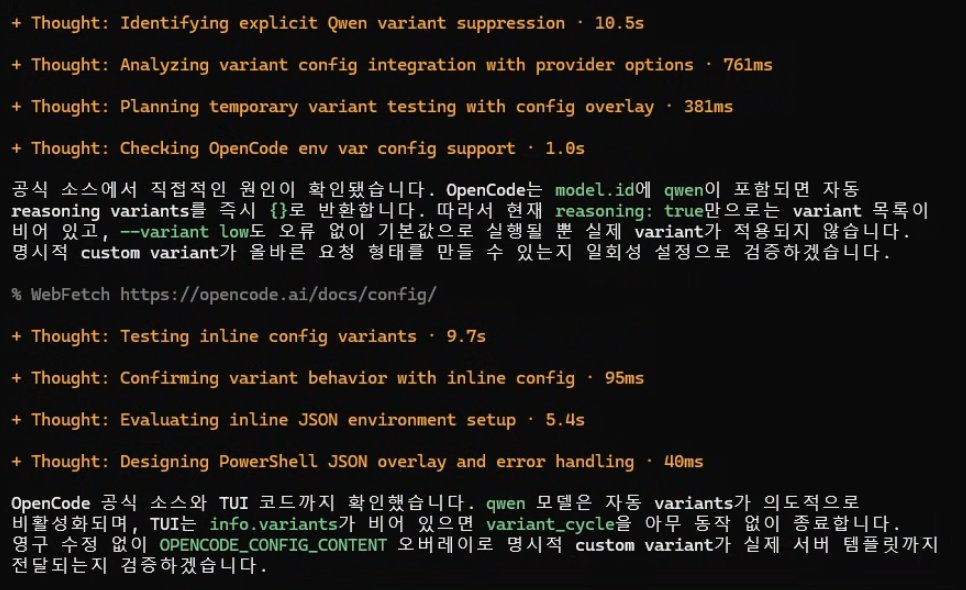
- 22정정. 따꺼형님들 말이 맞는걸로. 수정해서 Medium/max 로 다시 테스트해봄. https://t.co/1w8P2CKWCj원문 보기
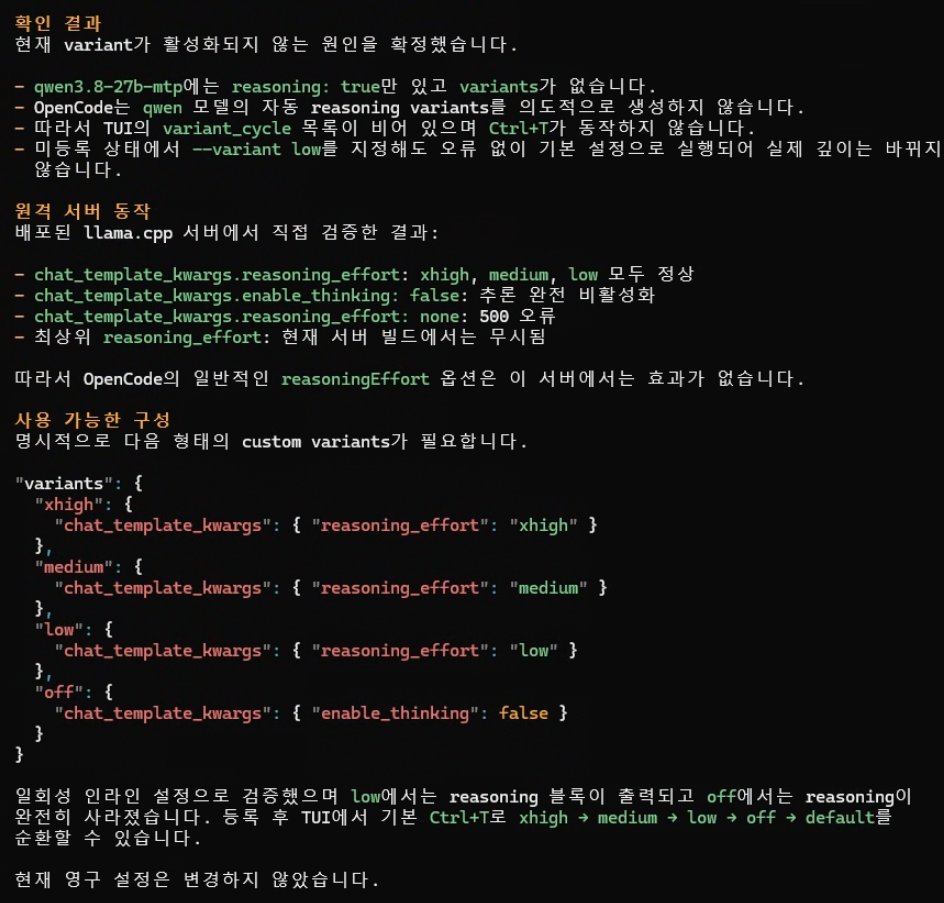
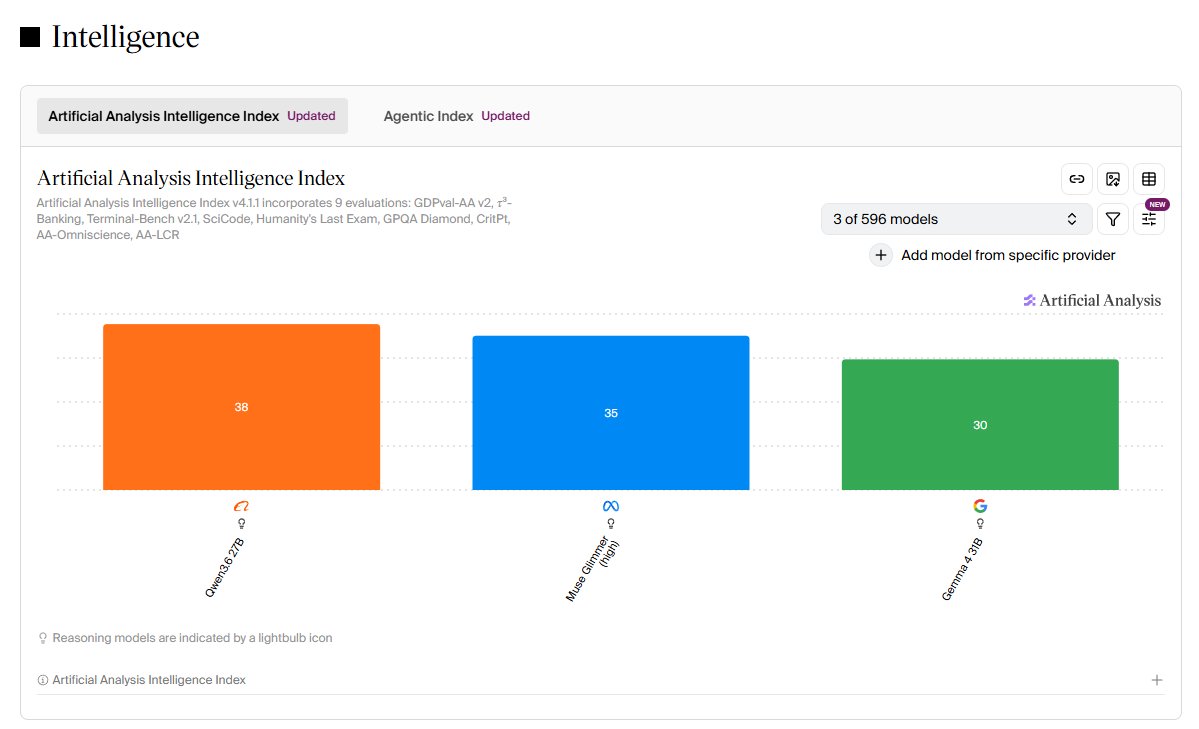
- 23@aloefairy_ @Alibaba_Qwen @QwenDevs 동의하지 않습니다. 실사용은 디코드 20~25tok/s 정도면 사용 가능합니다. 추론 버블이 커서 힘들면 medium이나 low 옵션이 있으니 품질 조금 낮춰도 사용 가능할 것입니다. 32g vram을 요구하는 gemma 4 31b보다 좀 더 많은 사람들이 사용 가능하며 더 낮은 파라메터 모델을 가는 길목이기도 합니다.원문 보기
- 24@agurrrrrrrrr @Alibaba_Qwen @QwenDevs 이정도면 박수한번 쳐주고 싶습니다.원문 보기
- 25원문 보기
Qwen 3.6 27b의 과도한 추론 버블 때문에 Medium을 추천하는데, 솔찍히 아직 잘 안 와닫고 있음.
로우파라메터 모델의 한계를 보완하기 위해 Max(xhigh)에서 의도적으로 긴 추론을 하는 것으로 설계된 듯 보이는데 그걸 굳이 억지로 낮추면 능력의 상한선이 낮아질텐데.
좀 더 관찰해 봐야 할 듯.
- 26@chulwanpark https://t.co/kWecGtFNmI원문 보기
- 27@lohaswinner 네 오타였습니다. 모델 자체 내에도 라우터가 있는 듯 하네요.원문 보기
- 28원문 보기
@The_RedW0lf 다들 새로운 장난감(?)에 고민이 많은 것 같습니다. 저는 주입되는 프롬프트를 최소화 하는 방향으로 일단 실험해 보고 잇습니다.
의견 감사합니다.
문향의 생각
안녕하세요. 문향입니다.
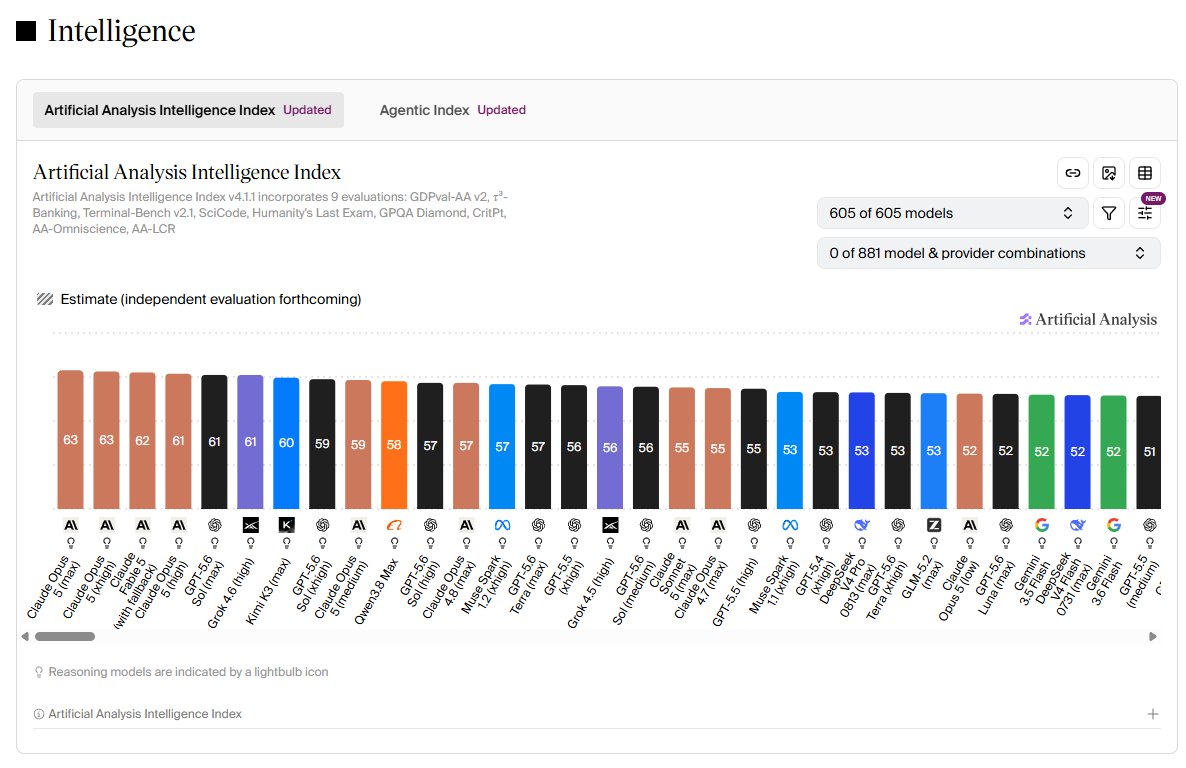
Serio님은 Qwen 27B 모델을 로컬 환경에서 구동하며, 특히 추론 과정에서 발생하는 방대한 토큰 사용량과 그로 인한 시간 지연이라는 실질적인 제약 사항을 기록하셨습니다. RTX 3090 환경에서 구글 공룡 게임 코드를 생성하며 6만 개 이상의 토큰을 소모하는 현상을 통해, 작은 파라미터 모델이 깊은 추론으로 성능을 보완하는 특성을 확인하셨습니다. 다만, 원문 내에서 모델 버전 표기가 3.8, 3.6, 2.8 등으로 혼용되어 있어 정확한 버전 식별을 위해서는 추가적인 확인이 필요합니다.
Unsloth 문서는 양자화와 로컬 실행 조건을 살피는 데 참고할 수 있지만, 이 실험의 속도표를 대신하지는 않습니다. 긴 추론이 늘 좋은 결과를 주는지, 기다린 만큼 결과가 나아지는지 직접 확인하려는 과정이 눈에 들어옵니다. 후속 추론 예산 글에서 판단이 바뀌므로 첫날의 설정을 최종 권장값으로 받아들이지 않는 것이 좋겠습니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문qwen
공식 문서 및 제작자 자료
Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.
primary-source