Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
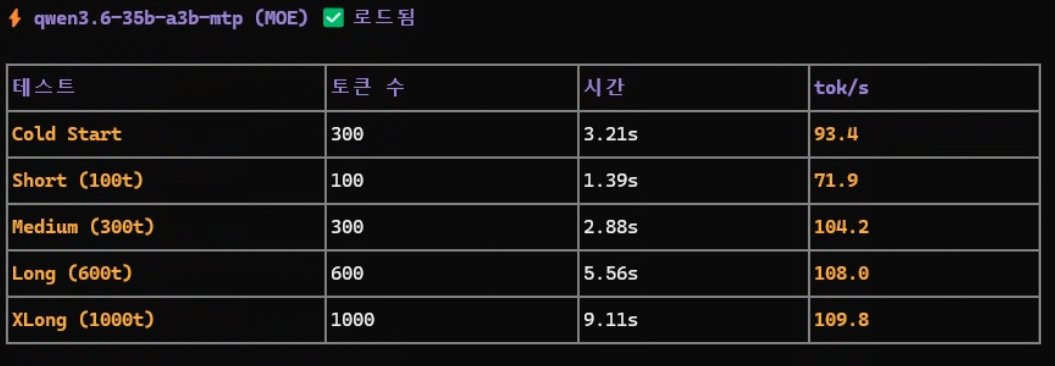
    qwen 3.6 35B 는 MTP 까지 올리니 속도감만은 정말 신나네. https://t.co/gtVhkmio1c
    원문 보기
  2. 2
    드리프트랑 메모리 설정까지 다시 해주니 속도감만큼은 지전. https://t.co/nvwptM2zNr
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.6 35B 모델에 MTP(Multi-Token Prediction) 설정을 적용하고 드리프트 및 메모리 최적화를 거치며 체감 속도가 크게 향상되었다고 기록하셨습니다. 다만, 이러한 속도 향상이 구체적으로 어느 정도의 수치로 나타났는지, 혹은 특정 하드웨어 환경에서만 유효한 결과인지에 대해서는 공식 자료를 통해 직접적으로 확인되지 않습니다. 따라서 해당 주장은 현재로서는 개인의 운용 경험에 기반한 기록으로 보이며, 객관적인 성능 지표로서의 검증은 추가적인 확인이 필요합니다.

로컬 LLM 운용 과정에서 메모리 설정과 최적화 값의 조정이 추론 속도에 영향을 미치는 것은 일반적인 사실입니다. 하지만 MTP 적용이 실제 출력 속도에 미치는 영향과 드리프트 설정의 상관관계는 모델의 버전과 실행 환경에 따라 변동성이 매우 큽니다. 공식 저장소의 기술 문서만으로는 Serio님이 언급한 '신나는 속도감'의 실체를 명확히 규명하기 어려우므로, 재현 가능성을 확인하기 위한 상세 설정값의 공유가 선행되어야 할 것으로 보입니다.

실험 맥락운용 관찰재현 포인트
THREAD ESSAYX THREAD ARCHIVE

Lmstudio 에 Qwen 3.6 mtp 빌드가 업데이트 되서 써보는 중.

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Lmstudio 에 Qwen 3.6 mtp 빌드가 업데이트 되서 써보는 중.

    마음같아선 llama.cpp 직접 빌드해서 바로 써보고 싶지만

    분신술 쓰고싶다. https://t.co/1kgA6GPA8r

    원문 보기
  2. 2

    확실히 속도가 붙긴 했네요.

    이전에는 디코딩 23~5T/s 라면 지금은 35T/s까진 나오네요. 스타팅에선 40T/S 도 넘기니 이정도면 실사용으로 쓸만한 속도가 나옵니다.

    다만 테스트로 쓰는 일본어 번역에선 리즈닝까지 끄니 기존보다 바로 일본어 텍스트를 뱉어버리는 비율이 높아지네요. 허허. https://t.co/YMZGsSvK5A

    원문 보기
  3. 3
    반대로 듀얼 그래픽카드 상태에선 MTP 가 애매해지네요. 물론 성능이 향상되긴 하는데, 싱글 카드보단 낮아지는게 역시 대역폭 지속 사용으로 인한 손실이 꽤 있는듯. https://t.co/OCM8gw4D6D
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

LM Studio를 통해 Qwen 3.6 MTP 빌드를 사용하며 체감 속도가 향상되었다는 Serio님의 기록입니다. 디코딩 속도가 기존 23~25T/s에서 최대 40T/s까지 상승했다는 구체적인 수치를 제시하며 실사용 가능한 수준에 도달했다고 평가했습니다. 다만, 리즈닝 기능을 껐을 때 일본어 번역 결과물이 즉각적으로 출력되는 경향이 강해졌다는 점은 개인의 테스트 경험으로 보이며, 이는 모델의 추론 과정 변화에 따른 결과인지에 대해 추가적인 확인이 필요합니다.

하드웨어 구성에 따른 성능 변화 부분은 기술적 검토가 더 필요해 보입니다. 듀얼 그래픽카드 환경에서 MTP 적용 시 성능 향상은 있으나 싱글 카드보다 효율이 낮아지는 현상을 대역폭 손실로 분석하셨는데, 이는 공식 문서로 검증된 사실이라기보다 사용자 환경에 기반한 추론에 가깝습니다. 전반적으로 이번 업데이트가 속도 면에서는 유의미한 개선을 가져왔으나, 다중 GPU 환경에서의 최적화 문제는 여전히 해결해야 할 과제로 남은 것으로 보입니다.

실험 맥락운용 관찰재현 포인트

THREAD ESSAYX THREAD ARCHIVE

난 Gemini 3.5 의 지식컷오프 2025.1월을 존중함.

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    난 Gemini 3.5 의 지식컷오프 2025.1월을 존중함.

    2025년 이후로 인터넷엔 AI 글/컨텐츠가 범람했고 이로 인한 AI 컨텐츠 재생성 > 데이터 열화가 판을 치기 시작했음.

    즉 구글은 인간이 만들어 낸 자체 데이터셋의 정제와 증류를 하고 있다는 말이 됨.

    그게 좋은 모델을 만들어 내는 건 둘째치고.

    원문 보기
  2. 2

    그래서 기초 모델 학습에는 오히려

    • 잘 만들어진
    • 사람이 만들어낸
    • 꼼꼼히 정제한

    데이터셋으로 학습과 증류를 진행하는 게 맞다고 생각함. 클로드의 파나마 프로젝트는 그런 데이터 정제의 결정판임. 그래서 클로드가 진보 문학소녀(?)가 되버린거고.

    원문 보기
  3. 3

    앞으로 구글의 할 일은 그렇게 학습된 모델이 데이터컷 이후 현실의 세계를 다시 인식하고 활동할 수 있는 중간다리를 만드는 일이라고 봄. 그리고 곧 할 수 있을 것이라고 판단함.

    다만, 문어발처럼 마구잡이로 상품을 늘리는 건 좀 자제해 줬으면 좋겠음.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Gemini 3.5의 지식 컷오프 시점을 근거로 AI 생성 콘텐츠로 인한 데이터 열화 가능성과 구글의 데이터 정제 전략을 분석하셨습니다. 다만, 구글이 의도적으로 인간 데이터셋만을 정제하여 증류하고 있다는 주장이나 클로드의 특정 프로젝트가 '진보 문학소녀' 같은 성향을 만들었다는 분석은 공식 자료로 입증된 사실이라기보다 개인의 해석에 가깝습니다. 특히 파나마 프로젝트의 구체적인 영향력과 모델의 성향 사이의 상관관계는 현재로서는 확인이 필요한 영역입니다.

향후 구글이 데이터 컷 이후의 현실 세계를 인식하는 중간다리를 구축할 것이라는 전망 역시 구체적인 기술적 근거가 부족한 추정의 단계입니다. 그럼에도 불구하고 무분별한 상품 확장을 경계해야 한다는 지적은 시장의 효율성 측면에서 유의미한 통찰이라고 생각합니다. 결국 모델의 성능 향상은 양적인 데이터 확장이 아니라, 정교하게 정제된 고품질 데이터의 확보와 이를 현실 세계에 연결하는 정밀한 인터페이스 구현에 달려 있습니다.

원문 해석확인 필요

THREAD ESSAYX THREAD ARCHIVE

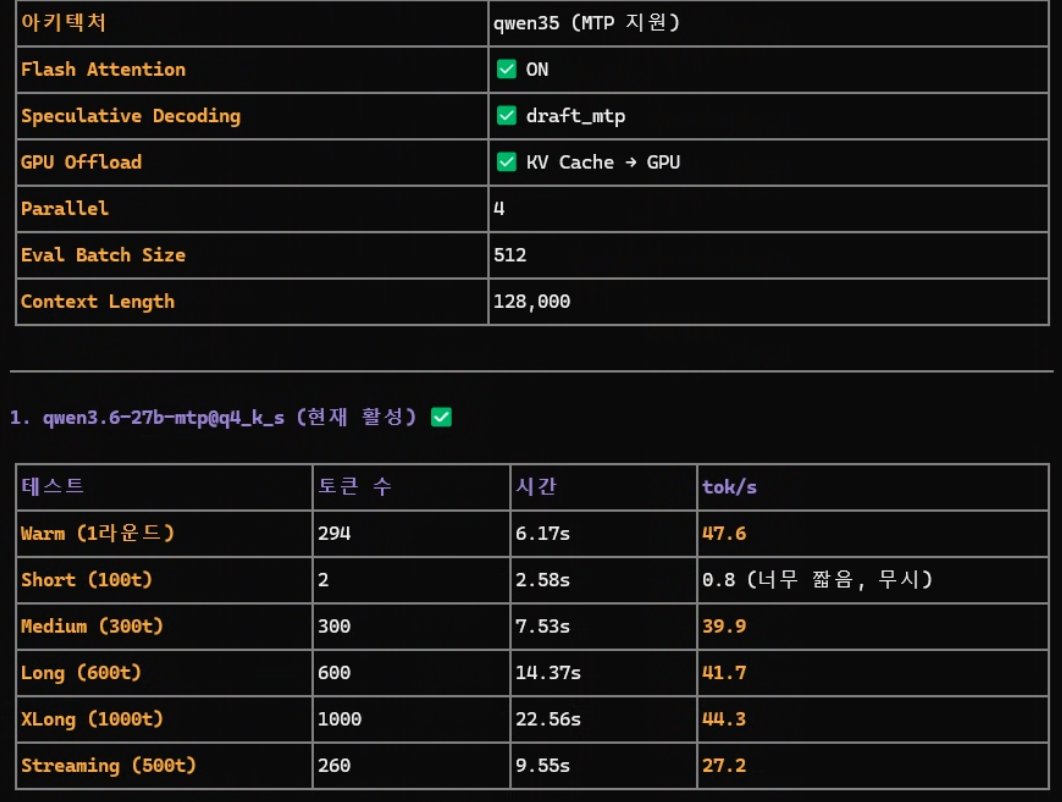
이정도면 속도만큼은 정말 실사용 영역이네.

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2057411222828716538

2026-05-21

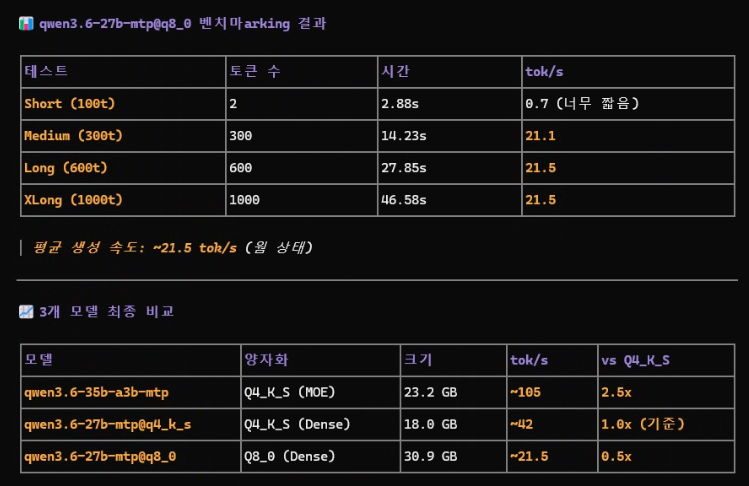
이정도면 속도만큼은 정말 실사용 영역이네.

Qwen 3.6 27b + Lmstudio + opencode https://t.co/2cXVYHxFX0

원문 보기

tweet media

Qwen 3.6 35b + Lmstudio + opencode https://t.co/zaU5PzFtOg https://t.co/DkFz1ChXI7

원문 보기

tweet media

최종 3종.

다만, 컨텍스트 크기 늘어나는 거에 비교해서 프리필 시간이 길어지기 때문에 어떤 작업에 어떻게 쓰느냐는 고민해 볼 필요는 있음.

오케스트레이션 에이전트가 있고, 작업 영역으로 짧은 컨텍스트의 작업을 태워 보내는 작업은 분명히 MTP가 강점이 있으리라 판단함. https://t.co/4M2Sz1BkSl

원문 보기

tweet media

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.6 모델과 LM Studio, OpenCode의 조합을 통해 로컬 LLM의 추론 속도가 실사용 가능한 수준에 도달했다고 주장합니다. 특히 MTP(Multi-Token Prediction) 기술이 짧은 컨텍스트 작업에서 강점을 보일 것이라는 분석을 덧붙였습니다. 다만, 컨텍스트 크기 증가에 따른 프리필(pre-fill) 시간의 지연 문제는 사용자가 직접 고민해야 할 지점으로 지적하며 기술적 한계를 함께 언급했습니다.

하지만 제시된 속도 향상 수치나 실사용 가능 여부는 개인의 하드웨어 환경에 따라 달라지는 주관적 경험치이며, 이를 뒷받침할 객관적인 벤치마크 데이터는 원문에서 확인되지 않습니다. MTP의 효율성에 관한 판단 역시 특정 작업 영역으로 한정한 개인의 추론일 뿐, 공식 문서나 기술 자료를 통해 검증된 보편적 사실로 보기에는 근거가 약합니다. 따라서 해당 주장은 실제 구현 환경에 따른 개별적 사례로 이해해야 하며, 일반적인 성능 지표로서의 가치는 추가적인 확인이 필요합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

Qwen 3.6 의 리즈닝을 강제 해제시키는 법.

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2057370553091297399

2026-05-21

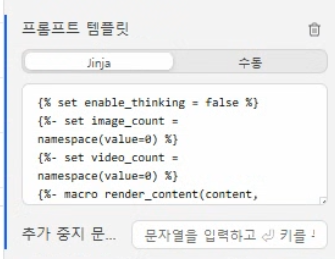
Qwen 3.6 의 리즈닝을 강제 해제시키는 법.

(사실 리즈닝 타레가 너무 사소한 질문에도 과도하긴 해.)

{% set enable_thinking = false %}

를 프롬프트 탬플릿 제일 위에 집어넣을 것. https://t.co/xIi21R2D3J

원문 보기

tweet media

그리고 언슬로스 기본 권장사항

https://t.co/4mhfzpGB3K

--temp 0.7 \

--top-p 0.8 \

--top-k 20 \

--presence-penalty 1.5 \

--min-p 0.00 \

--spec-type draft-mtp --spec-draft-n-max 2 \

--chat-template-kwargs '{"enable_thinking":false}'

원문 보기

와 Q8 의 경우 기존에는 가능했던 192K 가 48G Vram 풀오프로딩 불가능이다.

그냥 160K 로 해야할듯. https://t.co/fCjgqUzzIl

원문 보기

tweet media

문향의 생각

안녕하세요. 문향입니다.

Serio님이 제시한 Qwen 3.6의 리즈닝 강제 해제 방법 중, 프롬프트 템플릿 수정과 언슬로스(Unsloth) 권장 설정값 및 VRAM 오프로딩 제한에 관한 내용은 기술적 구현 가능성이 있는 구체적인 수치와 설정법을 담고 있습니다. 다만, 리즈닝 과정이 사소한 질문에도 과도하다는 인식은 사용자의 주관적 경험에 기반한 판단이며, 제시된 설정값이 모든 환경에서 동일한 효과를 낸다는 점은 공식 자료로 완전히 검증되지 않았기에 확인이 필요합니다.

특히 Q8 양자화 모델의 컨텍스트 윈도우가 192K에서 160K로 제한된다는 주장은 특정 하드웨어 환경에 국한된 결과일 가능성이 큽니다. 이는 일반적인 모델의 사양이라기보다 개별 시스템의 메모리 한계로 인한 현상으로 보이며, 보편적인 사실로 받아들이기에는 근거가 부족합니다. 따라서 해당 설정들을 적용하기 전, 자신의 시스템 환경과 공식 저장소의 최신 업데이트 내역을 대조해 보실 것을 권합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

아 개웃긴다. 🐕

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    아 개웃긴다. 🐕

    Antigravity 그래 실력 한 번 보자. 해서

    “UI 한글패치 만들어라. 적용해봐라 하니까”

    100% 적용 가능합니다! 해놓고 에러 나서 Codex 로 구조중.

    ㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋ https://t.co/bkhZD1jBcr

    원문 보기
  2. 2

    Codex 5.5 는 설치된 안티그래비티가 새벽에 새로 나온 Antigravity 2.0 을 바로 알아채서 작업을 하는데 Antigravity 는 자기가 2.0 인줄 모른다.

    여기서 게임 셋 아닌가?

    구글은 이따위로 할꺼면 IDE 짐 싸라. 커서랑 Kimi가 당신들보다 잘 하지 싶다. https://t.co/xiQ8wjnU1R

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Antigravity의 UI 한글 패치 적용 실패와 버전 인식 오류를 언급하며 구글의 IDE 경쟁력 저하를 주장하셨습니다. Codex 5.5가 최신 버전인 Antigravity 2.0을 즉각 인지하여 작업을 수행했다는 점은 기술적 특이점으로 보이나, 정작 Antigravity 본체는 이를 인지하지 못했다는 구체적인 정황은 제공된 1차 자료만으로는 사실 여부를 확정하기 어렵습니다. 특히 특정 모델의 성능 부족을 근거로 구글의 IDE 시장 퇴출을 논하는 부분은 개인의 주관적 평가가 강하게 투영된 영역입니다.

결과적으로 Antigravity의 동작 오류와 버전 인식 문제는 개별 사례로서의 '확인 필요' 단계이며, 이를 기반으로 커서(Cursor)나 Kimi와의 우위를 단정 짓는 논지는 근거가 다소 약합니다. 다만, AI 에이전트 간의 정보 동기화 속도 차이가 사용자 경험에 직접적인 영향을 준다는 점은 시사하는 바가 큽니다. 기술적 결함이 시장의 패권 교체로 이어진다는 주장이 성립하려면, 단순한 에러 사례를 넘어선 구조적인 성능 지표의 비교 분석이 선행되어야 할 것입니다.

원문 해석확인 필요

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
    ㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋㅋ 수고하셨습니다 안티그래비티 그리고 구글. https://t.co/kjpSu7mrde
    원문 보기
  2. 2
    Antigravity 1시간 소감 https://t.co/2WaK00IB4X
    원문 보기
  3. 3

    빠르다고 다가 아님. 외형이 세련된 게 다가 아님

    • 권한을 바로 통제할 수 있는가?
    • 판단과 작업을 신뢰할 수 있는가?

    아무리 판단을 깊고 빠르게 한다 한들 틀린 지식에 고집이 쎄면 쓸 수 없음. Gemini 2.5, 3에서도 틀린 지식에 꽂히는 순간 몇번을 지적해도 모델은 계속 환각에 빠져들어갔음.

    원문 보기
  4. 4
    권한 설정을 물어보는데도, 한글 패치 설정 방법을 물어보는데도 빠른 대답에 매몰되어 제대로 확인도 안하고 구버전 세팅 정보를 던지는 모델을 유저가 신뢰하고 작업을 맏길 수 있을 거라고 생각함? 첫 사용자 경험이 이럴진데 ‘우리 애는 조금 설명하면 빠르게 잘 해요’ 라고 믿고 할 수 있겠음?
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 구글의 제미나이(Gemini) 최신 모델들이 빠른 속도와 세련된 외형에도 불구하고, 환각 현상과 잘못된 정보 고집이라는 치명적인 신뢰성 문제를 안고 있다고 주장합니다. 특히 권한 설정이나 한글 패치 방법 등 구체적인 세팅 정보에서 구버전 데이터를 제공하는 등 사용자 경험이 저하되었다는 점을 지적하며, 속도보다 정확한 판단과 통제 가능성이 우선되어야 함을 강조합니다.

다만, 제시된 Codex 1차 자료 검토 브리프를 보면 해당 주장들의 검증 결과가 '부분적(partial)'으로 나타나며, 구체적인 오류 사례가 공식 문서로 입증되었는지는 확인이 필요합니다. 개별 사용자의 경험적 사례는 구체적이나, 이를 모델 전체의 일반적인 결함으로 확정 짓기에는 근거가 부족하므로 추가적인 기술 검증이 수반되어야 할 것입니다. 결국 기술적 완성도는 단순한 응답 속도가 아니라 정보의 정확성과 신뢰도에서 결정된다는 논지는 타당합니다.

원문 해석확인 필요

THREAD ESSAYX THREAD ARCHIVE

X post 2056819399122919430

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1원문 보기
  2. 2

    근데 안티그래비티까지 리뉴얼해서 내놓은 거 치곤 코딩 성능이 여전히… 음… 흠.

    벤치만 보면 여전히 말하는 앵무새 이상의 역할을 할 수 없을 거 같은데. 앵무새 역할은 오히려 더 저렴하면서도 충실하게 잘 해낼 거 같지만.

    만들어놓은 AI 에이전트/봇들에 넣는 용도론 적합할듯.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 최근 리뉴얼된 안티그래비티의 코딩 성능이 기대에 미치지 못한다는 개인적인 견해를 밝히셨습니다. 특히 벤치마크 결과만으로는 단순 반복적인 답변을 내놓는 수준에 그칠 가능성이 크다고 보셨으며, 오히려 저렴한 비용으로 봇이나 에이전트에 활용하는 용도가 적합할 것이라는 분석을 덧붙이셨습니다. 다만, 해당 주장을 뒷받침할 구체적인 수치나 공식적인 성능 지표 등의 외부 자료는 현재 충분히 확인되지 않는 상태입니다.

따라서 이번 기록은 객관적인 제품 검증이라기보다 실제 운용 과정에서 느낀 주관적 경험과 해석에 가깝다고 판단됩니다. 코딩 성능의 한계나 앵무새와 같은 반응 방식에 대한 언급은 개별적인 사용 환경에 따른 체감일 수 있으므로, 일반적인 성능 확정으로 보기에는 근거가 부족하여 추가적인 확인이 필요합니다. 그럼에도 기술적 제약과 모델의 특성을 파악하려는 시도는 로컬 LLM 운용 기록으로서 유의미한 관찰이라 생각합니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    엔트로픽이 AI교육자 찾고 있었는데 그게 카파시 선생을 위한 자리였을 줄이야. 물론 선생 정도의 현인이면 선택에 이유가 있었으리라 생각하지만

    거길 왜 굳이?

    앞으로 더 많은 AI의 발전을 이끌 수 있을 보석같은 지식들이 커텐 너머로 사라질 것 같지만.

    그냥 뭐 아쉽게 된거지.

    원문 보기
  2. 2

    사실 AI의 발전을 위해 카파시 선생이 공개적으로 내놓은 많은 지식들을 우리들이 그저 포크해 쓰기만 바빴지, 그의 우수한 혜안에 대해서 우리들이 인정과 선망 외에 어떠한 기여를 했는지는 생각해 볼 필요가 있음.

    다만 그 선택이 지식의 제한과 독점을 원하는 엔트로픽인 것이 무척 아쉬울 따름.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

안드레이 카파시(Andrej Karpathy)가 엔트로픽의 사전 학습(pre-training) 팀에 합류했다는 사실은 본인의 X 게시물과 테크크런치(TechCrunch) 보도를 통해 명확히 확인됩니다[s-karpathy-x, s-techcrunch-karpathy]. 다만, 그의 합류가 곧바로 지식의 제한이나 독점으로 이어질 것이라는 Serio님의 우려는 구체적인 근거가 부족한 가치 판단의 영역입니다[s-x-original]. 엔트로픽이 폐쇄적인 운영 방식을 취하고 있는지는 맞으나, 카파시 개인의 지식 공유 활동이 중단될지는 아직 확인이 필요한 부분입니다.

그럼에도 불구하고 오픈소스 정신을 실천해온 교육자가 기업 내부로 들어갔을 때 발생할 '지식의 커튼' 현상은 충분히 논의될 가치가 있는 지점입니다. 단순히 인재 영입이라는 결과보다, 그가 가진 혜안이 공개적인 생태계가 아닌 기업의 이익을 위해 우선 소비될 가능성에 대한 아쉬움은 타당해 보입니다. 결국 이번 이동이 AI 발전의 가속화가 될지, 혹은 지식의 파편화가 될지는 향후 그가 보여줄 행보에 달려 있습니다.

원문 확인근거 분리판단 정리

팩트 체크 & 근거 자료

THREAD ESSAYX THREAD ARCHIVE

AI 사용이 무조건 좋다 틀림. 무조건 나쁘다도 틀림.

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    AI 사용이 무조건 좋다 틀림. 무조건 나쁘다도 틀림.

    사람은 편한 데로 변하기 마련. 더 나은 더 편한 거 추구하다가 혁신이 나왔고 그게 변화를 불러옴.

    그래서 AI 를 사용하되 가급적 전 과정을 지켜보는 게 좋음. 최소한 보고, 결과 확인, 책임 셋은 필요함.

    그것도 못 할거 같으면 쓰지 말고.

    원문 보기
  2. 2

    사실 아직도

    localhost:3000 npm run dev

    모루게쏘요 응애

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

AI의 효용성을 이분법적으로 나누지 않고, 사용자의 감시와 책임이라는 전제 조건을 강조한 Serio님의 관점은 타당합니다. 특히 결과 확인과 책임의 필요성은 UNESCO가 강조하는 인간 중심의 접근 방식(s-unesco-genai) 및 OWASP가 제시한 출력값 검증의 중요성(s-owasp-llm)과 궤를 같이하며, 이는 기술적 안전장치 없이는 AI 활용이 위험할 수 있다는 사실을 뒷받침합니다.

다만, 책임질 능력이 없다면 사용을 제한해야 한다는 결론은 개인의 선택 영역에 가깝기에 공식적인 표준으로 확정 짓기에는 근거가 다소 약합니다. 또한, 특정 개발 환경(localhost:3000 등)에 대한 이해도 부족이 AI 오남용으로 이어진다는 상관관계는 구체적인 데이터로 증명되지 않은 개인적 견해이므로 추가적인 확인이 필요합니다. 결국 AI의 가치는 도구 자체가 아니라 이를 통제하는 인간의 역량에 달려 있다는 점이 이 논평의 핵심입니다.

원문 확인근거 분리판단 정리

팩트 체크 & 근거 자료