THREAD ESSAYX THREAD ARCHIVE

오류가 반복되던 SD카드를 Codex로 분석한 경험

4개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
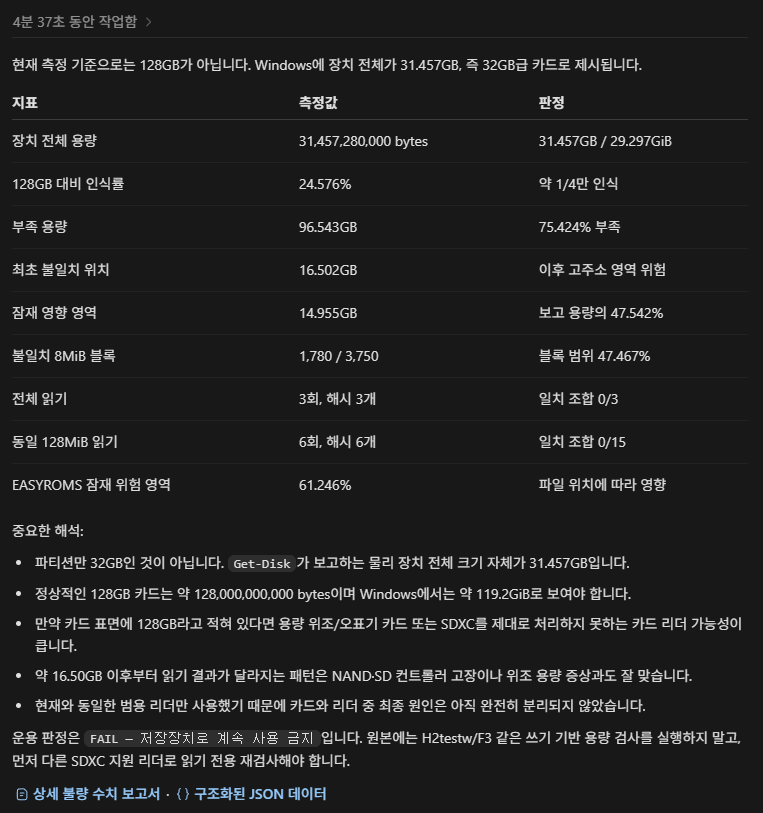
    알리에서 128G SD 카드 동봉 물건을 주문했는데, 백업하다가 계속 오류가 발생해서 Codex 한테 분석을 맡겼음. 용량 오표기+ 불량 SD 카드임을 발견하고 기술분석을 진행해 줌. https://t.co/yhcR0bFSDt 오류가 반복되던 SD카드를 Codex로 분석한 경험 — X 원문 첨부
    원문 보기
  2. 2
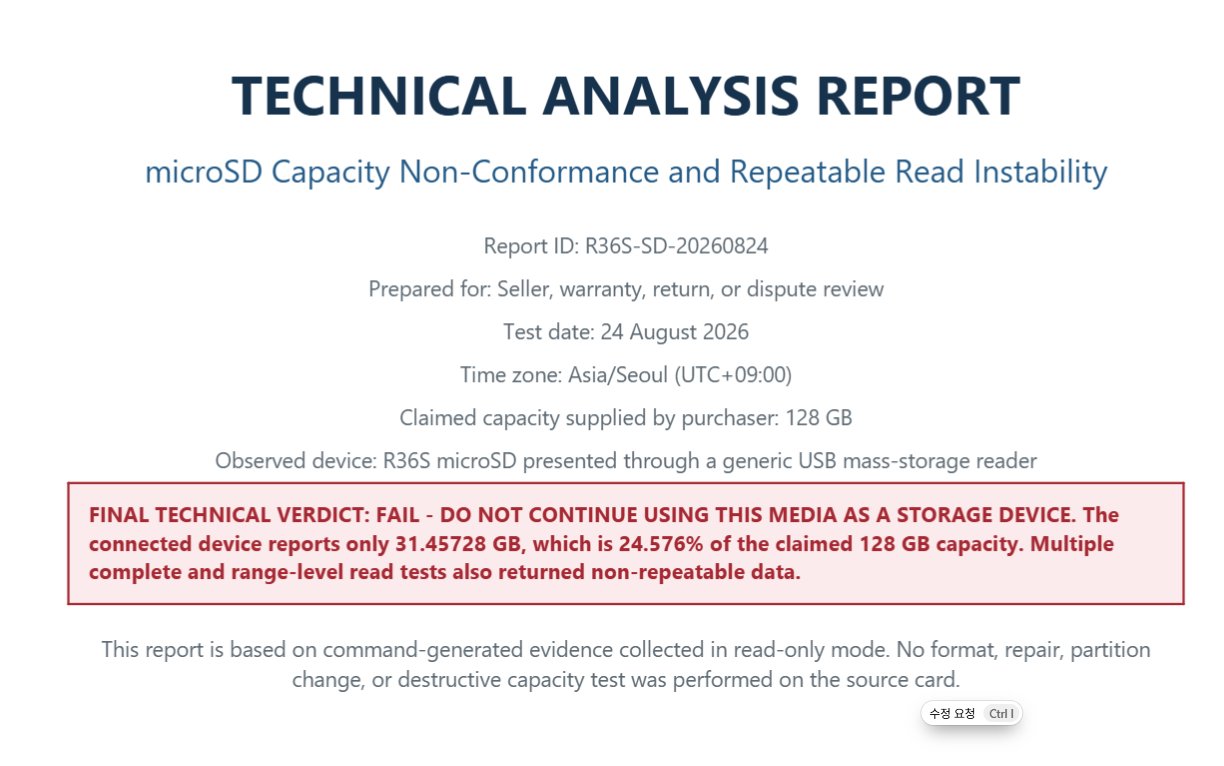
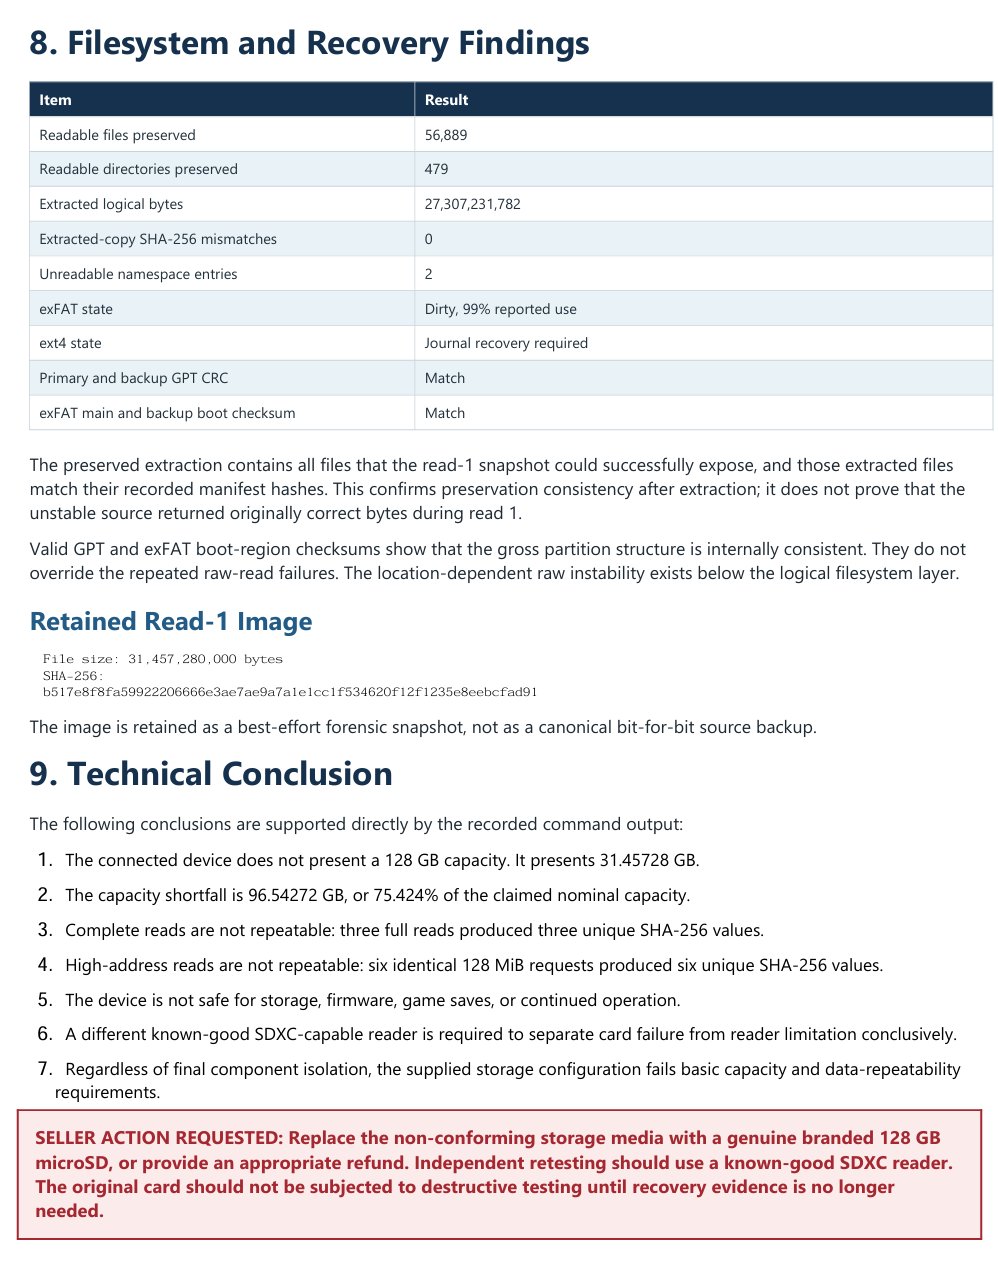
    알리에 분쟁을 제기하기 위한 기술 분석 보고서를 알아서 제작함. https://t.co/THLUc34Bx9 오류가 반복되던 SD카드를 Codex로 분석한 경험 — X 원문 첨부 오류가 반복되던 SD카드를 Codex로 분석한 경험 — X 원문 첨부
    원문 보기
  3. 3
    @HiddenDeals44 그쪽도 구독제는 가이드라인 만만치 않을껄요?
    원문 보기
  4. 4
    @yulmu_coffee 하지만 Codex 가 잡았죠 ㅋ
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 알리익스프레스에서 구매한 128기가바이트 SD 카드에서 반복적인 오류가 발생하자, Codex를 통해 분석을 진행하여 용량 오표기와 불량 판정을 내렸습니다. 특히 Codex가 분쟁 제기를 위한 기술 분석 보고서까지 자동으로 생성했다는 점은 인공지능 모델의 실무적 활용 가능성을 보여주는 흥미로운 사례입니다. 다만, 이 과정에서 구체적으로 어떤 분석 도구나 방법론이 사용되었는지는 원문에서 명시되지 않았으므로, 기술적 재현 가능성을 확인하기 위해서는 추가적인 검증이 필요합니다.

F3는 저장장치 용량 검사를 이해할 때 참고할 수 있는 도구이며, 이번 분석에 실제 사용됐다고 확인한 것은 아닙니다. 일부 검사는 데이터를 지우므로 검사 방식을 구분해야 합니다. 이 글에서는 AI의 판정을 그대로 믿었다는 이야기보다, 반복되던 이상 증상을 보고서와 대응 자료로 정리한 활용 과정에 주목하게 됩니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

f3

공식 문서 및 제작자 자료

F3 문서는 쓰기·읽기를 통한 저장 용량 검증을 설명하며 f3probe의 파괴적 실행은 기존 데이터를 지운다고 경고한다. 원문 사례에서 실제로 F3를 사용했다고 확인한 것은 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

사무실 이사 뒤 3090과 보조 GPU를 다시 조합하다

7개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
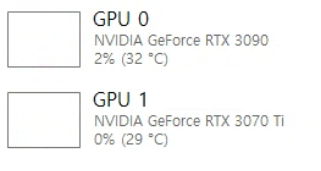
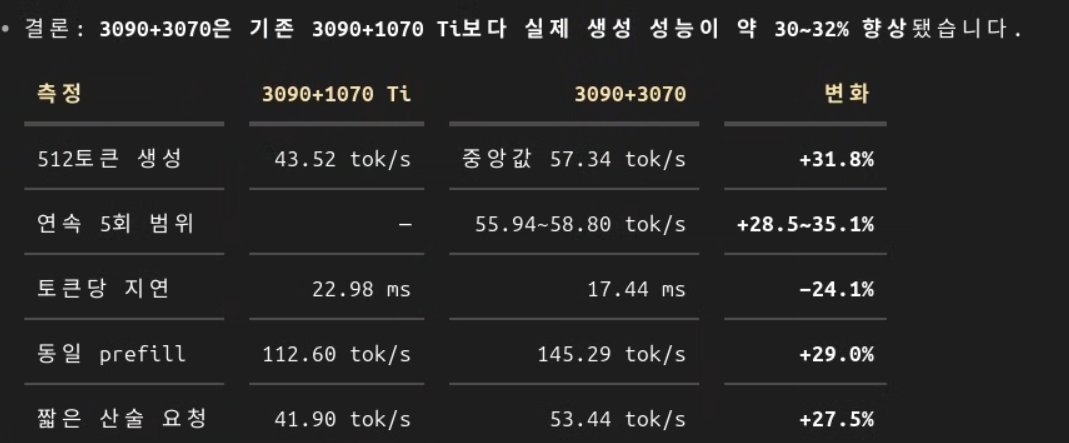
    사무실 이사가 끝나감 비극 : 사무실 이사 중 모니터 하나 해먹음. (싸게 산 구형이라 크게 아쉽진 않지만, 모니터 하나가 필요해진 상황이 되었음) 희극 : 이사 이후 Api 서버에 1070 Ti를 빼고 3070을 넣어 3090+3070을 햇더니 모든 부분에서 성능이 향상되었음. (3060~70 한장 더 사야하나 고민중) https://t.co/8cdC0cog9p 사무실 이사 뒤 3090과 보조 GPU를 다시 조합하다 — X 원문 첨부
    원문 보기
  2. 2

    pci-ex X4 라서 3090+3090 듀얼은 성능 향상폭이 적을 거라고 판단했는데 기존에 효과가 낮았던 3070의 병렬 사용시 의외의 성능 향상을 보여줘서 화들짝 놀람.

    이정도 디코딩이면 실사용에 거의 문제없음. 4090 수준 아닌가 저거…

    원문 보기
  3. 3
    @Krongggggg 에엣 살려주세요 깡통 맛없습니다 ㅋㅋㅋㅋ
    원문 보기
  4. 4

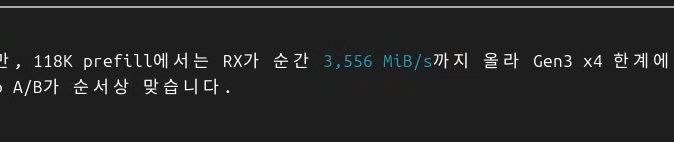
    역시 듀얼로 쓰면서 Pci-EX 슬롯의 한계를 끌어내는 가장 효율 좋은 그래픽카드를 서브로 올려서 보조적으로 돌리면 꽤 높은 성능 향상을 볼 수 있겠네요.

    아무리 느리다 해도 Pci-EX X 4가 되면 대역폭은 단방향 8 GB/s 니까. 쓸만한 대역폭이 나와요. https://t.co/LMjRShyFmY

    사무실 이사 뒤 3090과 보조 GPU를 다시 조합하다 — X 원문 첨부
    원문 보기
  5. 5

    3070이 프리필 기준으로 성능한계선이네. 근데 디코드는 더 올릴 수 있으니 그래픽카드가 좋아지면 좋아질수록 성능이 좋아지긴 하겠네.

    다만 3080~3090의 중고가격을 생각하면, 3090을 메인으로 집어넣는다면 3070 수준을 보조로 집어넣는 게 가장 효율이 좋을 듯.

    3070 4060 5060 8? https://t.co/JOPbcGmnct

    사무실 이사 뒤 3090과 보조 GPU를 다시 조합하다 — X 원문 첨부
    원문 보기
  6. 6

    Pc1 : 64G Ram + 3090+3070ti (1070ti > 3090) Pc2 : 48G Ram (16G 추가) 3090+3070

    cmp 170hx 를 4장 사려고 했는데 물건너간거 같고. 여기서 더 업글하려면 이제 Dgx sparkX2 뿐인가… https://t.co/yHi062SZsV

    사무실 이사 뒤 3090과 보조 GPU를 다시 조합하다 — X 원문 첨부
    원문 보기
  7. 7

    1070ti > 3070Ti

    오타

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 사무실 이사 후 RTX 3090과 보조 그래픽카드를 조합하여 로컬 거대언어모델 운용 성능을 확인하셨습니다. GTX 1070 Ti를 RTX 3070 및 3070 Ti로 교체하며 디코딩 성능이 향상된 점을 직접 관측하셨으며, 특히 PCIe x4 슬롯의 대역폭이 단방향 8 GB/s 수준으로 작동하여 실사용에 무리가 없다는 경험적 판단을 내리셨습니다. 다만, PCIe x4의 실제 대역폭은 하드웨어 세대에 따라 차이가 발생하므로, Serio님이 언급하신 수치가 모든 환경에서 동일하게 적용되는지 여부는 추가 확인이 필요합니다.

llama.cpp 문서는 GPU를 나눠 사용하는 방식을 설명하지만, 이 조합의 성능을 보장하지는 않습니다. 4090에 근접한다는 평가는 당시 작업의 체감으로 한정해야 합니다. 새 장비를 통째로 사는 대신 남는 슬롯과 보조 카드를 활용해 어디까지 개선할 수 있는지 확인했다는 데 실용적인 의미가 있습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

llama

공식 문서 및 제작자 자료

llama.cpp 서버 문서는 GPU 분할과 reasoning-budget 옵션을 설명한다. 문서의 현재 옵션과 원문 작성 당시 버전의 동작을 구분해야 한다.

primary-source

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
    정량평가와 정성평가는 서로 떨어져 있지 않다. 정량평가의 강점은 객관성이고 정성평가는 깊이 있는 탐색이 가능하다. 정량평가가 있어 정성평가가 대표성을 갖출 수 있고, 정성평가가 있어서 정량평가가 놓칠 수 있는 것들을 집어낼 수 있는 것이다. 둘 중 하나를 놓치면, 다른 쪽도 무너진다.
    원문 보기
  2. 2
    또한 많은 평가의 실패는, 하나의 평가 속에서 너무 많은 것을 보려고 할 때 생긴다. 평가는 단순해야 한다. 평가도구의 평가요목이 복잡해지면 그 어떤 것도 제대로 평가할 수 없게 된다. 또한 평가 범위가 너무 넓으면, 그 넓이 속에서 평가도구들과 평가자들은 길을 잃는다.
    원문 보기
  3. 3

    그래서 평가 설계를 할 때 가장 하면 안되는 것이 욕심을 부리는 것이다. 이 평가도구로 모든 것을 볼 수 있게 하겠어, 필요한 것들을 다 도구 속에 집어넣겠어는 결국 많은 것들을 놓치게 만든다.

    BTB, Simple is best 는 어디에든 통용되지만 특히 평가의 측면에선 제일 중요한 부분이다.

    원문 보기
  4. 4
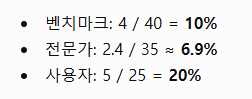
    그래서 독파모 보도결과의 평가배점을 보자마자 한숨이 턱 나왔다. 모델의 성능을 보려면 평가도구는 성능 측정에 집중해야 하고 응답과 대중친화도를 보려면 그 쪽에 집중했어야 했다. 전문가의 정성평가를 보려면 마찬가지로 그쪽에 집중했어야 했다.
    원문 보기
  5. 5
    하지만 배점은 벤치가 높았어도, 실제 점수의 편차는 일반인 응답이 더 컸다. 결국 웩 더 독이 되고야 말핬다. 그래서 원 글에도 적어놨지만, 평가를 설계한 쪽에 1차적 책임이 있다고 적어 놓은 것이다. https://t.co/Ge0hWVqoJx 평가도구 하나에 너무 많은 것을 담지 말아야 하는 이유 — X 원문 첨부
    원문 보기
  6. 6
    지난번의 자극적 이슈와 다르게, 이 타래는 아마 많이 읽지 않을 것이다. 진실은 지루하고 따분하다. 하나 누군가 이 일에 관심을 가지고 있다면, 그리고 어떻게 해결해야 될지 궁금하다면 이 타래를 읽어 줬으면 좋겠다. 그리고 외양간을 고쳐 다음에는 같은 실수를 반복하지 않기를 진심으로 바란다.
    원문 보기
  7. 7
    아마 이 글이 이번 이슈의 마지막 글이 될 거 같고 그렇게 됬으면 좋겠다.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 정량평가와 정성평가의 상호보완적 관계를 강조하며, 평가 도구의 설계가 복잡해질수록 정밀도가 떨어진다는 점을 지적하셨습니다. 특히 평가 범위가 넓고 요목이 복잡하면 평가자가 방향을 잃게 되므로, 단순함이 평가의 핵심이라는 견해를 제시하셨습니다. 이러한 설계 원칙에 대한 주장은 평가론의 일반적인 관점과 궤를 같이하며 논리적 설득력이 높습니다.

독파모의 실제 배점표와 점수 편차는 이번 편집에서 독립적으로 확인하지 못했습니다. 그 수치에 대한 판단과 별개로, 성능과 대중의 선호를 한 점수에 담을 때 무엇을 측정하는지 흐려질 수 있다는 질문은 남습니다. 단순함 자체보다 평가 목적과 점수의 의미를 설명할 수 있느냐가 핵심이라고 생각합니다.

원문 기록맥락과 해석

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    3090/4090/5090으로 100Tok/s 이상을 Mtp/Dflash 등으로 뽑아냈다는 조회수팔이 FOMO들이 또 올라오는데, 싱글턴프롬이 아닌 에이전트 워크를 하려면 256K 풀컨텍스트는 필수임. 그리고 공식 MTP 드래프트를 이용해서 3090 40Tok/s ~ 5090 80Tok/s 가 한계선.

    계속 낮은 컨텍스트로 장난치지 말자.

    원문 보기
  2. 2
    @Harunene 그것도 대부분 컨텍스트도 2048~4096 수준입니다. 10K 도 안 넣고 무슨 짓인지?
    원문 보기
  3. 3
    @tinypia 그냥 안들려 안보여 해야 하는데 ;ㅁ; 잘 안되네요.
    원문 보기
  4. 4

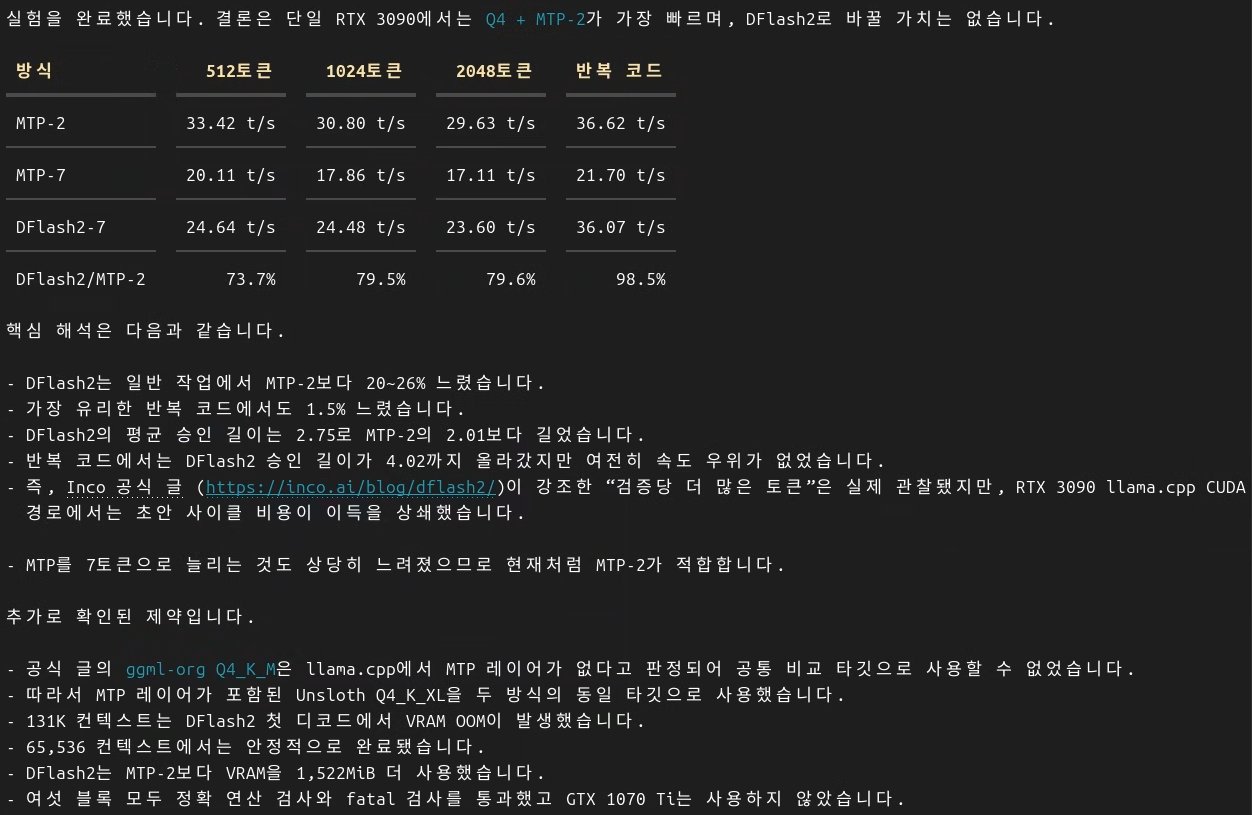
    실험결과 (3090/280W)

    • DFlash2는 일반 작업에서 MTP-2보다 20~26% 느림.
    • 가장 유리한 반복 코드에서도 1.5% 느림.
    • DFlash2의 평균 승인 길이는 2.75로 MTP-2의 2.01보다 김.
    • 반복 코드에서는 DFlash2 승인 길이가 4.02까지 올라갔지만 여전히 속도 우위가 없었음. https://t.co/AVC8n9e2GM
    MTP와 DFlash 속도를 비교할 때 컨텍스트를 빼놓을 수 없는 이유 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  5. 5원문 보기
  6. 6
    @fumi_KPFstudio 그래픽카드도 병렬화를 하고 텐서병렬(텐서 파이프라인)을 쓰면 스파크가 아니라도 어떻게든 될 것입니다 ^^;;; 다만 조회수를 얻기 위해 실현 불가능한 높은 디코드 속도를 말하는 사람들이 또 잘못된 정보를 퍼트리고 다니는 모습들은 정말 보기 싫네요. 말씀하신 대로 속도가 다가 아닌데…
    원문 보기
  7. 7
    @isomorphiccat 역시 다다익램 다다익카 😭
    원문 보기
  8. 8

    @IgyutaeI83275 고생하셨어요~

    아무래도 토큰맥싱 하는 모델의 구조상 추론을 억제시키지 않으면 128k 컨텍스트도 잦은 세션압축에 시달릴 거 같다고 생각해요.

    원문 보기
  9. 9
    @TwoFiveStart 잘게 채를 써셨군요 ㅡㅡㅋ
    원문 보기
  10. 10
    @firecat03244 양자화를 좀 낮추시는 걸 추천합니다. 양자화 내성이 좋아서 Q3도 쓸만하고 컨텍스트는 128K 정도만 되도 쓸만할껍니다.
    원문 보기
  11. 11
    @IgyutaeI83275 그래도 생각하는거랑 안하는건 또 퀄리티 차이가 커서 가급적 low 라도 리즈닝(씽킹)은 켜는게 나은 거 같다고 생각하고 있습니다.
    원문 보기
  12. 12
    @habeekim 저는 토큰도 상당수 ;ㅁ;
    원문 보기
  13. 13
    @cn_Vincentzyx 짧은 단순 프롬프트를 반복하면 모르겠습니다만, 장기작업을 풀컨텍스트에서 하면 주장과 상반된 결론이 나오네요.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 MTP와 DFlash의 속도 비교 시 컨텍스트 길이를 간과해서는 안 된다고 주장합니다. 특히 에이전트 작업에는 256K 수준의 풀 컨텍스트가 필수적이며, 하드웨어별 처리 속도 상한선이 존재한다는 점을 강조합니다. 다만 256K가 필수라는 주장이나 특정 GPU의 속도 한계치는 보편적인 법칙이라기보다 Serio님의 운용 기준에 가깝기에, 일반적인 적용 가능성에 대해서는 추가 확인이 필요합니다.

DFlash2와 MTP-2를 비교한 후속 기록에는 승인 길이가 길어도 속도 우위로 곧장 이어지지는 않았다는 관찰이 있습니다. 이는 해당 실행 조건의 결과로 남겨야 합니다. 짧은 시연에서 보이는 속도와 긴 에이전트 작업을 버티는 속도를 같은 숫자로 비교하지 말자는 것이 이 묶음의 중심이라고 읽힙니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

llama

공식 문서 및 제작자 자료

llama.cpp 서버 문서는 GPU 분할과 reasoning-budget 옵션을 설명한다. 문서의 현재 옵션과 원문 작성 당시 버전의 동작을 구분해야 한다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

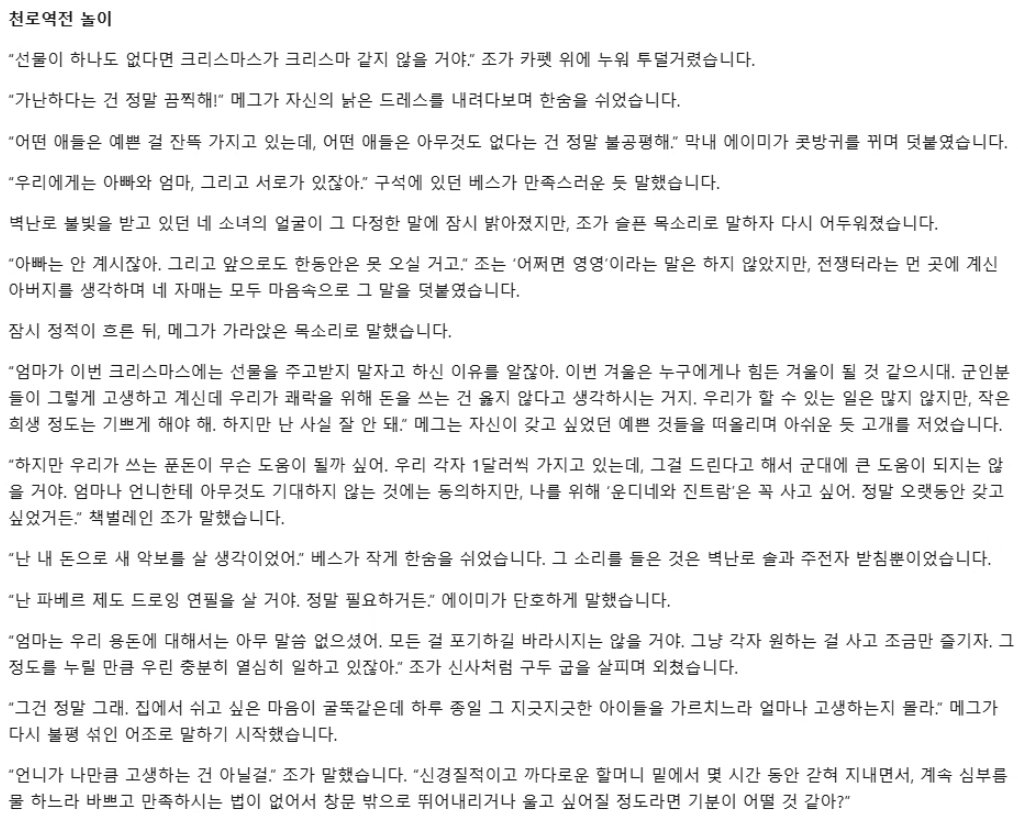
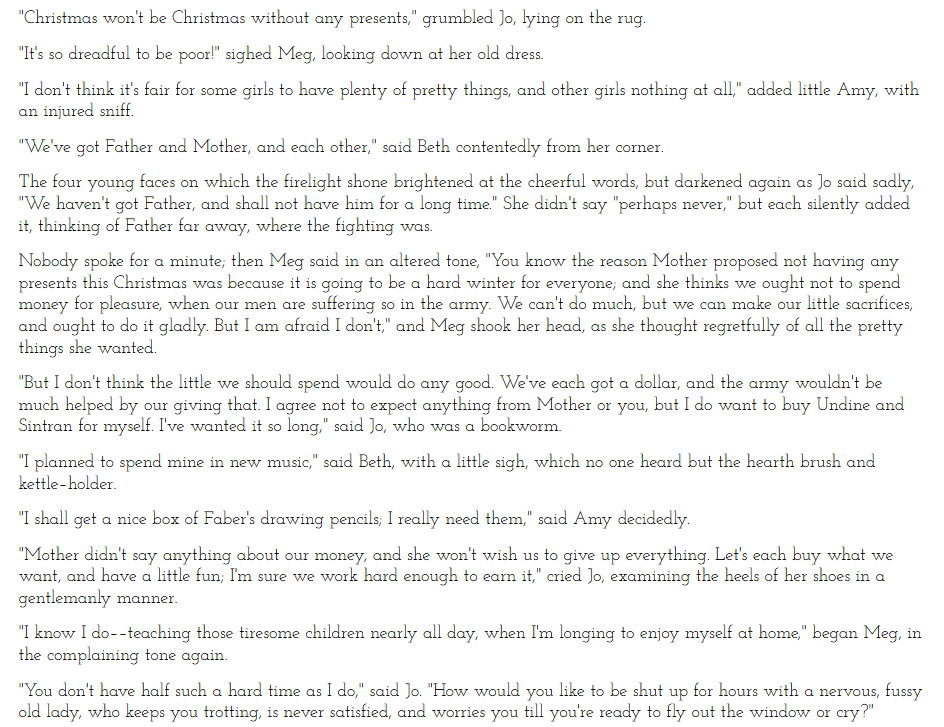
작은 아씨들 번역으로 비교한 Qwen과 Gemma

7개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

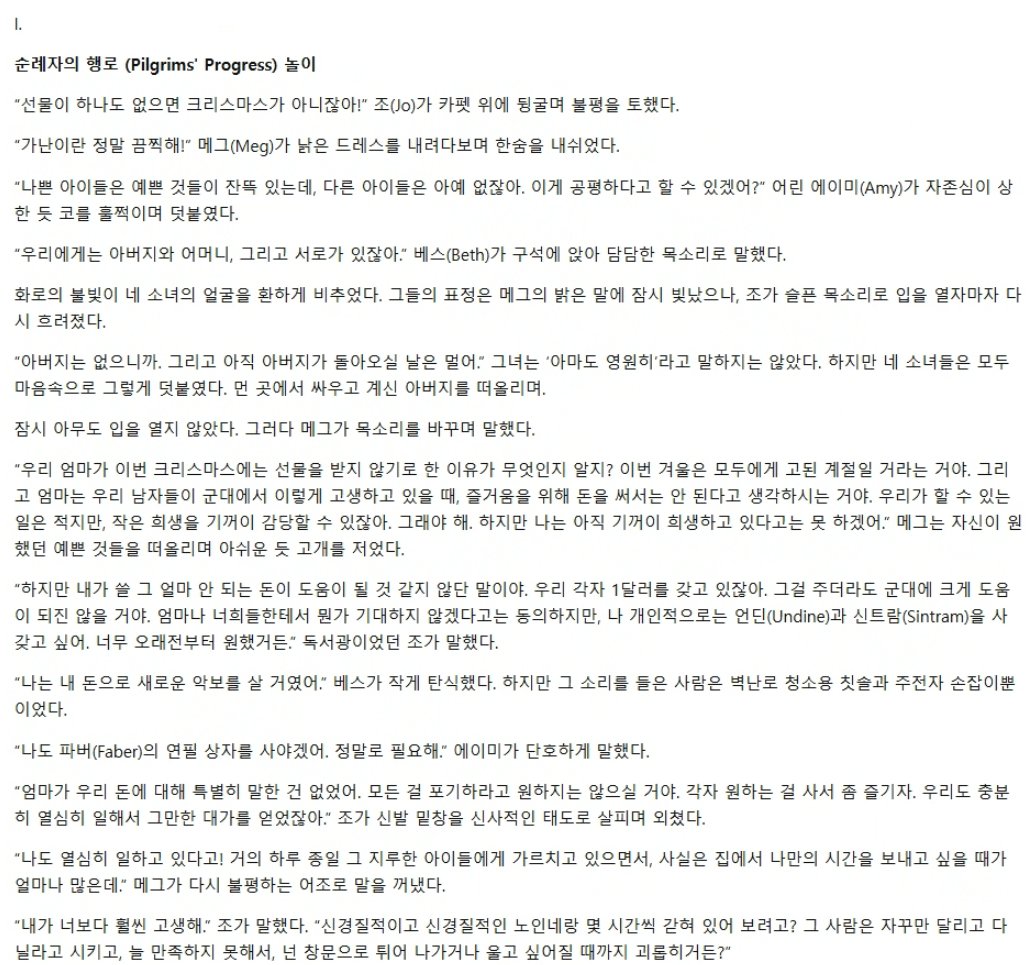
    오히려 번역은 리즈닝을 끄고 뽑는 게 좋은데, 그럼 강점을 살리지 못하니 의미가 퇴색됨. 이 부분은 Gemma4 31b 가 더 우수함. 일본분들도 텍스트 자체는 Gemma4 가 더 낫다고 하니 비슷한 감각일 듯.

    코딩/제작용이라는 기존 방향은 바뀌지 않을 듯.

    < Qwen 3.6 (Non think) > Gemma4 31b (think) https://t.co/eOznNMLJ4O

    작은 아씨들 번역으로 비교한 Qwen과 Gemma — X 원문 첨부 작은 아씨들 번역으로 비교한 Qwen과 Gemma — X 원문 첨부
    원문 보기
  2. 2
    번역 원본. 작은아씨들 1부 1장 초반부. https://t.co/MKs95ynHrC 작은 아씨들 번역으로 비교한 Qwen과 Gemma — X 원문 첨부
    원문 보기
  3. 3
    Gemma4는 어투는 조금 어눌하고 오타가 있어도 원문의 내용을 그대로 살림. 하지만 Qwen은 오역이 꽤나 많이 발생함. 특히 없는 내용을 어거지로 번역해 집어 넣는 것은 좀 치명적임.
    원문 보기
  4. 4
    @tinypia 자연어 처리는 아직까지 구글쪽이 확실히 좋네요. 데이터셋도 저쪽이 나은 거 같고.
    원문 보기
  5. 5
    @ririnto_ri 히히 보여줄때 나란히 보여달란 말씀이시죠? 아예 테스트용 워크플로우 하나 만들어 볼께요.
    원문 보기
  6. 6
    @ririnto_ri 아이디어 주신 김에 또 한번 해 보죠 뭐. ㅋㅋㅋㅋ
    원문 보기
  7. 7

    @tinypia 어제 재미있는 글을 읽었는데 Gemini 2.5 Pro의 문장구사력+네러티브가 RP에 꽤나 선호된다는 내용이었죠.

    저도 그 시절부터 꽤나 쓸만한 문장구조를 만들어 낸다는 느낌을 받았습니다.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 소설 '작은 아씨들'의 번역 결과물을 통해 Qwen 3.6과 Gemma 4 31B의 성능을 비교하셨습니다. Serio님은 Gemma 4가 어투가 다소 어눌하더라도 원문의 내용을 충실히 살리는 반면, Qwen은 없는 내용을 임의로 추가하는 오역이 발생한다고 평가하셨습니다. 다만, 이는 서로 다른 추론 설정으로 진행된 개별적인 실험이기에 엄격한 통제 변수 기반의 비교라고 보기에는 근거가 약하며, 구체적인 성능 차이의 원인이 데이터셋의 우위인지 여부는 추가 확인이 필요합니다.

Gemma 공식 모델 카드의 구조 설명과 번역 품질의 원인은 서로 다른 문제입니다. 좋은 번역을 구글의 데이터셋 덕분이라고 확정할 수는 없습니다. 다만 문장이 자연스러운가와 원문을 충실히 옮겼는가를 나누어 본 비교는, 번역 모델을 고를 때 무엇을 먼저 확인할지 생각하게 합니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

gemma

공식 문서 및 제작자 자료

Google 모델 카드는 Gemma 4의 31B Dense와 26B A4B MoE 등을 구분한다. 활성 파라미터는 전체 가중치 용량과 다르다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지

14개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Qwen 3.8 27b 는 리즈닝 버짓 (리즈닝 캡)을 씌워주는게 좋다 해서 해보는 중

    Lmstudio는 없는 줄 알았는데 있네요. https://t.co/h2LTEH6bmk

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  2. 2

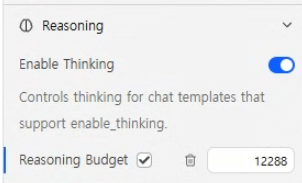
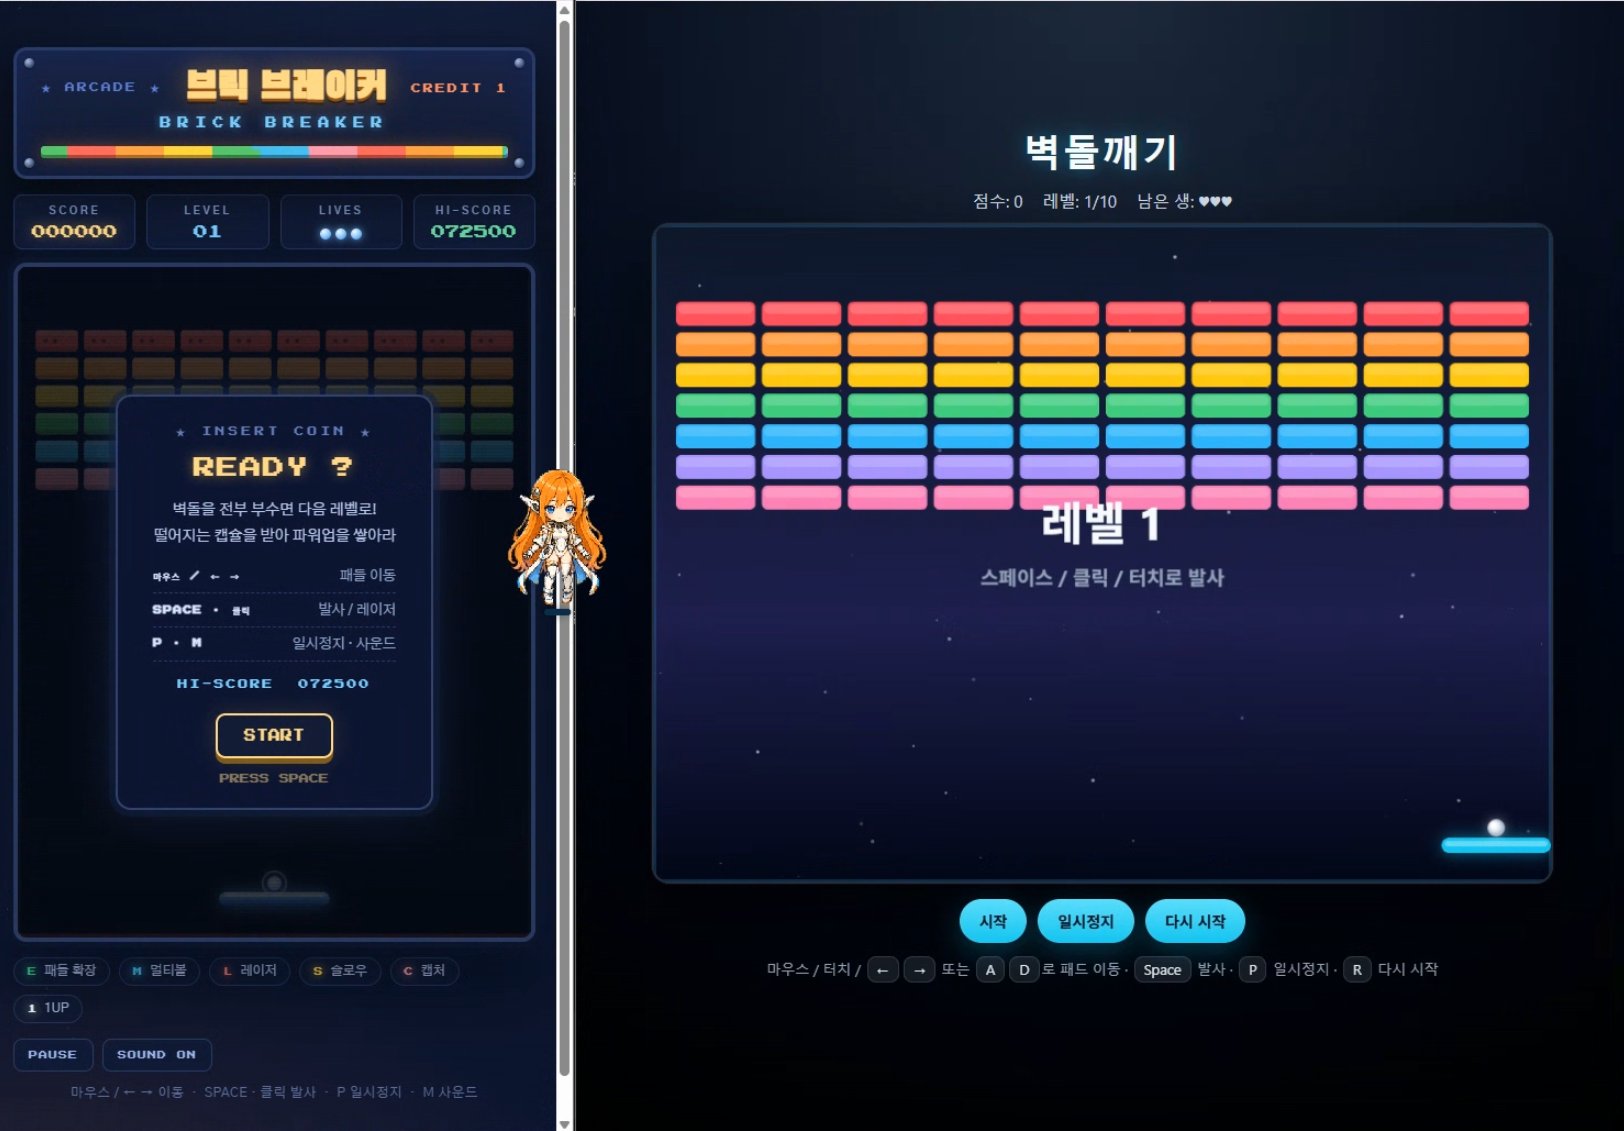
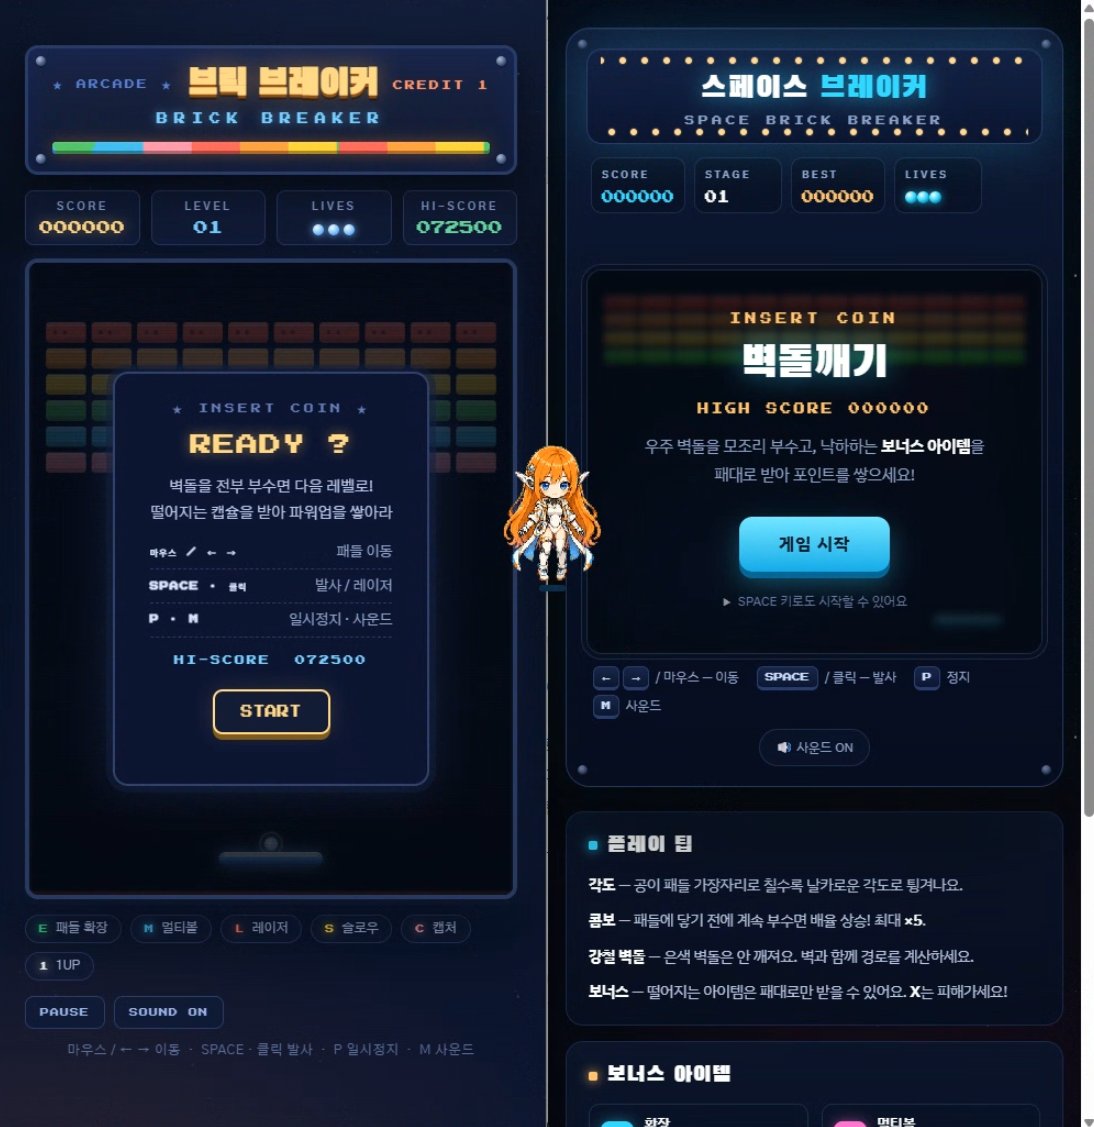
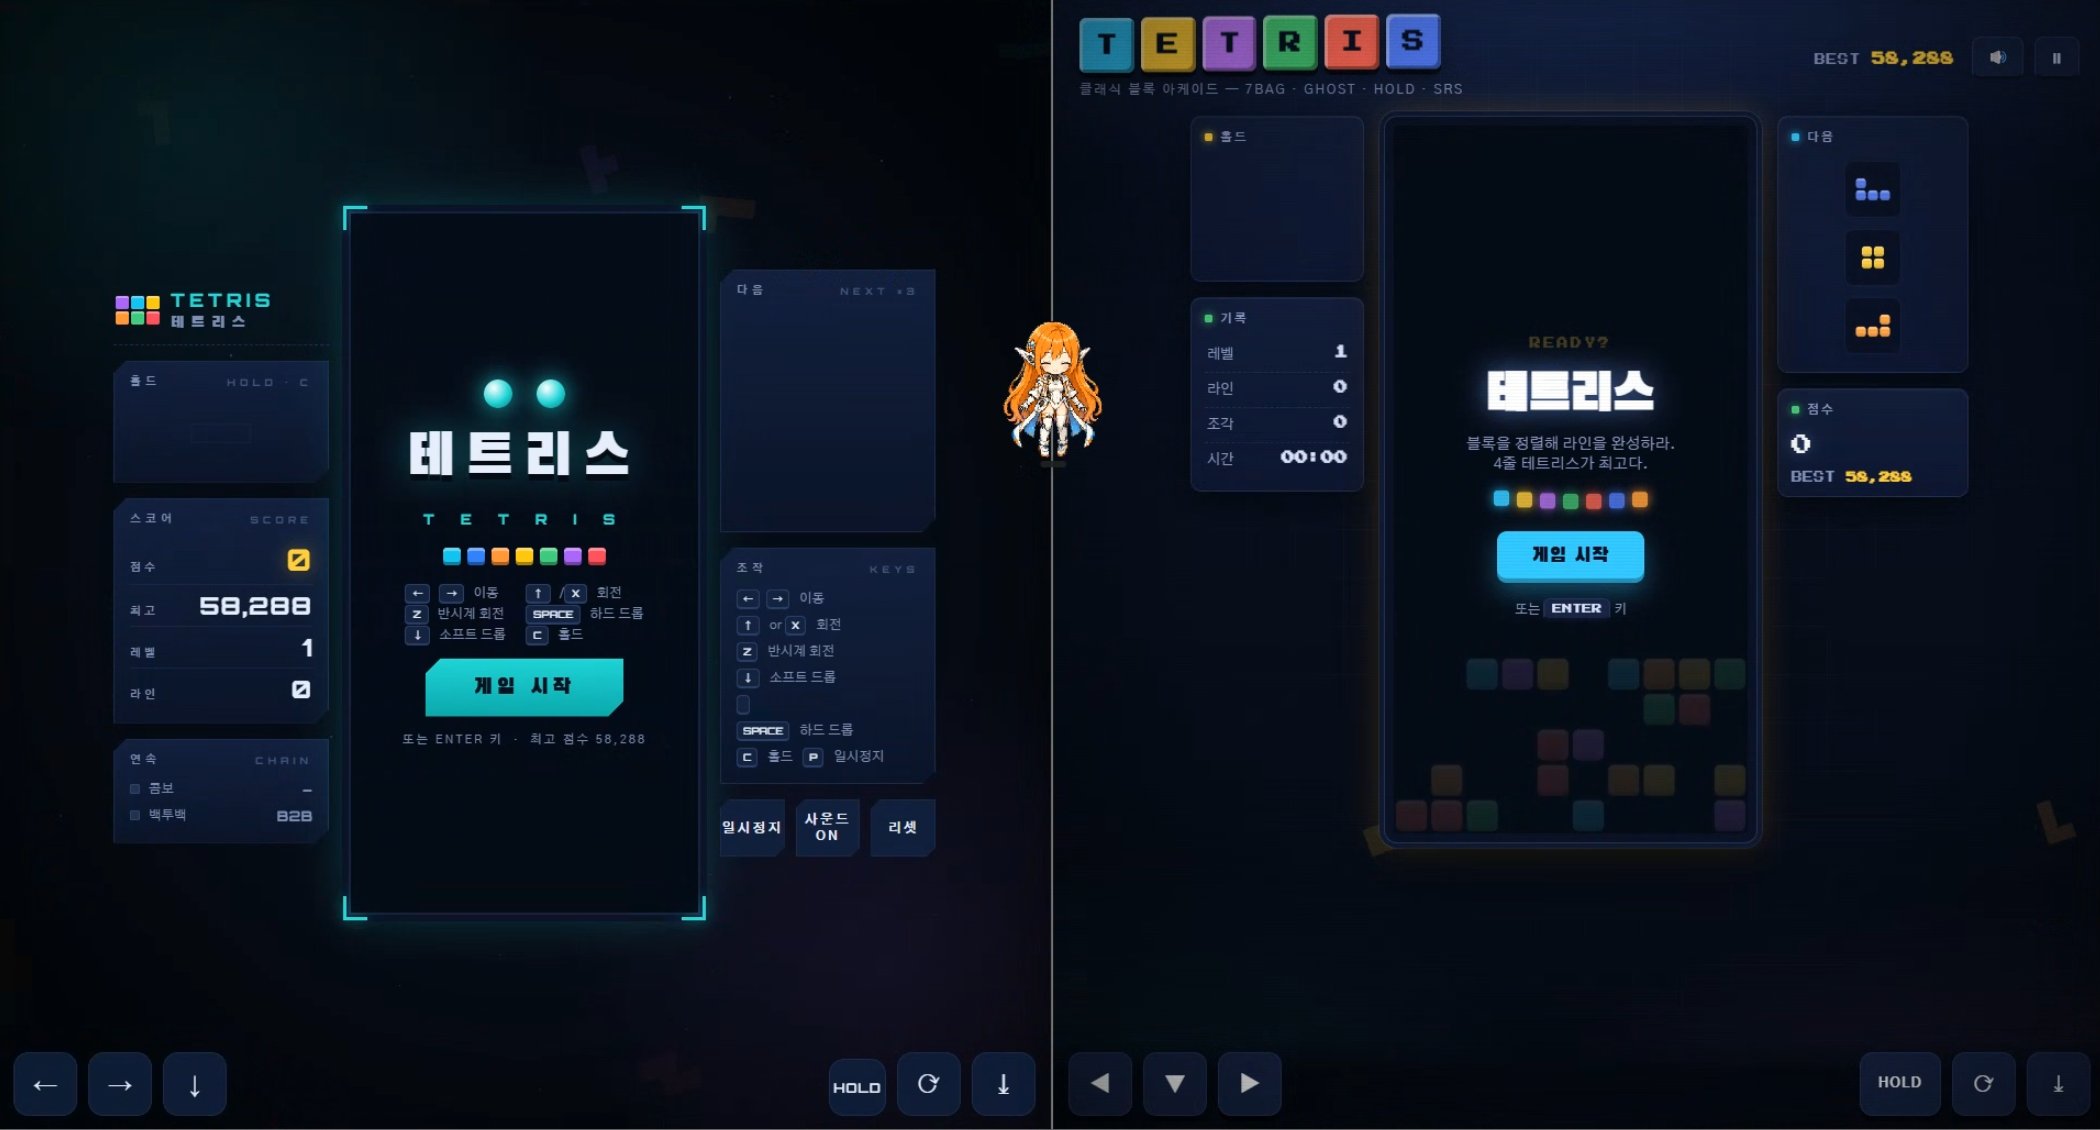
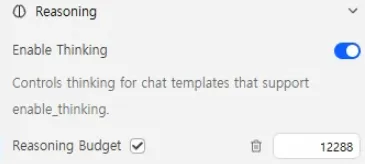
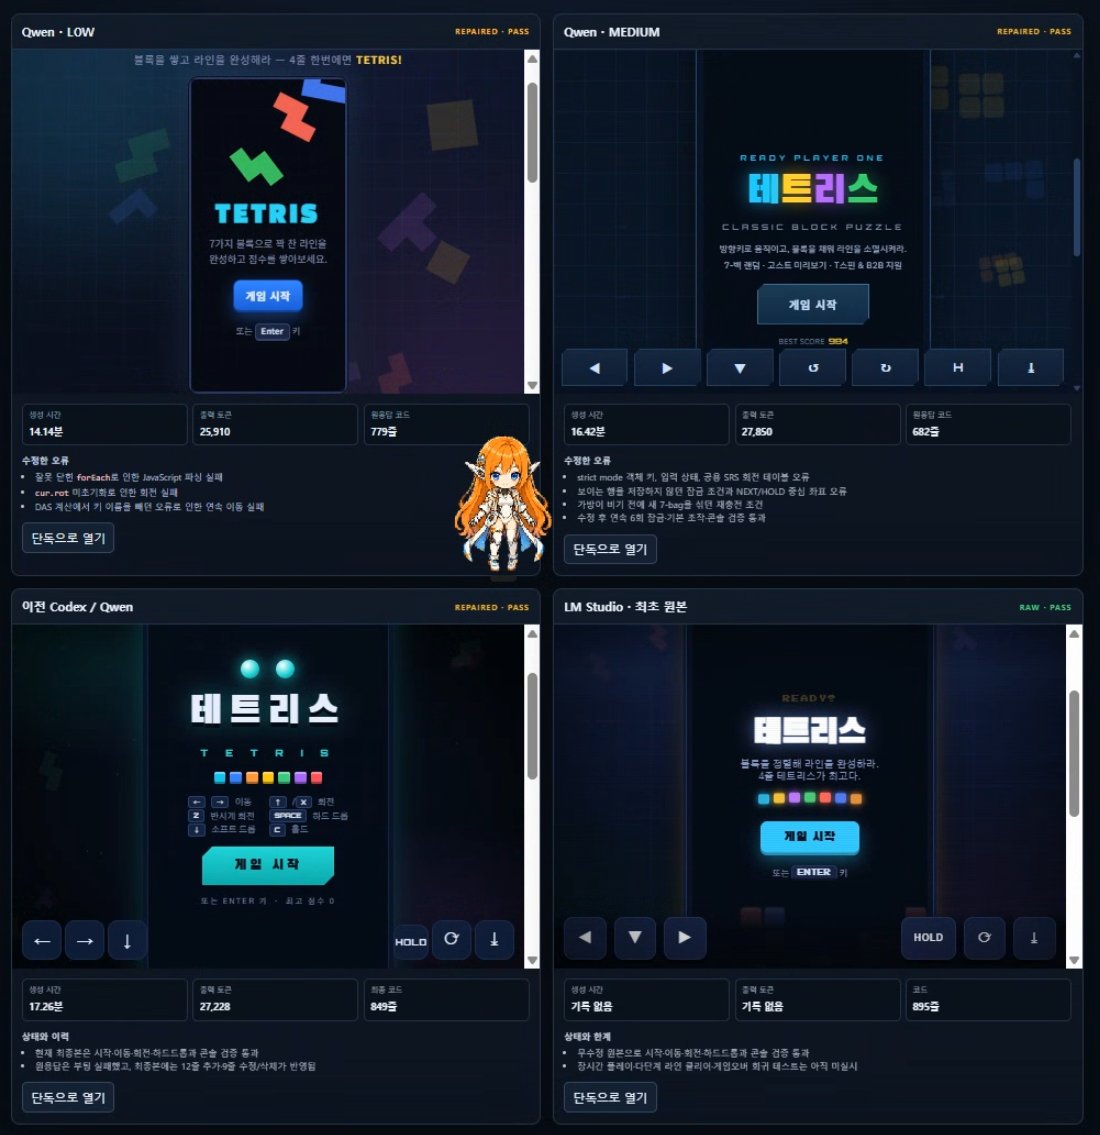
    < 왼쪽 : Lmstudio chat (하네스X) : 31분 > 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 12288)

    작업 시간이 확실히 줄어든 건 좋은데 결과는 좀 떨어지네요.모델 스스로 이쯤이면 됬다고 판단할 때까지 깊이 있는 추론을 해야만 좋은 결과가 나오는 듯 합니다. https://t.co/BH2fyuh5Dg

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  3. 3

    < 왼쪽 : Lmstudio chat (하네스X)
    > 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 없음)

    그렇게 판단한 이유가 다음과 같아요. 작업 시간이 서로 많이 차이가 나긴 했지만 리즈닝캡이 없을 땐 한계까지 추론하면서 비슷한 결과를 만들어 내거든요. https://t.co/KUT1SnlwyP

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  4. 4

    지금 제 환경에선 Lmstudio chat 에서 과추론 하면서 만들어 내는 결과물이 결과물의 완성도 측면에선 제일 좋아서 좀 당황스럽네요. 이걸 어떻게 써야할지도 좀 고민스럽구요.

    일단 리즈닝캡을 1.5배로 열어 놓고 몇번 더 테스트를 할 듯.

    원문 보기
  5. 5

    < 왼쪽 : Lmstudio chat (하네스X) : 20분
    40,627B / 895줄

    > 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 12288) : 17분 30초 37,510B / 845줄 (사소한 버그가 있어서 별도로 해결)

    리즈닝 캡에 딱 맞는 게임이라 티가 안나나? https://t.co/6ZEt2UcFsw

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  6. 6

    리즈닝 캡 없이, 단순 프롬프트로 제작한 버전. https://t.co/8QzYnYIO5z

    리즈닝 캡 씌우고 제작한 버전. https://t.co/QNnM4qnh98

    원문 보기
  7. 7

    @gosrum 전 llama.cpp + lmstudio 를 사용중인데 둘 다 적용 가능했습니다. vllm도 가능할 것으로 판단합니다.

    –reasoning on
    –reasoning-format deepseek
    –reasoning-budget 12288
    –reasoning-budget-message ‘I have enough information; answer now.’ https://t.co/gMc8ZNN9ZG

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  8. 8

    아 이 결과를 어떻게 받아들여야 하나.

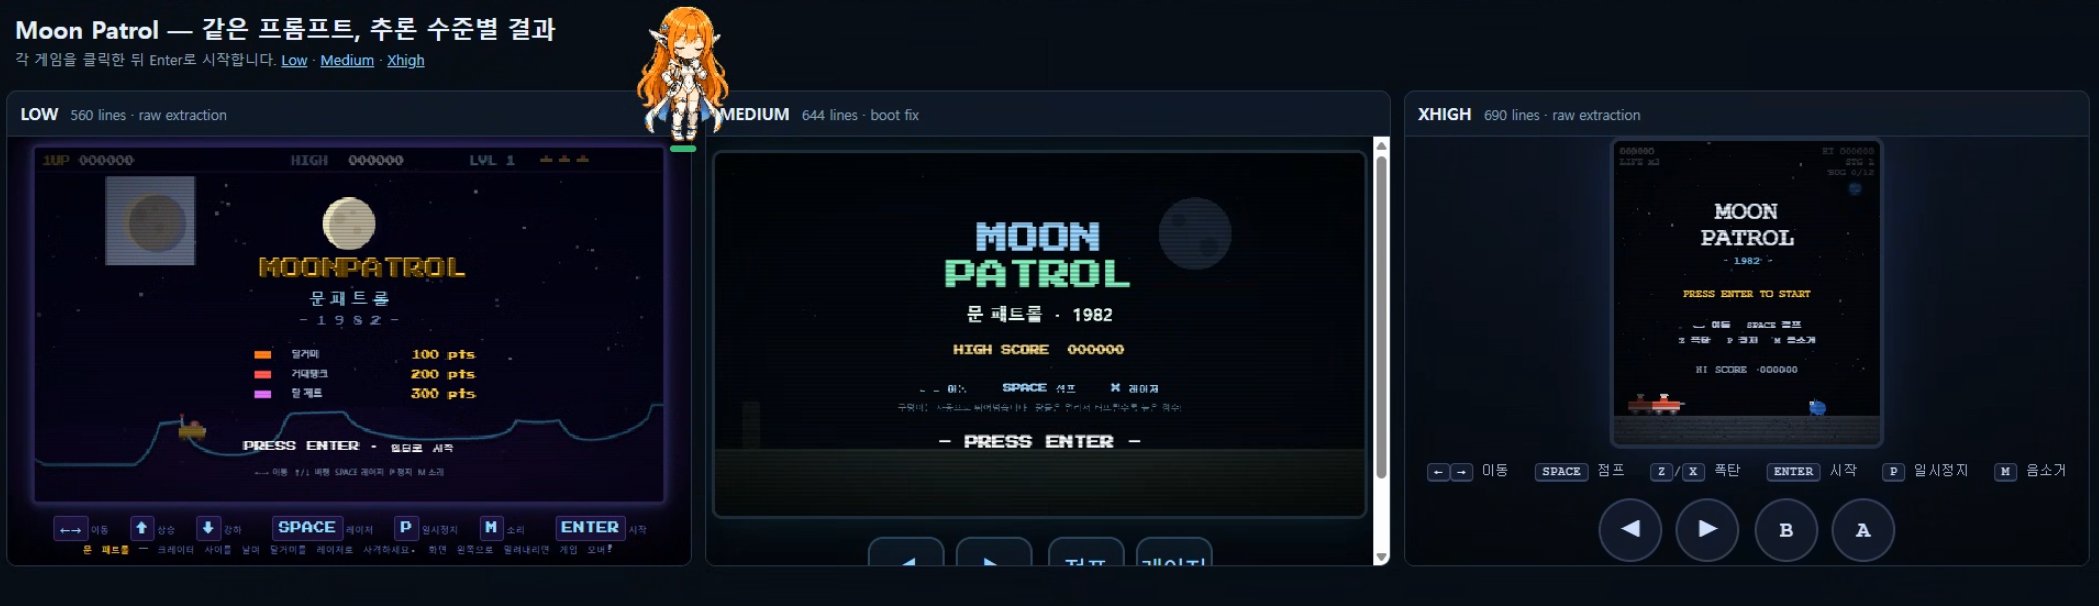
    고전게임 Moon Patrol 을 원샷프롬으로 제작해 추론 설정에 따른 결과를 비교해 보았습니다.

    음. 꽤나 분석이 길어질 거 같은데 결론만 이야기하면 Low 도 쓸만하다. 입니다. 다만 만족스럽냐? 하면 그건 아닌 거 같네요. https://t.co/jlR5zf2j2M

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  9. 9

    Qwen 3.8 27b 3일간 돌린 후 추론 단계 추천.

    1순위 : 추론 Low 빠르고 우수한 결과물을 내 줌. 다만 중간중간 오류가 발생하는데 그걸 잡아주지 못함. 별도의 감사 과정이 필요함.

    2순위 : 추론 Xhigh 느리지만 우수한 결과물. 오류를 스스로 해결함. 다만 토큰이 너무 많이 필요.

    3순위 : 없음 https://t.co/bXuqJ8iIjE

    Qwen 추론 예산 실험: 초기 가설에서 Low 권장까지 — X 원문 첨부
    원문 보기
  10. 10

    추천 안하는 추론 단계

    Medium : Low 의 문제점과 Xhigh의 문제점을 다 가짐. 토큰 비용은 늘었지만 추론을 더 한다고 해서 문제를 끝까지 수정하지 못하고, 과정에서 다른 걸 건드려서 문제를 더 키움.

    추론 X (Instruct) : 전반적으로 퀄리티가 떨어짐. 환각이 강해짐.

    원문 보기
  11. 11

    Qwen 3.8 27b 검증 최종 결론

    • 하네스 사용을 최소화 할 것
    • 리즈닝 버짓(캡) 6K ~ 12K
    • 추론은 Low
    • 단독사용은 추천하지 않음.

    작업 결과는 우수하나, 세션 메인 Ai로는 부적절. 하네스 사용을 최소화하고 Gpt 5.6 luna Max 정도의 검증 Ai를 두고 결과를 감사하고 오케스트레이션 할 것.

    원문 보기
  12. 12

    @thinkgod123 저희집 Gpt 도 처음엔 medium을 좋아하길레 떽 하고 평가지표를 좀 바꾸어주니 바로 low가 맞다고 이실직고를 ㅡㅡㅋ

    아무래도 수치상 정량평가는 ‘토큰 소비량 조금 늘더라도 검토를 더 했다’에 가점을 주기 쉬우니 말이죠 ㅋㅋㅋ

    원문 보기
  13. 13
    @Hyun_The_Wise 생각 많이하지 마!! 라고 선 그어주는거니깐요 ㅋㅋㅋ
    원문 보기
  14. 14

    하네스 사용을 최소화 하라곤 해 놨지만 하네스가 마냥 나쁜 모델은 아님. 다만 하네스를 적용하면 모델이 작아서 그런건지 모르겠지만 너무 지시에 순응하려고만 해서 모델이 가진 매력을 쉽게 잃어버렸음.

    봄날 망아지 뛰어 놀듯 좀 냅둬야 되는 모델이라 보는 중.

    Qwen Code 쓰면 나아지려나.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.8 27B 모델의 추론 예산 설정에 따른 결과물 차이를 3일간 실험하며, 최종적으로 추론 단계를 'Low'로 권장하고 있습니다. Serio님은 추론 예산 제한을 6천에서 1만 2천 사이로 설정하고 하네스 사용을 최소화할 때 효율이 가장 좋다고 판단하셨으며, 단독 사용보다는 검증용 인공지능을 함께 배치하는 구성을 제안하셨습니다. 다만, 이러한 권장값은 Serio님의 개인적인 실행 환경과 특정 작업물에 기반한 경험적 기록이므로, 모든 사용자에게 동일하게 적용될지는 확인이 필요합니다.

초기의 긴 추론에 대한 기대가 후속 실험을 거쳐 Low 권장으로 바뀌는 흐름을 함께 보는 것이 중요합니다. Unsloth 문서가 이 설정을 보장하는 것은 아니지만, 그렇다고 실제 시행착오의 가치가 줄어드는 것도 아닙니다. 이 글의 설정값은 출발점으로 삼고 자신의 과제에서 시간과 결과물을 함께 비교하는 편이 기록의 취지에 맞겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

qwen

공식 문서 및 제작자 자료

Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

AI 글을 비판적으로 읽기 위한 프롬프트

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    새벽에 쓴 글들을 좋게 봐 주시니, 프롬프트 선물 하나 까 봅니다.

    “1. 다음 글을 논리적, 수사(修辭)적으로 접근 분석해 보라.
    2. 1의 분석 내용을 바탕으로 ‘오컴의 면도날’을 이용 글의 필요 없는 부분을 쳐내고 본질을 드러내 보라.”

    결과물

    https://t.co/bygsdIiXvB https://t.co/QKjkw9YN55

    AI 글을 비판적으로 읽기 위한 프롬프트 — X 원문 첨부
    원문 보기
  2. 2

    웹에서 본 ai, 바이브코딩 아티클이 괜찮은데 뭔가 쌔하다 싶으면 다음 프롬프트를 써 보세요. 그럼 최신 하네스+모델 입장에서 뭐가 부족한지 그 쌔한 부분을 단번에 짚어 줄 거에요.

    지금은 딱 3개월만 지나도 다 낡은 지식이 되는 시기입니다. 유행에 흐름에 타기 보단 기본에 집중하세요. https://t.co/OET1WUfGFb

    AI 글을 비판적으로 읽기 위한 프롬프트 — X 원문 첨부
    원문 보기
  3. 3
    @goodtek_xyz 본문은 🤫
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 인공지능이 생성한 글의 논리적 허점을 찾고 본질을 추출하기 위해 논리 분석과 오컴의 면도날 원리를 적용한 프롬프트를 제안하셨습니다. 특히 최신 모델의 관점에서 지식의 유효 기간이 짧다는 점을 지적하며, 유행보다 기본기에 집중할 것을 권고하는 실무적인 경험을 공유하셨습니다. 다만, 이 프롬프트들이 실제 모든 텍스트에서 동일한 비판적 읽기 결과물을 보장하는지에 대한 객관적인 검증 자료는 부족하므로, 이는 개인의 운용 기록으로 읽어야 합니다.

프롬프트는 글을 대신 판정하는 최종 심판보다 질문을 놓치지 않게 돕는 도구로 읽힙니다. 모델이 찾아낸 모순도 다시 원문과 대조해야 하겠지요. 빠르게 바뀌는 도구 목록을 외우는 것보다 근거와 논리의 연결을 묻는 습관을 남기려는 제안이라는 점이 좋습니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

Qwen의 디자인을 살리는 협업과 하네스 선택

28개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Qwen 3.6 27b도 웹디자인 역량이 그럭저럭 괜찮아서 그 분야에서 파멸적인 Gpt 의 보조 역할로 사용했었는데, Qwen 3.8 27b 는 정말 좋아졌네요. 세팅해서 Gpt의 보조 역할 (디자이너 역할)을 주면 요긴하게 쓸 거 같습니다.

    (어디선가 약간 클로드나 중국 모델들 맛이 좀 나긴 하는데) https://t.co/NPXCcmflYq

    Qwen의 디자인을 살리는 협업과 하네스 선택 — X 원문 첨부
    원문 보기
  2. 2

    @ramztd 참으시면 됩니다. 더 좋은 Api 모델들이 많습니다.

    일단 루나가 디자인빼곤 다 잘해요 ㅋ

    원문 보기
  3. 3

    Qwen 3.8 27b사용 이후 코딩 에이전트/하네스에 대한 회의가 찾아옴.

    그냥 두면 야생마처럼 잘 달릴 모델을 억지로 하네스 꽁꽁 싸메서 말 잘 듣는 노새로 만들어 버리는 느낌.

    밤에 오마이파이 써봤는데 실망이 좀 컸음. Kimi code랑 qwen code 써봐야 할듯.

    원문 보기
  4. 4
    @lohaswinner 똑똑한 댕댕이는 하네스를 싫어한다고 하죠 ㅋㅋㅋ
    원문 보기
  5. 5

    @promptprobe 그럴 수 있겠네요. 여러 하네스를 돌려 보기도 하고 사용환경에 통합도 해보고 할게 이리저리 많이 생겼네요.

    컨텐츠가 생겼다~

    원문 보기
  6. 6
    @AiDevCraft 그렇다고 하네스를 아예 제거할 순 없으니, 재조정이 좀 필요하겠죠. 멍뭄미도 살찌고 커지면 새 하네스가 필요하듯이 말이죠.
    원문 보기
  7. 7
    @ramztd 우리 멈뭄미 아니 모델에겐 새 하네스가 필요하다!
    원문 보기
  8. 8
    @KettleLaughter 해보려고 준비하고 있어요~
    원문 보기
  9. 9
    @agurrrrrrrrr 연초만 하더라도 하네스가 참 유행이었는데, 이제 모델 자체의 성능이 올라가면서 코딩에이전트 형태로 변화하고 하네스가 쇠퇴하는 걸 보니 참 시간이 너무 빠르다 싶습니다.
    원문 보기
  10. 10
    @agurrrrrrrrr 항상 마이크로메니징이 문제인 것이죠 ㅋ
    원문 보기
  11. 11
    @Quinn_Delphi 애초부터 하네스가 야생마같던 모델을 제어하기 위해 만들어진 것이니까요 모델과 에이전트로 나눠질 것은 어찌 보면 예상할 수 있는 부분이긴 했죠.
    원문 보기
  12. 12
    @Benz_onttv 모델들의 성능이 좋아지면서 하네스도 개선이 필요하겠죠. 그리고 클로드코드는 하네스가 클로드 특화에 꽤 무거운 편입니다. 저도 Gpt를 클로드코드에 올려서 돌려봤는데, 큰 매리트를 느끼지 못했어요. (클로드코드 자체의 사용감은 Tui 중에선 꽤 좋은 편이라 아쉬웠습니다.)
    원문 보기
  13. 13
    @Benz_onttv 좋은 도전이라 생각합니다. 하지만, 도전 전에 하네스를 여러 개 많이 써 보는 것을 추천합니다. Pi와 그것을 개량한 oh my pi, 최근 인기 있는 Orca, Opencode, 헤르메스, kimi Code, Qwen code, Deepseek 하네스 등. 도구의 개량에 너무 시간을 낭비하진 마시기 바랍니다. 도구는 도구일 뿐이니까요.
    원문 보기
  14. 14

    @Benz_onttv 맞아요 저도 작은 하네스를 직접 만들었었고 (지금은 지웠습니다만) 그 경험은 하네스와 작동 구조에 대한 이해에 많은 도움을 주었습니다. 지금도 작업용 하네스들에 직접 필요한 튜닝을 하면서 작업하고 있습니다.

    경험이 제일 중요합니다. 응원합니다.

    원문 보기
  15. 15
    @genaiforgecom 결국 돌고돌아 제작사 하네스인가요. 흠. 그것도 한번 시도해봐야겠네요.
    원문 보기
  16. 16
    @goodtek_xyz 하네스를 어떻게 설명할까 항상 고민했었습니다 ㅋ
    원문 보기
  17. 17

    새벽부터 Qwen 을 Codex 에서 Qwen 3.8 27b 를 호출하는 자작 스킬을 통해 기존에 개발해 놨던 사이트/프로그램들의 디자인을 전면 재검토하는 작업을 수행 중.

    Gpt가 만들어놓은거 Qwen 한테 좍좍 찢기는거 보는 재미가 있네요. 투입한 자원이 많은 건 조금 버티는데 간단히 만든건 바로 털림.

    원문 보기
  18. 18

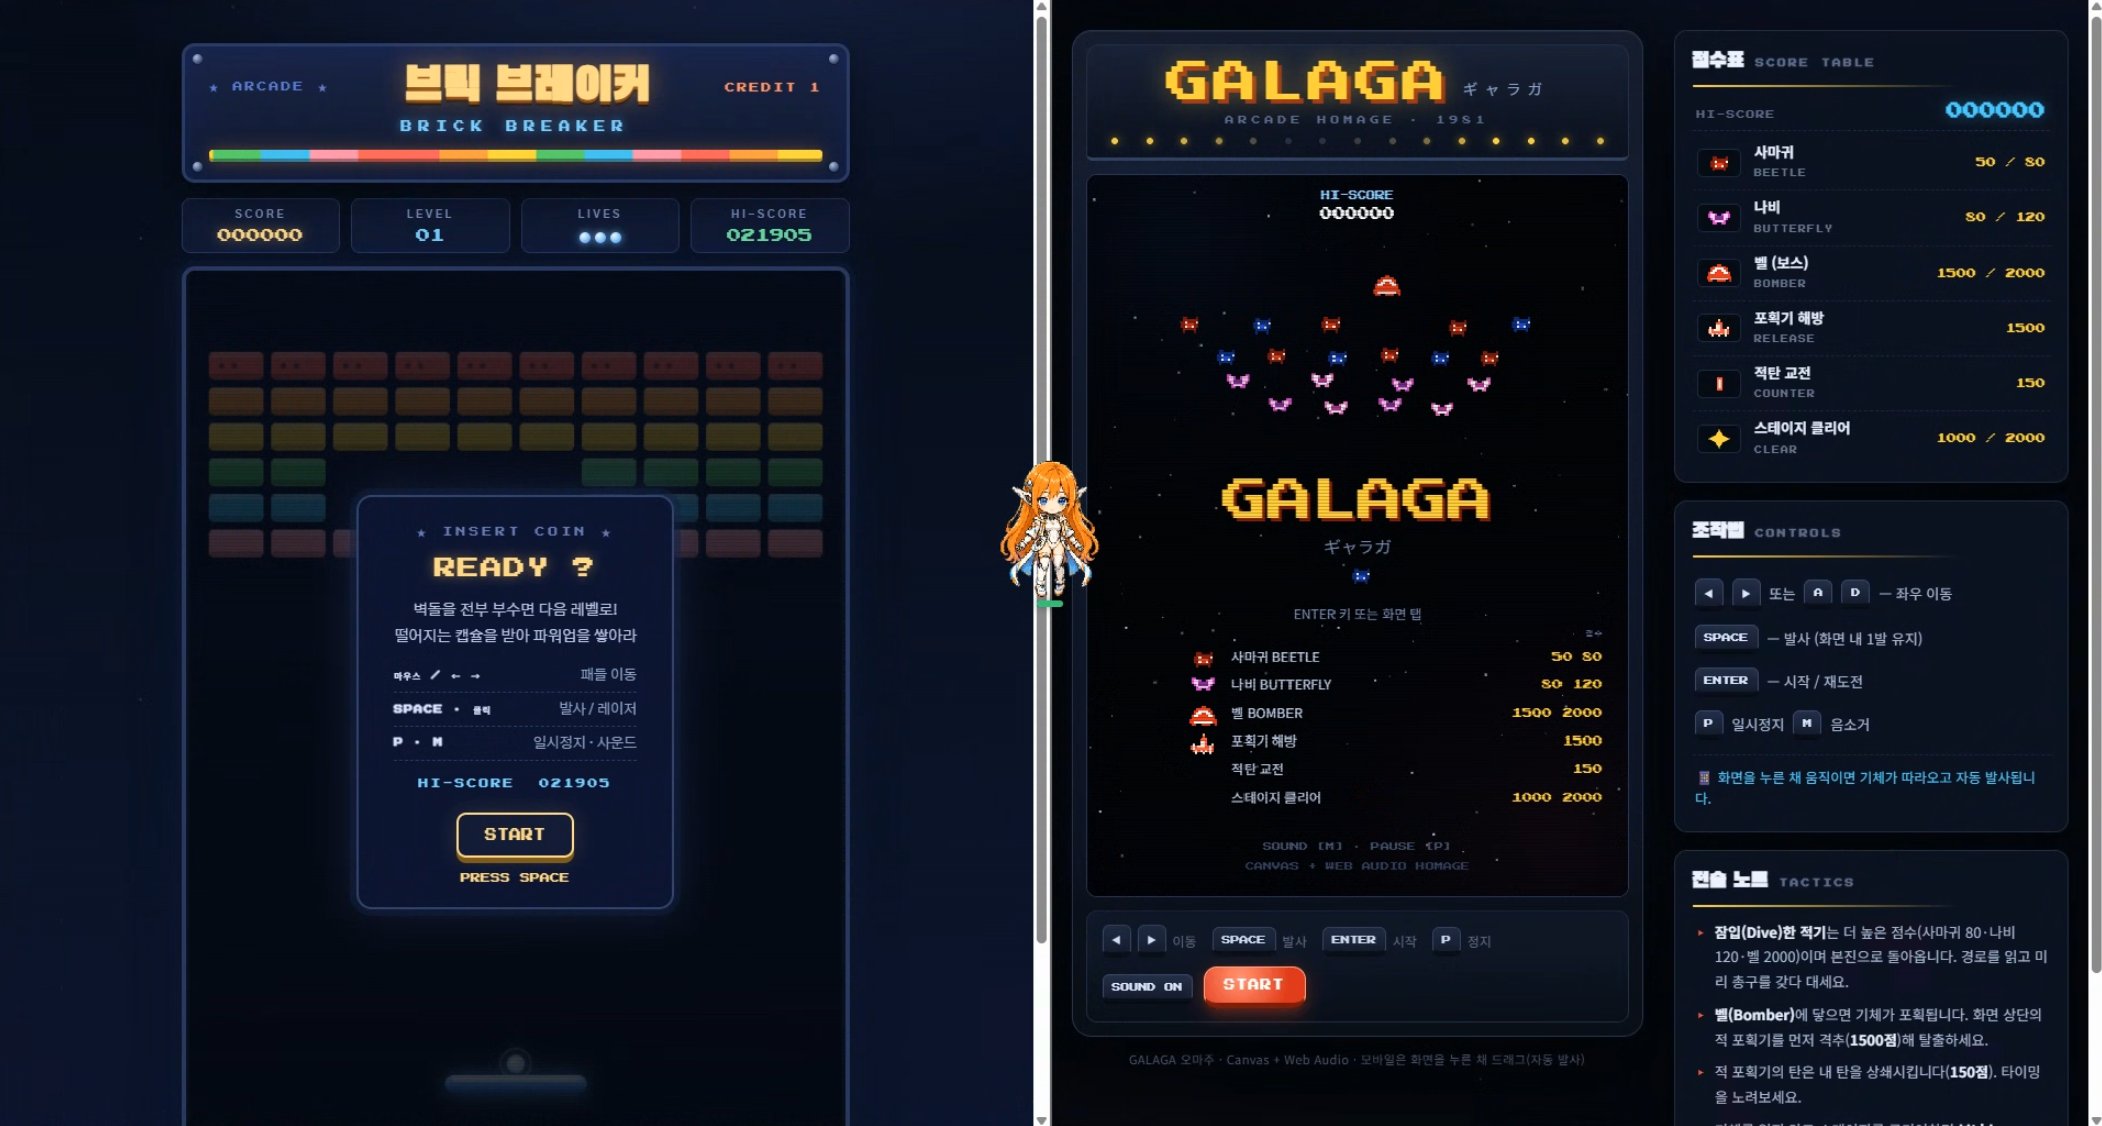
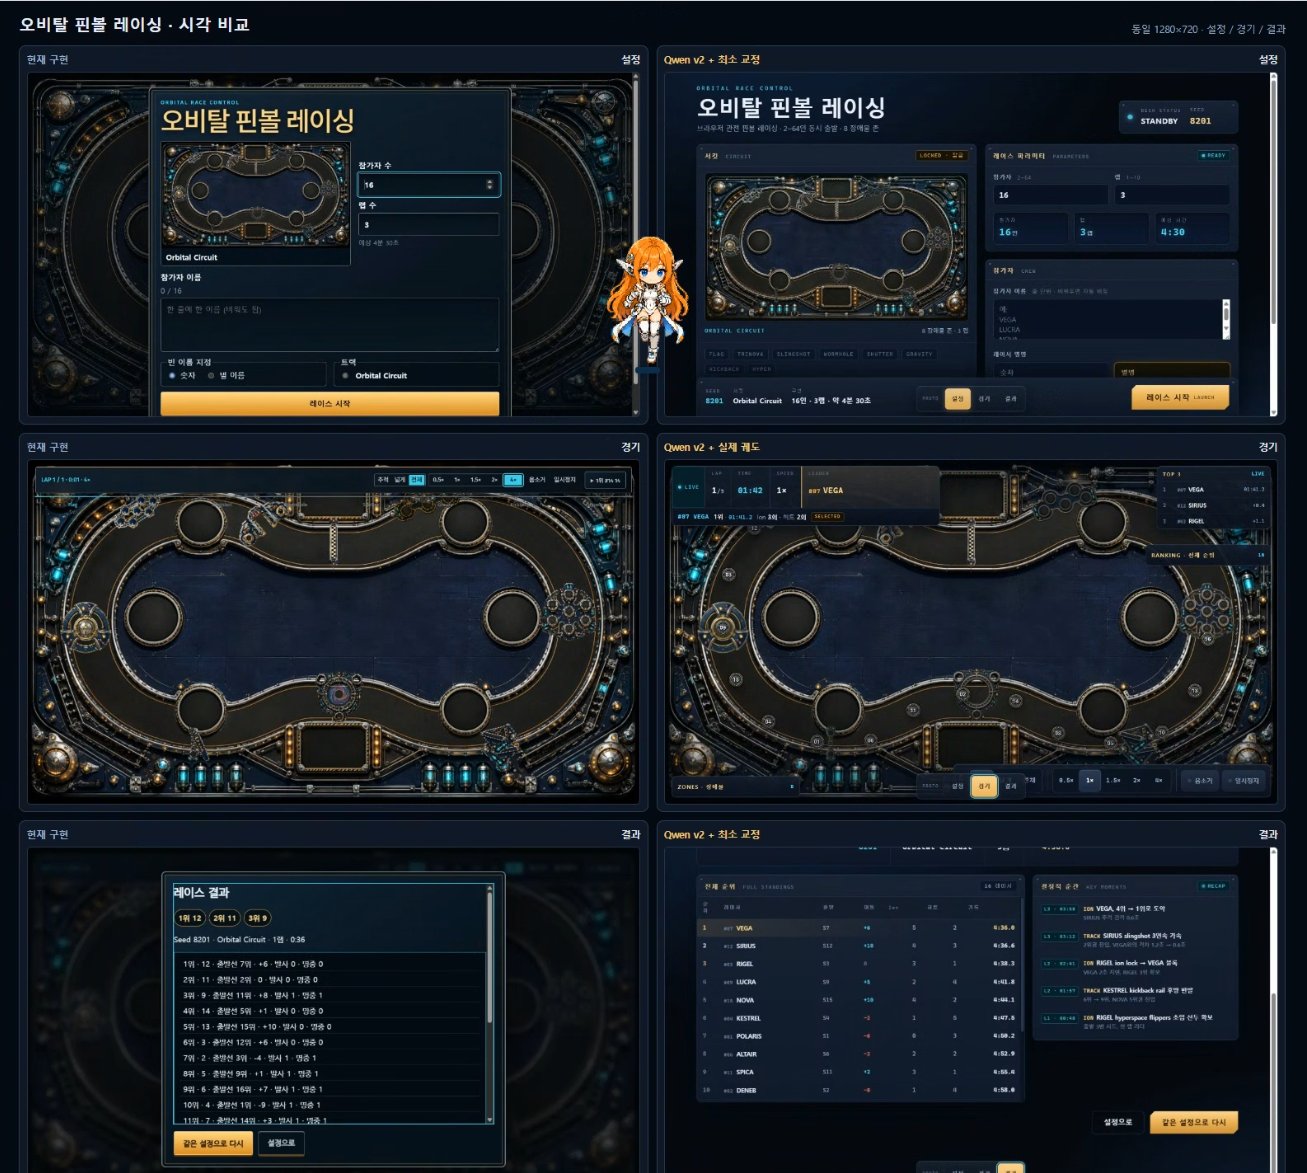
    서브프로젝트 중 하나인 오비탈 핀볼 레이싱 (거의 완성 단계라 곧 공개할께요.)

    왼쪽 Gpt 5.6 Sol + Prodect Desine plugin 오른쪽 Qwen 3.8 27b

    어떤 결과가 마음에 드시나요? https://t.co/b1TpzBZB3j

    Qwen의 디자인을 살리는 협업과 하네스 선택 — X 원문 첨부
    원문 보기
  19. 19
    GPT는 진짜 획기적인 개선 없이는 디자인 영역에 투입할 수 없을듯. 작동만 되면 됬지 디자인이 뭐가 중요해! 의 감성으로 디자인을 계속 수행하니 정말 볼품없는 Slop만 만들어진다. 심지어 Qwen 3.8 27b 로 짜 놓은 개선안들을 오케스트레이션 과정에서 전부 폐기하고 자신의 스타일대로 제작해버림.
    원문 보기
  20. 20
    @CyranoBernstin 자존심을 긁어야 해요? ㅋㅋㅋㅋㅋㅋ 아니 사람이냐곸 ㅋㅋㅋㅋㅋㅋㅋㅋ
    원문 보기
  21. 21

    @firecat03244 계속 만들고 확장하고 만들고 확장하고

    펼치는 능력만큼은 최상위입니다 ㅋㅋㅋㅋ

    원문 보기
  22. 22

    진짜 꼭 필요로 했던 ‘디자인 이해가 높은, 코딩 잘하는 로컬 모델’ 이 나와서 너무 기쁘다.

    다음은 Qwen 3.8 27b + Three.js 로 제작한 장면 https://t.co/IA4nRyCARO

    Qwen의 디자인을 살리는 협업과 하네스 선택 — X 원문 첨부
    원문 보기
  23. 23
    @ramztd 반대로 Gpt 가 못하던 것이었기 때문에…
    원문 보기
  24. 24

    @Sn_Kinos 긁기 + 유니크한 거 만들기

    메모메모

    원문 보기
  25. 25

    Qwen 3.8 27b

    하네스 없이 싱글턴으로 추론 잔득 돌리는게 결과물은 우수하지만, 만약 하네스를 씌워서 에이전틱 워크를 돌리려면

    oh my pi

    를 사용하는게 꽤 괜찮은 사용자 경험을 제공하네요.

    요즘 왜 핫한지 조금 알 거 같음.

    특히 컨텍스트가 클 때, 작업을 오래 할 때 강하네요.

    원문 보기
  26. 26
    @hopex101 가벼운 하네스인 pi를 깎아놓은 거더라구요
    원문 보기
  27. 27
    @aguming_ 헤헤 도움이 조금 됬으면 좋겠네요.
    원문 보기
  28. 28
    @jeongjiwon19511 하네스 유지를 위한 시스템프롬프트가 좀 작은 거 같네요. 그러면서도 하네스가 자체적으로 프롬프트를 잘 잘라서 집어넣도록 설계되어 있어서 opencode 보다 장기 작업시 총 토큰 소비량도 좀 낮았어요.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.8 27b 모델의 디자인 역량이 뛰어나며, 이를 통해 기존 GPT 결과물을 개선하는 성과를 거두셨습니다. 특히 하네스 없이 단일 추론을 사용할 때 결과물이 가장 우수하지만, 에이전트 작업 시에는 oh-my-pi가 장기 작업과 토큰 효율 면에서 긍정적인 경험을 제공했다고 기록하셨습니다. 다만, 특정 모델이 디자인 영역에서 절대적으로 우위에 있다는 주장은 개인의 사용 환경과 작업물에 따라 달라질 수 있는 주관적 경험이므로 추가적인 검증이 필요합니다.

이 글의 기준은 추상적인 모델 순위보다 마음에 든 디자인을 끝까지 보존할 수 있느냐에 있습니다. oh-my-pi의 기능 설명은 도구의 구조를 이해하는 자료이고, 토큰 절감과 결과물의 차이는 Serio님의 작업 기록입니다. 제작을 잘하는 모델과 검토를 맡길 모델을 구분하는 선택도 이 맥락에서 이해할 수 있습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

omp

공식 문서 및 제작자 자료

oh-my-pi 저장소는 코딩 에이전트와 도구 통합을 설명한다. 특정 사용자 환경에서의 토큰 절감이나 디자인 품질을 보장하지 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Qwen 양자화와 VRAM 배분을 고민한 기록

42개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

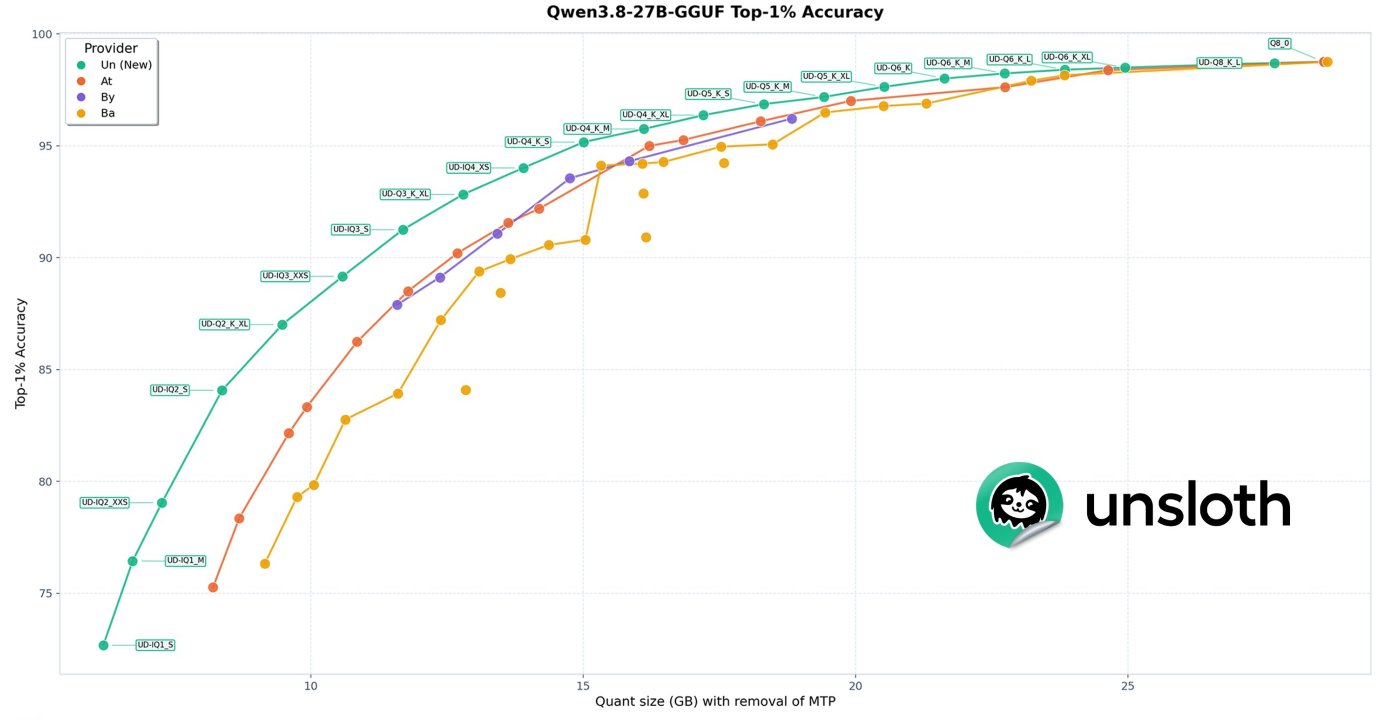
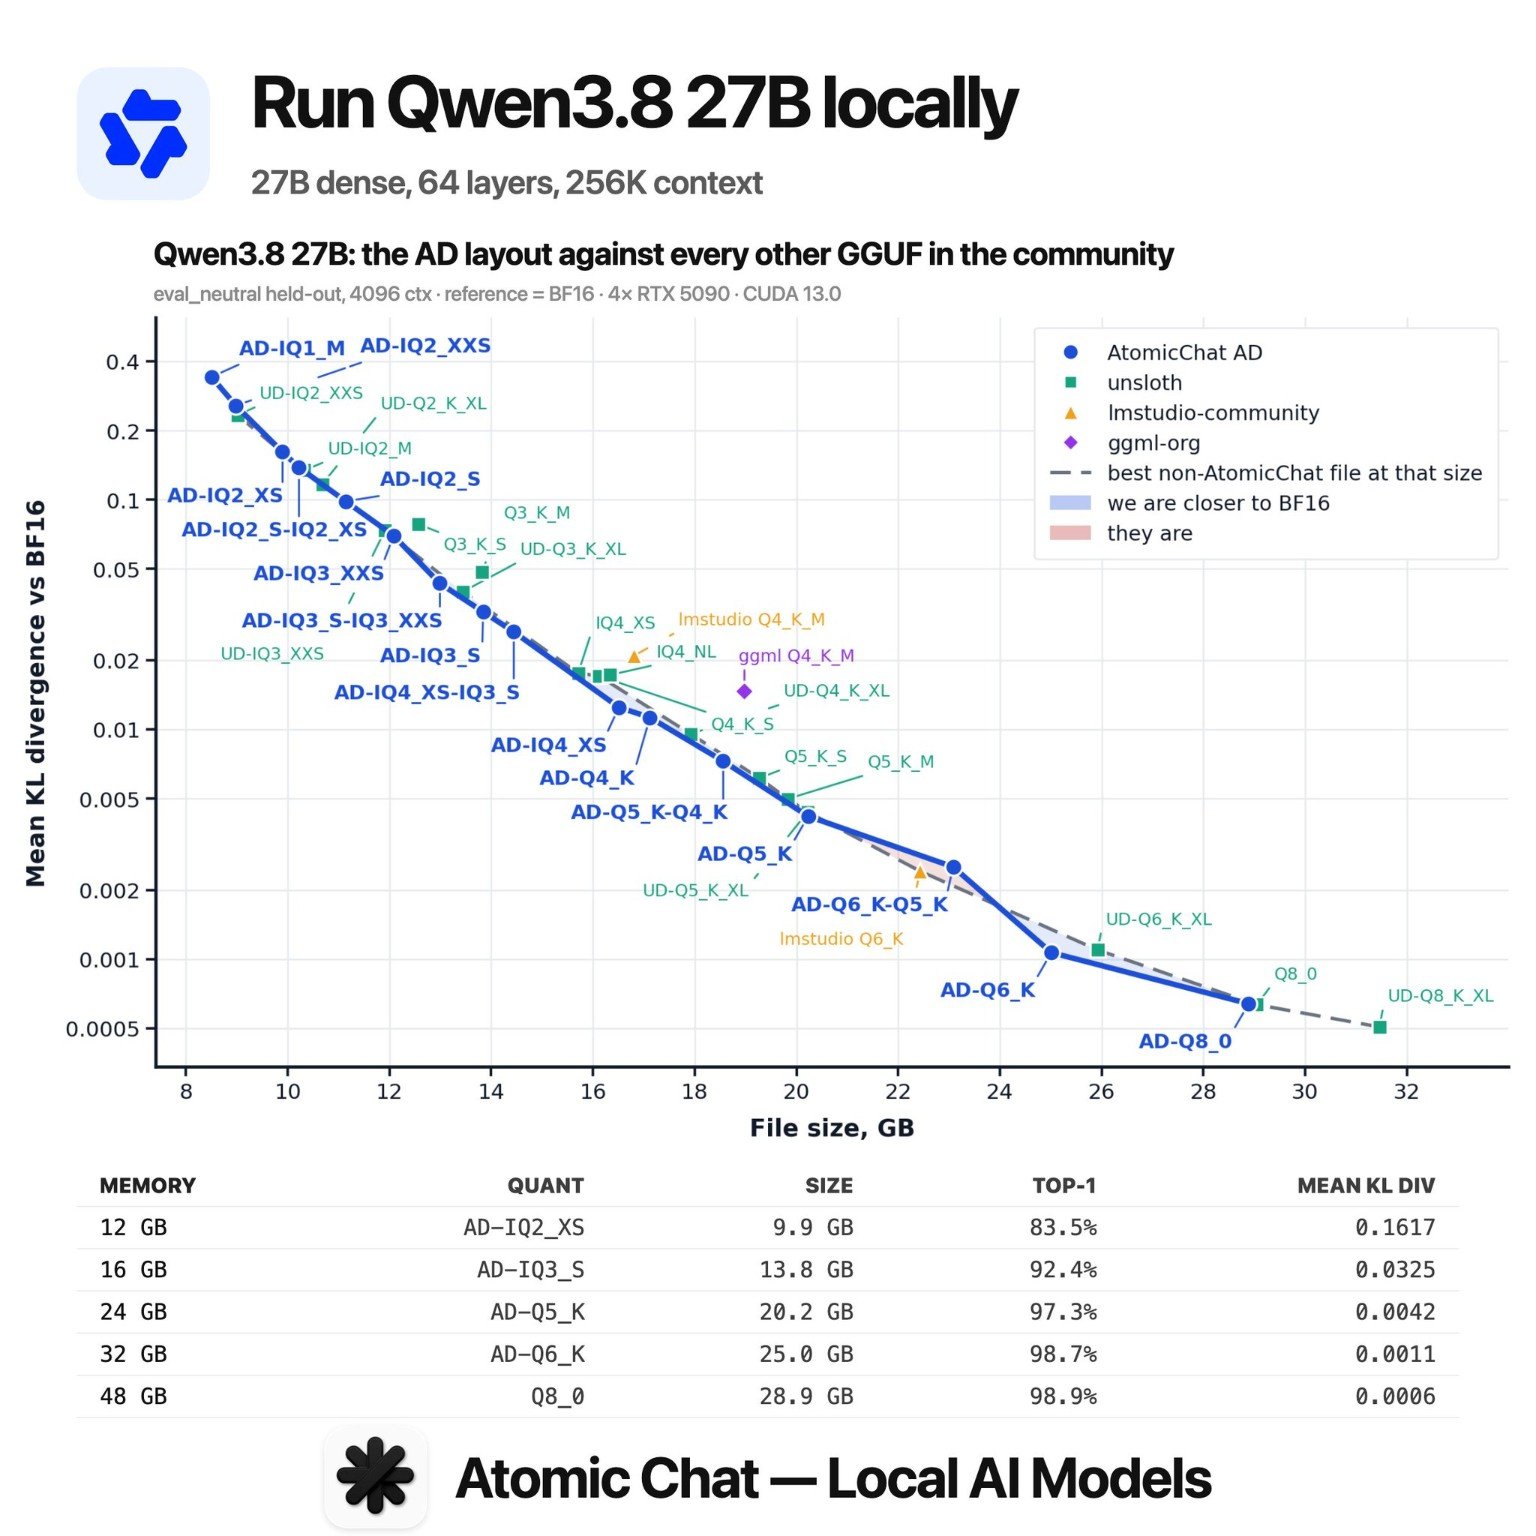
    Qwen 3.8 27b를 쓰시는 분들은 이 이미지 저장해 두시면 좋겠습니다.

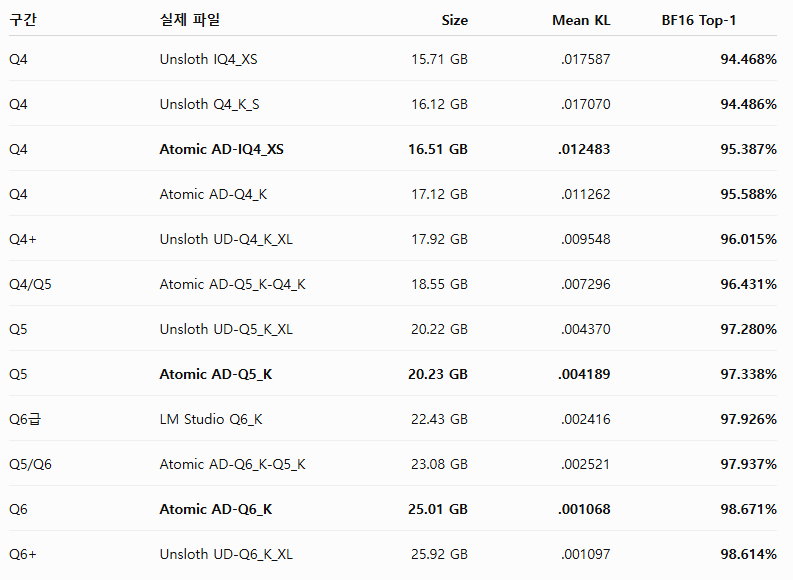
    • 다들 Q4_K_S 많이 쓰실 거 같은데, 여유가 있어 램 용량 4G 정도 더 쓰면 BF 16기준 정확도를 약 3% 더 끌어올릴 수 있습니다.
    • Kv 캐쉬는 Q4가 아니라 Q8을 쓰면 속도와 정확도의 균형을 잡을 수 있습니다. https://t.co/4Hzvfz3NNj
    Qwen 양자화와 VRAM 배분을 고민한 기록 — X 원문 첨부
    원문 보기
  2. 2

    Q4~Q6 양자화 정리.

    스윗스팟은 Q5~Q6 인 듯 합니다. 특히 Vram 램 여유가 있어 Q6를 올릴 수 있으면 베스트네요.

    그 이상은 큰 의미가 없을 듯 합니다. https://t.co/o2nzaAdiNj

    Qwen 양자화와 VRAM 배분을 고민한 기록 — X 원문 첨부
    원문 보기
  3. 3
    @ramztd 정답입니다. 그래픽카드를 포함한 데스크탑이 째로 필요하죠.
    원문 보기
  4. 4

    @ramztd 다만 이게 돌고 돌아서, 맥을 사면 느린 프리필에 환장하고 Dgx Spark 를 사면 낮은 대역폭으로 답답함을 느끼고 그래서 데스크탑+그래픽카드를 사면 Vram 이 부족하고.

    의 무한고리에 갇히게 되죠. 결국 다 사게 됩니다 ㅋㅋㅋㅋㅋㅋㅋㅋㅋ

    원문 보기
  5. 5
    @tinypia 저도 24가 기본이라서요. ;ㅁ; 이리 쥐어짜고 저리 쥐어짜고 있어요.
    원문 보기
  6. 6

    @tinypia 디코드 속도 넉넉하시면 Kv Q4 로 메모리 챙기시는게 좋죠.

    사실 루나맥스가 더 좋죠 ㅋㅋㅋ

    원문 보기
  7. 7
    @ShankhadeepSho1 테스트 결과물을 모아 둔 것 뿐이에요. 저는 Q5 가 시스템 한계네요.
    원문 보기
  8. 8

    Qwen 2.8 27b를

    -3090 단일 Q4 로 40Tok/s 로 쓸 것인가. -3090+추가 Vram(다른 그래픽카드 Split)으로 Q5 Kv Q8로 30Tok/s 로 쓸 것인가.

    흠

    원문 보기
  9. 9

    이미지 출처를 달아놔야 되겠네요.

    https://t.co/Wmjc7Wy3Sk

    인용 문맥: @atomic_chat_hq의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  10. 10
    @fucilator_3000 앗 거기선 Dense 27b 모델 실행이 어려울 거에요. 일단 로컬이 필요하면 gemma4 12b 모델을 써 보는 것을 추천해요.
    원문 보기
  11. 11

    @Abdullah_Cloak 당장 필요하다면 언슬로스의 UD-IQ3_XXS 12G 모델을 쓰면 KVQ4 로 싱글턴 작업 정도는 할 수 있을 여유 메모리를 확보할 수 있을 거에요.

    말씀하신대로 35B Moe 가 조금 더 여유롭습니다.

    원문 보기
  12. 12

    @fucilator_3000 Qwen Base 의 Qwopus 3.5 9b 도 코드품질은 꽤 우수할 꺼에요. (LFM은 제가 안 써봐서 잘 모르겠네요.)

    맞는 모델을 찾는 게 중요해요~

    원문 보기
  13. 13
    @MrWessss 제대로 보신 게 맞습니다 :)
    원문 보기
  14. 14
    @moppelmat 하하하 맞아요. 하지만 그 시스템을 구성하려면 보드도 지원해야 하니까요.
    원문 보기
  15. 15
    @Zila_Lava 지식이 갈수록 저렴해지고 있어요~
    원문 보기
  16. 16
    @thinkgod123 부럽당 전 3090이 메인이라 ㅠ_ㅠ
    원문 보기
  17. 17
    @Zila_Lava 지식의 축적과 경험의 방식은 과거랑 또 다른 변화를 겪을 것입니다. 지식의 New Era 인 것이죠.
    원문 보기
  18. 18
    @Bitcopath 7900XTX 면 24g Vram 이니 1기가를 알뜰살뜰하게 쓸만한 가치는 있는 것 같습니다. 일단 모델 양자화 수준을 낮추는것보단 Kv 캐쉬쪽이 효과가 더 좋은 듯 합니다.
    원문 보기
  19. 19
    @InvesterTurtle 아닙니다. 모델을 올려서 쓸 수 있는 모든 사용자에게 의미가 있습니다.
    원문 보기
  20. 20
    @Edward69544044 모델을 올릴 수만 있다면요. 다만, 에이전틱 작업을 위해선 컨텍스트 크기가 중요하다보니 마냥 올리는 것은 부정적입니다.
    원문 보기
  21. 21
    @cgfixit @grok 가급적 ollama 보다는 llama.cpp 를 직접 쓰는 것이 좋습니다. 그게 불편하면 lmstudio 나 unsloth studio를 쓰는 걸 권합니다.
    원문 보기
  22. 22원문 보기
  23. 23

    @AFGroyper9000 그 제품은 토큰 디코드가 문제라서 모델 자체를 버거워 할 껍니다. 사실 제품 설계가 좀 잘못 되었다고 생각합니다.

    그래도 쓴다면 그냥 Q4 를 써보시는 걸 추천합니다.

    원문 보기
  24. 24
    @Shoonee27 Q3 라도 꽤 성능이 좋습니다. 양자화 내성이 꽤 좋은 모델입니다.
    원문 보기
  25. 25
    @yetanotherxxx 해당 모델이면 양자화는 Q6도 괜찮겠지만, 디코드와 프리필에서 꽤 어려움을 겪으실 수 있을 겁니다.
    원문 보기
  26. 26

    @TsengSR 아 다들 기준값은 Q4_K_S입니다.

    말씀하신 Q4_K_XL은 BF16 적합성이랑 용량적 측면에서 Q5 보다 매력이 조금 떨어지지 않나 추측해 봅니다.

    원문 보기
  27. 27원문 보기
  28. 28
    @Zila_Lava 완전 동의합니다. 일론의 바벨탑은 전 트위터를 하나로 묶었습니다. 그렇다고 트위터를 X로 부르고 싶진 않지만. :)
    원문 보기
  29. 29원문 보기
  30. 30
    @Mikerhinos 곧 나온다고 생각하니 기다려 보세요. 저도 꽤 기대하고 있습니다.
    원문 보기
  31. 31
    @YourLastAlex 컨텍스트를 얼마나 어떻게 배치하느냐에 따라 좀 다릅니다. 24G Vram 으로 장기작업에 배치할거면 Q4나 Q3가 나을 수 있습니다. 정확도 3% 정도 손해보는 대신 컨텍스트와 KV캐쉬 그리고 속도에서 이득을 봅니다.
    원문 보기
  32. 32
    @vladaman Vram 은 한정적이니까요. 파레토 최적점은 로컬에도 적용됩니다.
    원문 보기
  33. 33
    @QuantumFlux36 Q6를 써 보시면 될겁니다. 문제 없이 풀컨텍스트에 도달할 겁니다.
    원문 보기
  34. 34

    @asdasdqweqaasd 전 개발서버쪽은 Lmstudio에서 스플릿레이어가 작동을 안해서 말씀하신 수준의 세팅을 하고 있고, Api 머신에선 작동을 해서 Q5 Kv8 풀컨텍스트로 사용하고 있습니다.

    Qwen 3.8 27b 는 야생마 모드 (하네스 개입 최소화) 로 둔 뒤 결과를 감사하는 방식의 사용이 지금으로선 좋아 보입니다.

    원문 보기
  35. 35

    @TM0fo 앗 못도와드릴 거 같은데요. 780M 의 토큰 생성량이 기대 이하라서.

    토큰 생산이 지지부진하시면 Rocm 대신 불칸을 써 보시는 것도 방법이긴 합니다. 라데온쪽은 Rocm 컨트롤이 힘들었어요.

    원문 보기
  36. 36
    @T3rceiraConta @Abdullah_Cloak Q3의 BF16 적중률이 꽤 높은 수준이라 이번 모델에선 Q3 도 추천 영역에 들어갈 거 같네요.
    원문 보기
  37. 37
    @808emanresu 하지만 Kv 캐쉬는 컨텍스트 증가에 따른 메모리 사용량의 주범이 되기 때문에 적절한 양자화는 필요하죠. Bf16으로 컨텍스트를 다 쓸 수 있으면 모르겠습니다만…
    원문 보기
  38. 38
    @asdasdqweqaasd 네 24기가에선 풀컨텍스트는 지금 공개 버전들에선 기리기리하게 어렵습니다. 그래서 풀컨텍스트 찍으려면 차라리 Q3로 다운을 해도 괜찮을 듯 합니다.
    원문 보기
  39. 39

    @AFGroyper9000 그정도까진 아니지만;;; 128G 라는 큰 Vram을 Gpu의 디코드 속도가 받쳐주지 못해요.

    하지만 못 돌리는거랑 , 돌릴 수 있는 건 다르니까요.

    원문 보기
  40. 40

    @TsengSR Q4_K_L 에 풀컨텍스트 MTP 다 넣으면 24G Vram 에 안올라가는 건 매 마찬가지라 Q4_K_S 가 일단 기본값이겠죠.

    앞으로 더 많은 개선 방법이 올라오리라 봅니다.

    원문 보기
  41. 41
    @moppelmat LOL 할 수 있는 최선을 다 하셨군요 ㅋㅋ NVME에 확장키트 ㅋㅋㅋ
    원문 보기
  42. 42

    원조 GGuf 맛집 언슬로스가 Qwen 3.8 27B를 한번 더 개선했네요. 이정도면 새로 받으시는걸 추천합니다.

    특히 양자화 수준이 높은 모델들의 성능 개선폭이 크네요. https://t.co/S9680u6YQv

    Qwen 양자화와 VRAM 배분을 고민한 기록 — X 원문 첨부

    인용 문맥: @UnslothAI의 인용 원문 (Serio 작성 글과 구분)

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.8 27B 모델을 로컬 환경에서 운용하며 양자화 수준과 VRAM 배분 사이의 최적점을 찾는 과정을 기록하셨습니다. Unsloth의 공식 문서가 27B 모델의 양자화와 실행 조건을 안내하고 있다는 점은 확인되나, Serio님이 제시한 구체적인 정확도 향상 수치나 장비별 권장값은 개인의 실험 결과이므로 독립적인 검증이 필요합니다. 특히 KV 캐시 양자화 설정이 속도와 정확도의 균형을 잡는다는 주장은 공식 자료로 확인되지 않은 경험적 기록입니다.

여기서 중요한 것은 하나의 양자화 수치가 정답이라는 결론보다, 모델 가중치와 KV 캐시가 같은 메모리 안에서 자리를 나눠 쓴다는 운용상의 고민입니다. 구체적인 속도와 품질 평가는 당시 설정과 함께 읽어야 합니다. 메모리에 올라간다는 조건과 원하는 길이의 작업을 무리 없이 처리한다는 조건을 나눠 보는 데 도움이 되는 기록입니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

qwen

공식 문서 및 제작자 자료

Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

같은 공룡 게임을 모델과 하네스별로 만들어 보니

19개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    ㅋㅋㅋㅋ 아니 이거 왠지 ㅋㅋㅋㅋㅋ 제목을

    ‘로컬 Ai 가 Gpt 따는거 보여줌’

    이라고 짓고 싶어지는데요?

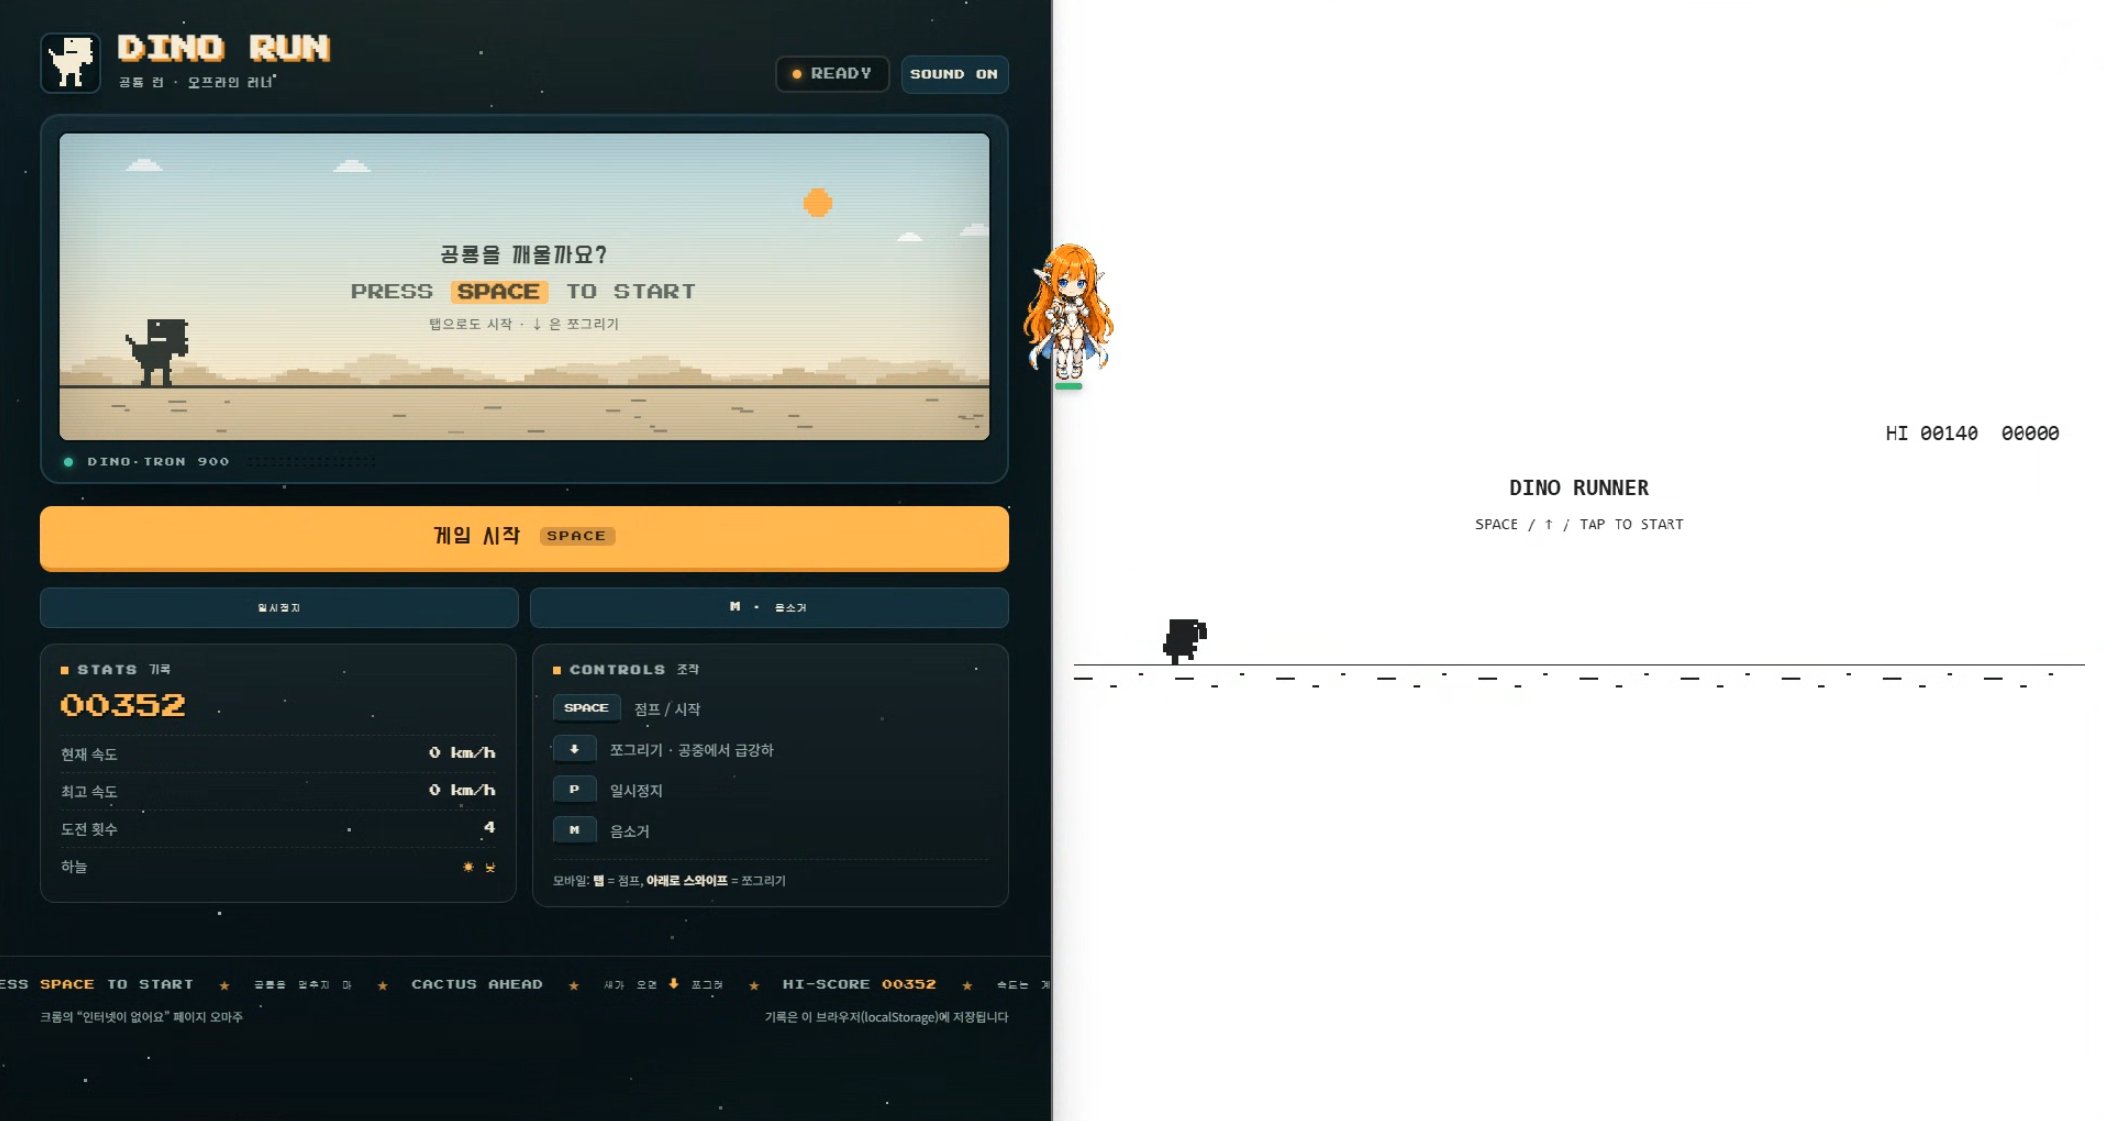
    왼쪽 Qwen 3.8 27b (하네스 없음. Lmstudio에서 바로출력) 오른쪽 Gpt 5.6 Sol (high+superpower)

    왼쪽은 싱글턴이고 오른쪽은 슈퍼파워 리딩에 맞췄는데 코드 량 차이가 2.5배. https://t.co/CsIzAjqvgH

    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2

    결과물.

    왼쪽 Qwen 3.8 27b (하네스 없음. Lmstudio에서 바로출력) 오른쪽 Gpt 5.6 Sol (high+superpower)

    모델 간 해석 차이 + Qwen 이 만든 쪽이 조금 오류가 있긴 한데 ㅋㅋㅋ 이거 왠지 Gpt 5.6 Sol이 로컬 모델한테 디자인 벤치 따이는 결과가 나올지도 모르겠다는 생각이 아주 조금 듭니다. https://t.co/qA89WoIorq

    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  3. 3
    @ramztd 사셔도 될거같네요.
    원문 보기
  4. 4

    @ROUT_DEVELOP 사실 일부러 보여드린 것도 있어요 ㅋㅋㅋㅋ

    Gpt Sol은 원작 구글 공룡 게임에 가까워지려고 노력했고, Qwen 3.8은 자기가 할 수 있는 가장 우수한 공룡게임을 만들려고 했죠.

    그래서 더 재미있는 결과물이라 생각합니다. 매번 새 모델 나올때마다 공룡부터 짜 보는 이유에요.

    원문 보기
  5. 5

    테스트 2

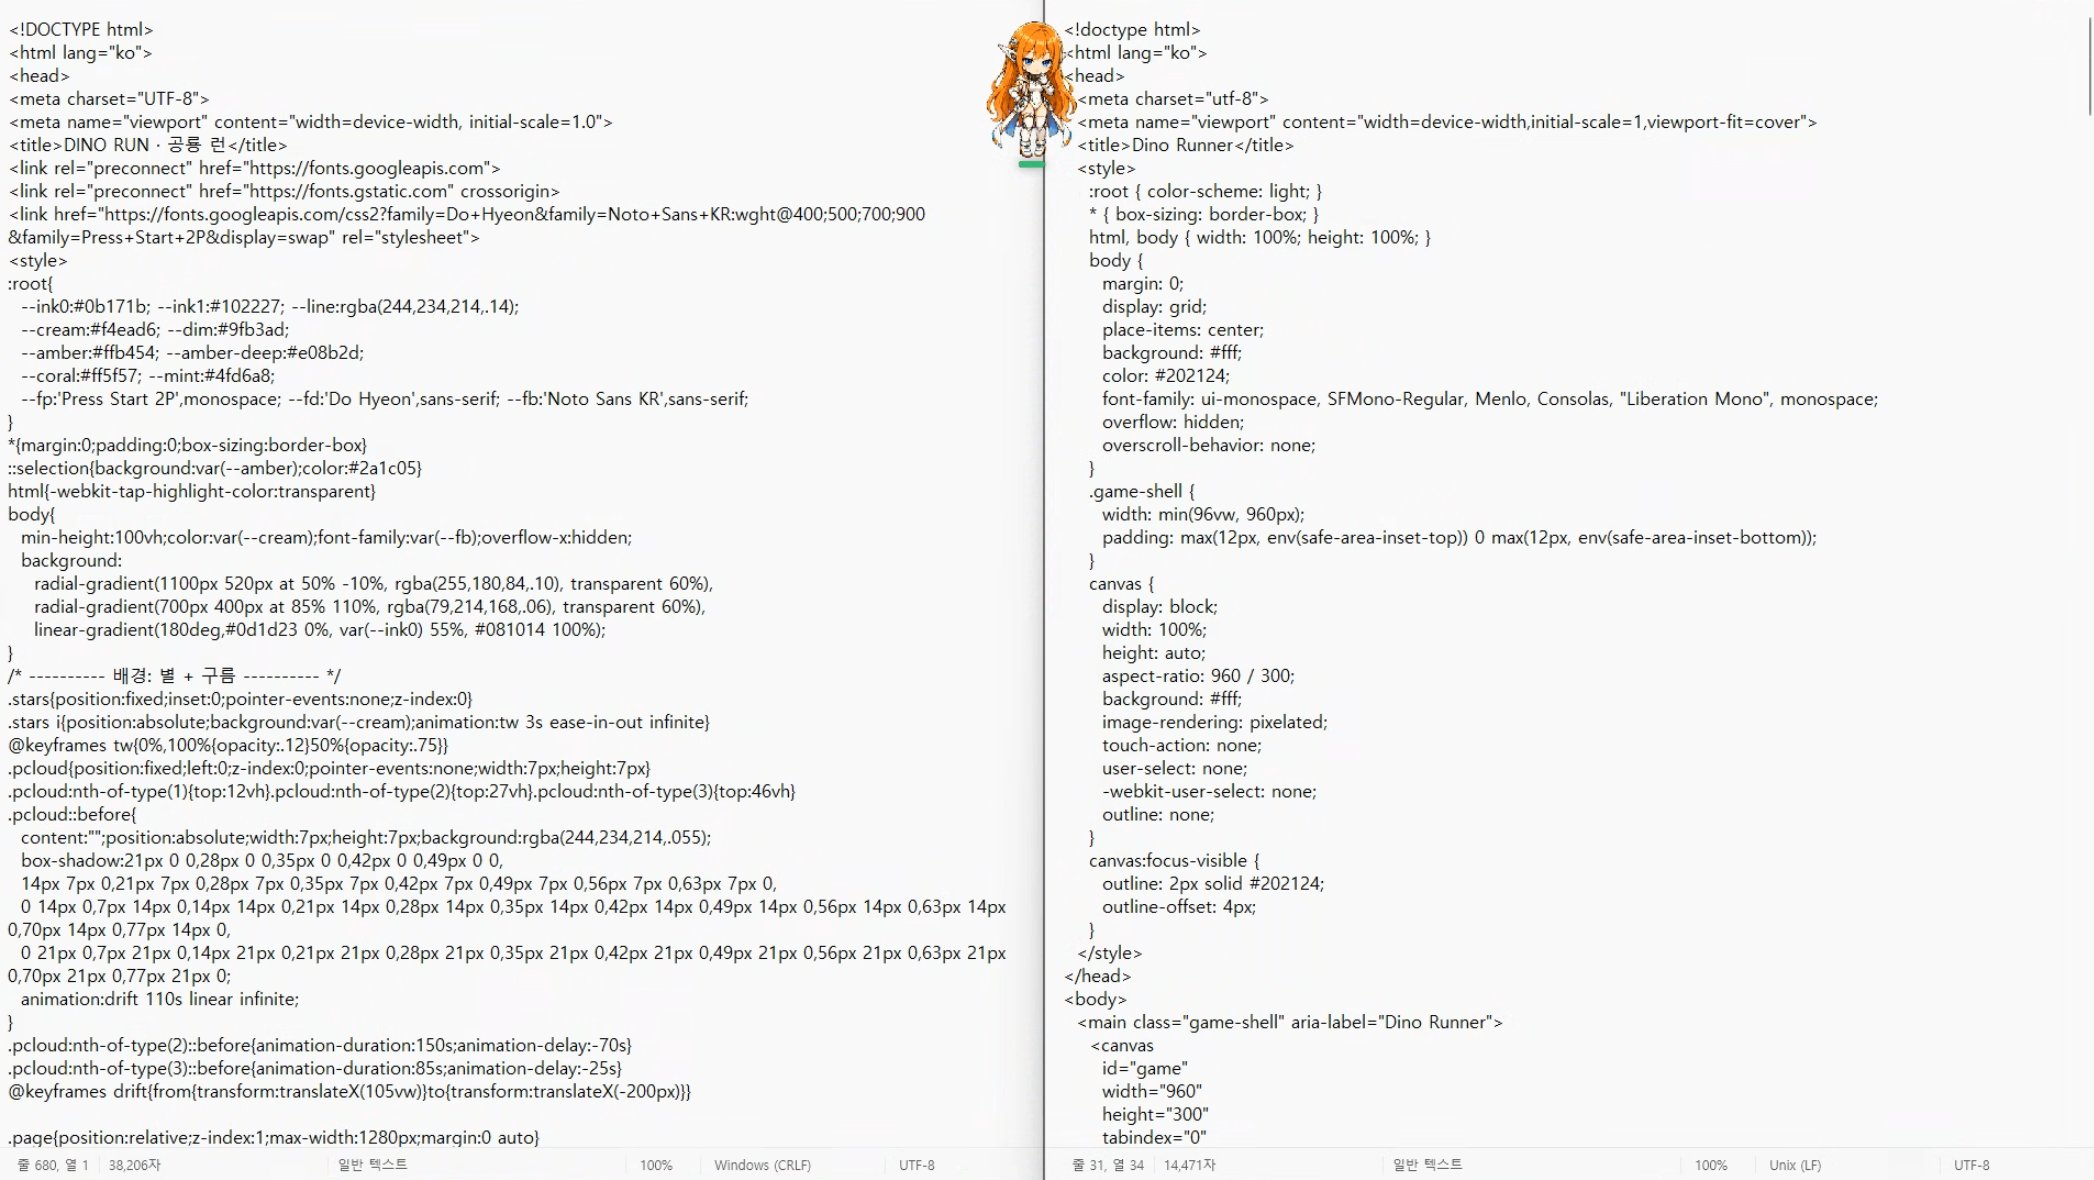
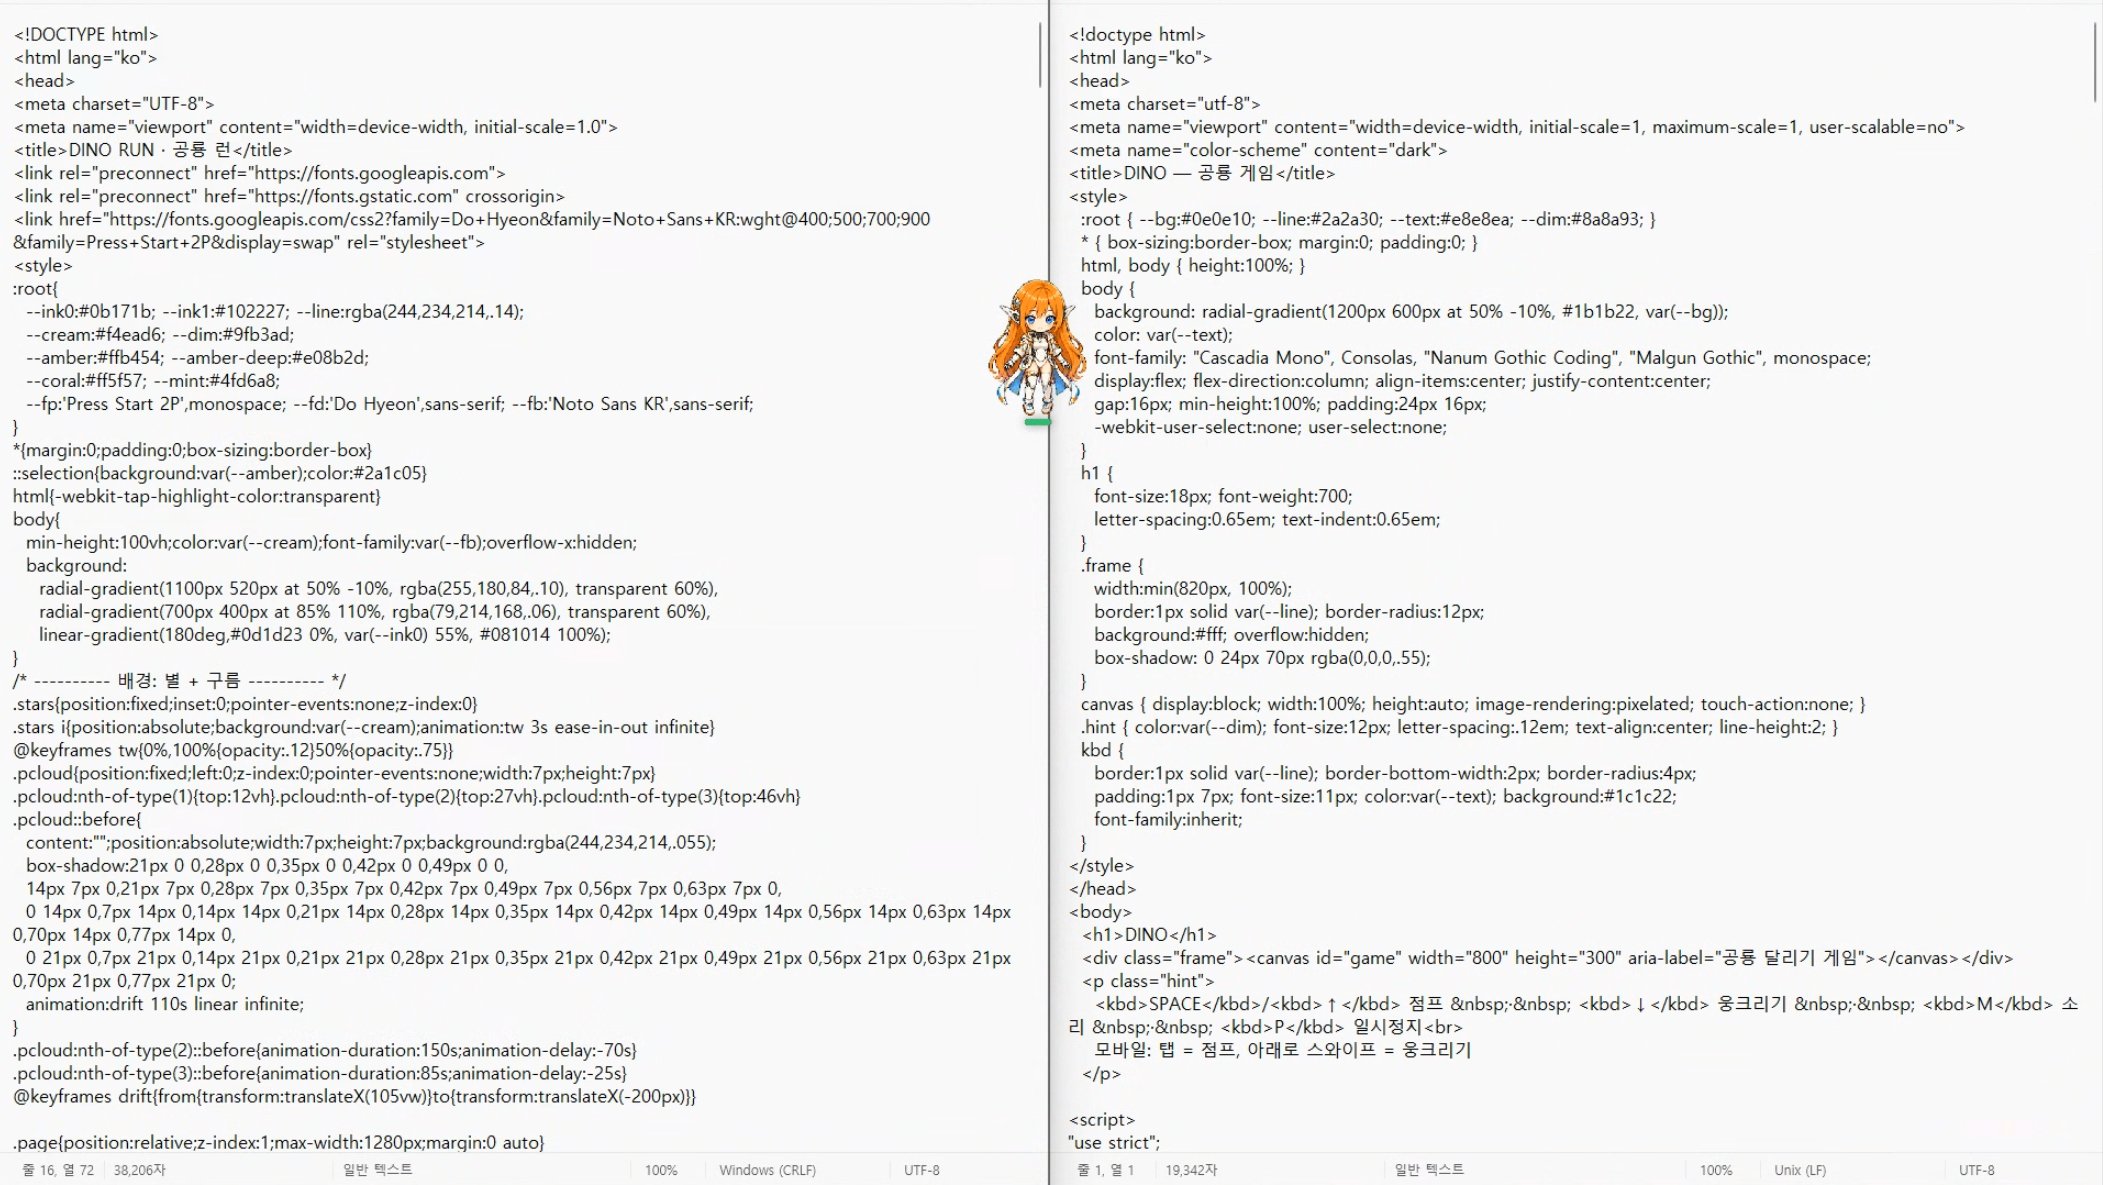
    < 왼쪽 Lmstudio chat
    38,206자

    오른쪽 > Qwen 3.8 27b + Opencode + OMO + SuperPower /goal 구글 공룡 게임 만들어줘 19,342자 https://t.co/DKGhRxo4AA

    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  6. 6

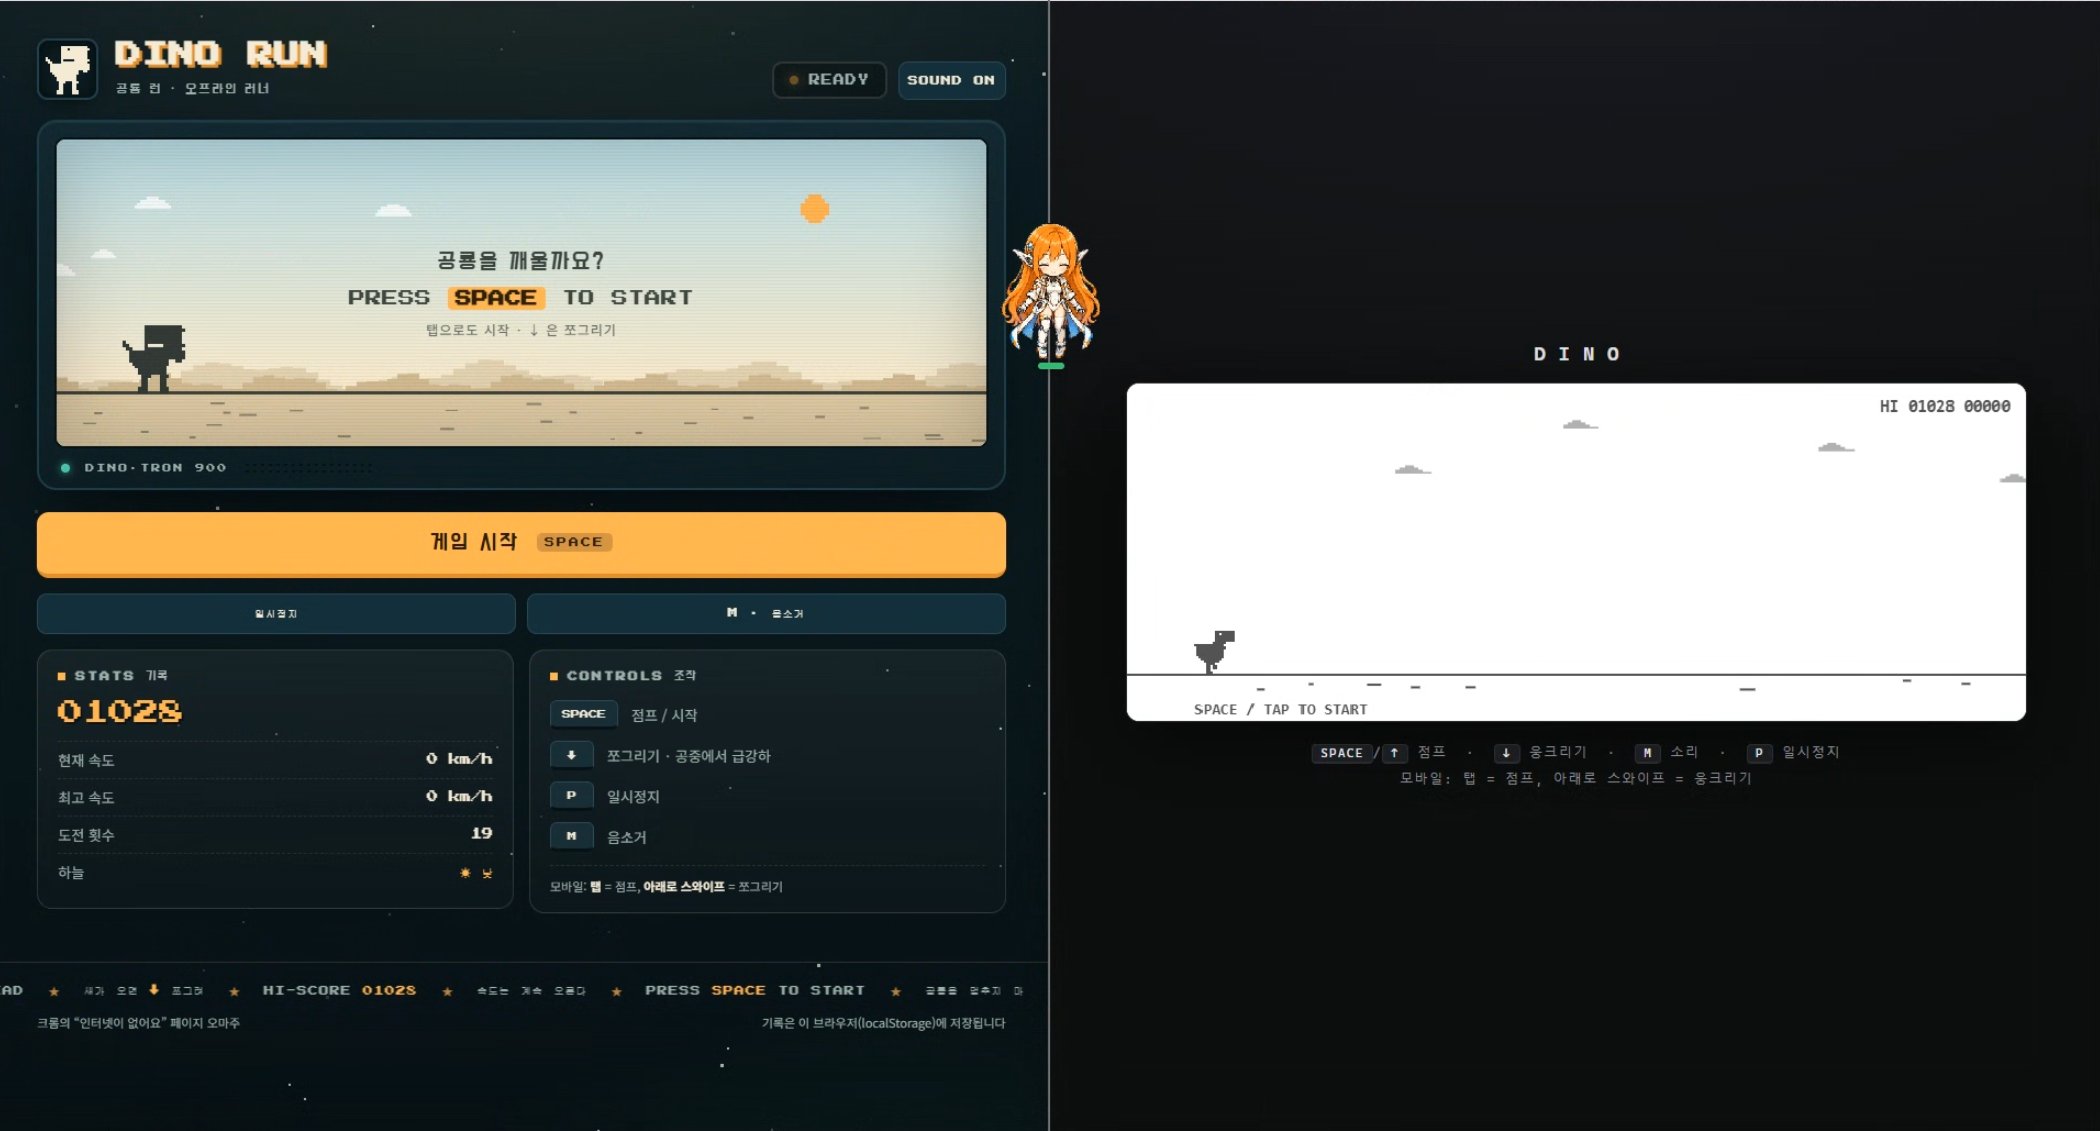
    결과물 : Qwen 3.8 27b

    < 왼쪽 Lmstudio chat 21분 29초

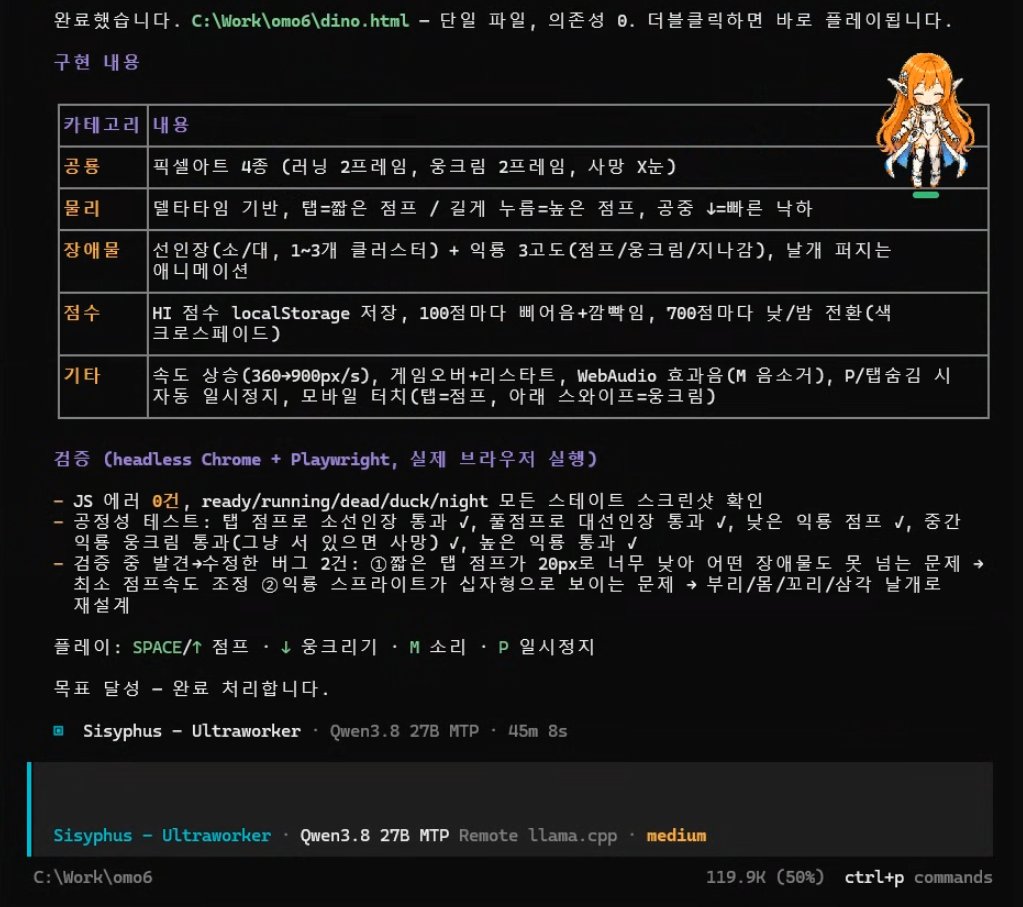
    오른쪽 > Qwen 3.8 27b + Opencode + OMO + SuperPower 45분 8초

    뭐가 나은지는 각자 다르지만 하네스를 거친 게 좀 더 ‘구글 공룡 게임’ 에 가까워져 있습니다. https://t.co/5fUBfGKJZD

    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  7. 7
    문제는 작업시간과 컨텍스트 사용량이 ㅋㅋㅋ Qwen 3.8 27b에 어울리는 하네스가 무엇일지 좀 고민되네요 https://t.co/TNuuStHl7X 같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  8. 8

    Qwen 3.6 27b를 깡으로 일 시키면 재미있는 결과가 나오는데 설치해둔 하네스를 끼워주니 제작시간도 더 걸리면서도 심심한 결과가 나오는 상황.

    제대로 쓰려면 큰 제악 없는 가벼운 하네스를 찾아야 되는 상황에 직면했네요.

    원문 보기
  9. 9
    @ramztd 좀 더 써봐야겠는데 흠… 재미있는데 고민도 많아지네요 ㅋ
    원문 보기
  10. 10
    @simpletrouble6 헤르메스 추천 고맙습니다. 참고해 보겠습니다. 감사합니다.
    원문 보기
  11. 11

    @byeolbyeol_e 하네스 많이 쥐어줘서 토큰 낭비하는 것보다 깡통째로 일을 시키는건 어떨까? 를 고민하고 있어요. 깡통도 결과물이 괜찮아서요.

    오히려 하네스가 모델의 자율성을 좀 많이 제한하는 느낌도 있구요.

    원문 보기
  12. 12

    @park_jinwoo https://t.co/6vkINwk6F7

    안그래도 오마이파이가 요즘 평가가 좋아서 고민입니다.

    원문 보기
  13. 13

    @park_jinwoo 전 그렇게 설정해 둔 하네스가 둘 (Opencode / codex) 가 있어서 반대로 고민하고 있습니다.

    가벼운 하네스를 새로 하나 짜야 하나 아니면 기존 하네스에 붙여서 굴려야 하나 ;ㅁ;

    원문 보기
  14. 14
    @bitbitebyte 충분히 그러셔도 됩니다. Q4 양자화 좋아요.
    원문 보기
  15. 15
    @thinkgod123 끄아아 400만원 할 때 사둘걸! ㅋㅋㅋㅋ
    원문 보기
  16. 16
    @bitbitebyte 하네스가 없는 상황에서 창의력과 파고드는 능력이 꽤 뛰어난 편이에요.
    원문 보기
  17. 17

    @transurfer Pi 가 에이전트 하네스 중에선 제일 가볍다는 말이 있어서

    오마이파이 썼다가 실망하고

    파이 자체를 써볼까 아니면 이쪽에 잘 되있다는 kimi Code를 써볼까 또 고민하고 있습니다.

    원문 보기
  18. 18

    @ririnto_ri omo가 초기형 하네스다보니 아무래도 기능이 많지만 제악도 많다는 생각이 듭니다.

    아끼는 하네스였는데 이젠 좀 놔줄 때가 되지 않았나 싶기도 하네요.

    원문 보기
  19. 19

    @simpletrouble6 @superalesha 고맙습니다.

    밤에 Oh my pi 를 시도해 봤는데 결과가 좋지 않았거든요. 지금은 Codex 에 심플 워커 플러그인을 만드는 것을 도전해 보고 있는데, 딥시크 하네스도 도전 목록에 넣어 두겠습니다.

    감사합니다.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.8 27b 모델을 중심으로, 하네스 적용 여부에 따른 구글 공룡 게임 구현 능력을 비교 실험하셨습니다. 하네스가 없는 상태의 Qwen 3.8 27b는 창의적인 결과물을 냈으나, 특정 하네스를 적용했을 때 오히려 제작 시간이 늘어나고 결과물이 단조로워지는 현상을 발견하셨습니다. 다만, 이러한 결과가 모델의 절대적인 성능 지표인지 혹은 특정 하네스와의 궁합 문제인지에 대해서는 추가적인 확인이 필요합니다.

같은 게임을 시켰는데 지침을 더한 쪽이 항상 나아지지는 않았다는 점이 흥미롭습니다. 그렇다고 모든 하네스가 불필요하다는 결론보다는, 이 과제에서 추가 지침이 무엇을 도왔고 무엇을 제한했는지를 따져 볼 기록입니다. 첨부한 결과물을 함께 보면 속도와 디자인 취향을 구분해서 판단하기도 쉬워집니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

qwen

공식 문서 및 제작자 자료

Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.

primary-source