로컬 LLM

로컬 LLM 실험실

로컬 LLM 서빙, 모델 설정, GPU/VRAM, 양자화, 실행 환경 관련 글을 모았습니다.

THREAD ESSAYX THREAD ARCHIVE

같은 공룡 게임을 모델과 하네스별로 만들어 보니

19개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    ㅋㅋㅋㅋ 아니 이거 왠지 ㅋㅋㅋㅋㅋ 제목을

    ‘로컬 Ai 가 Gpt 따는거 보여줌’

    이라고 짓고 싶어지는데요?

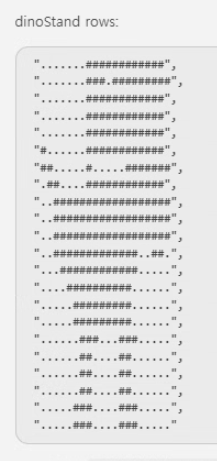
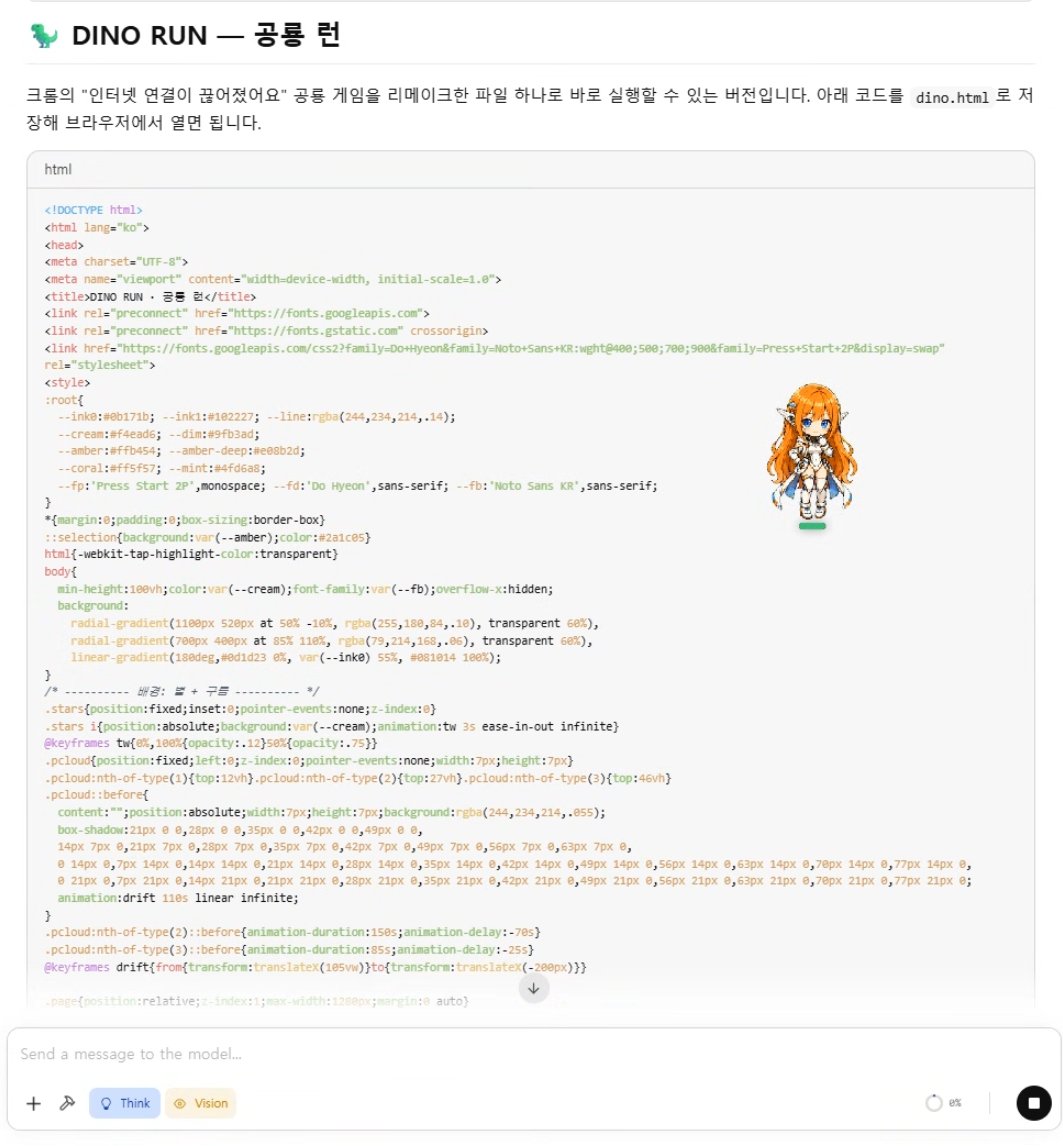
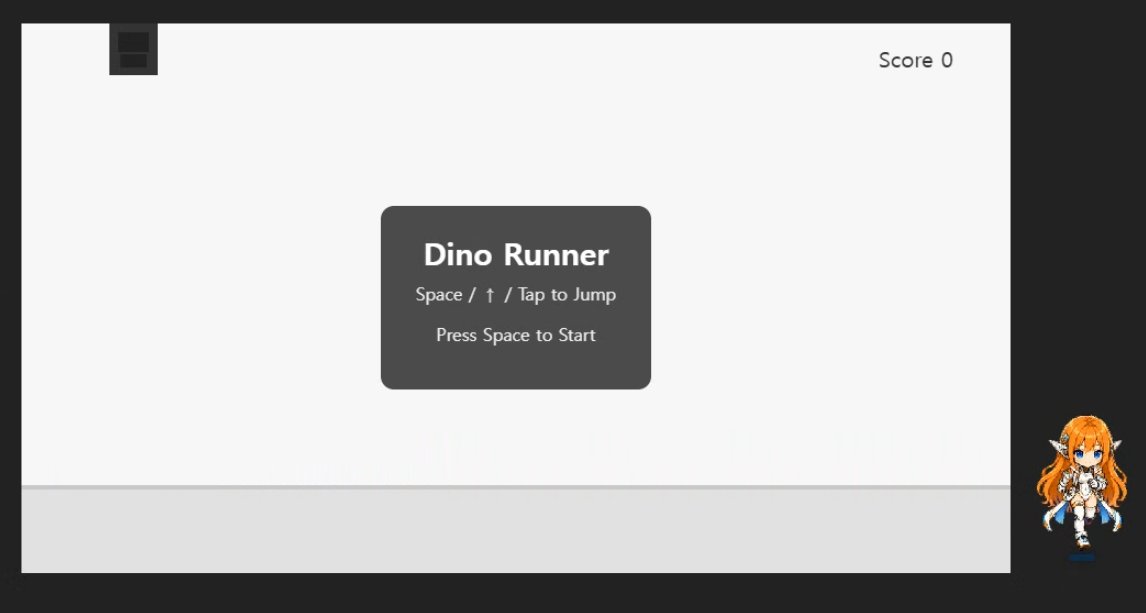
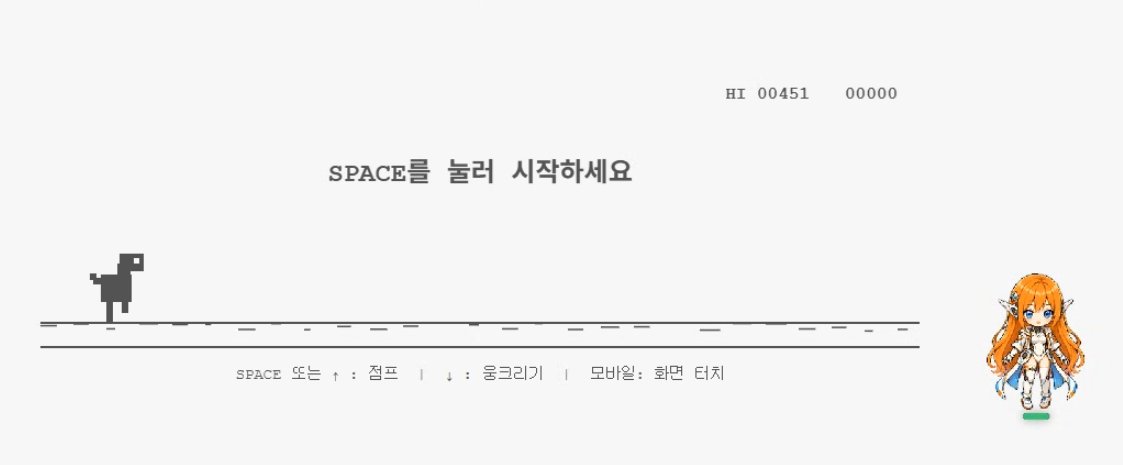
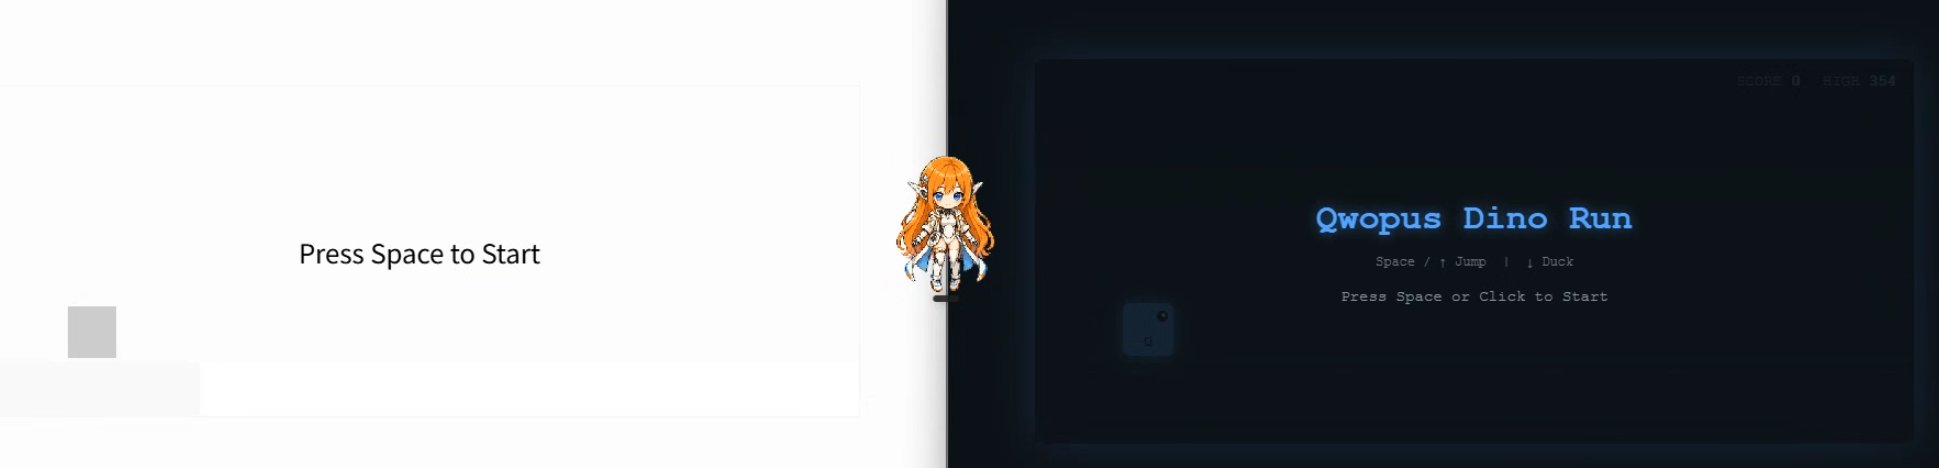
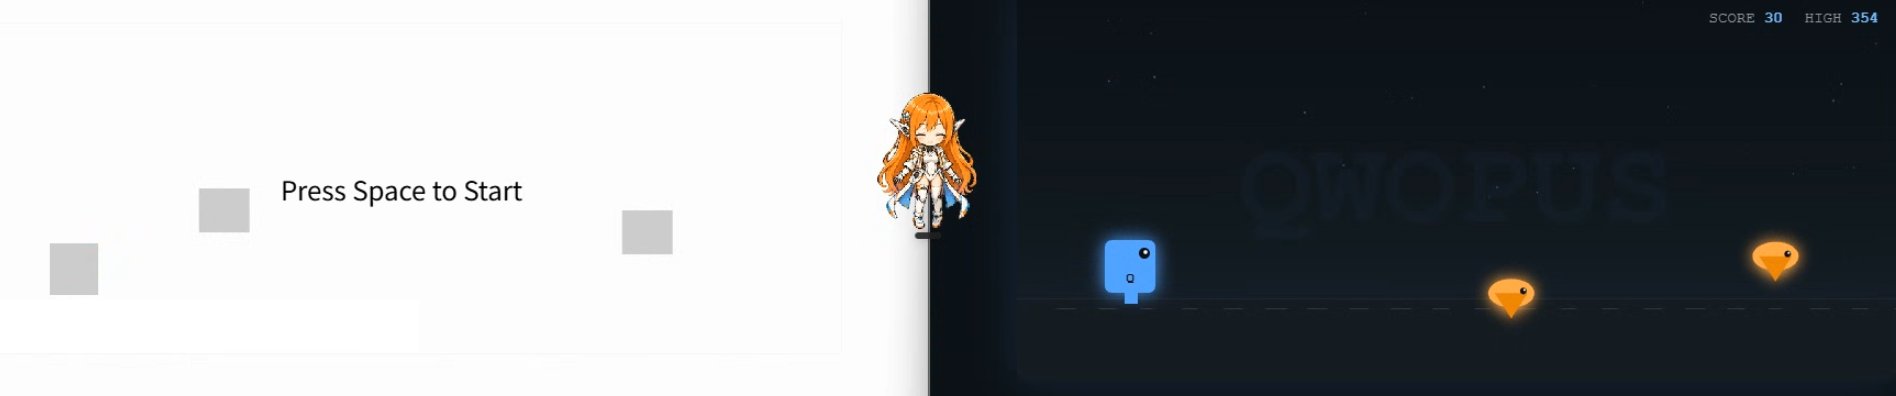
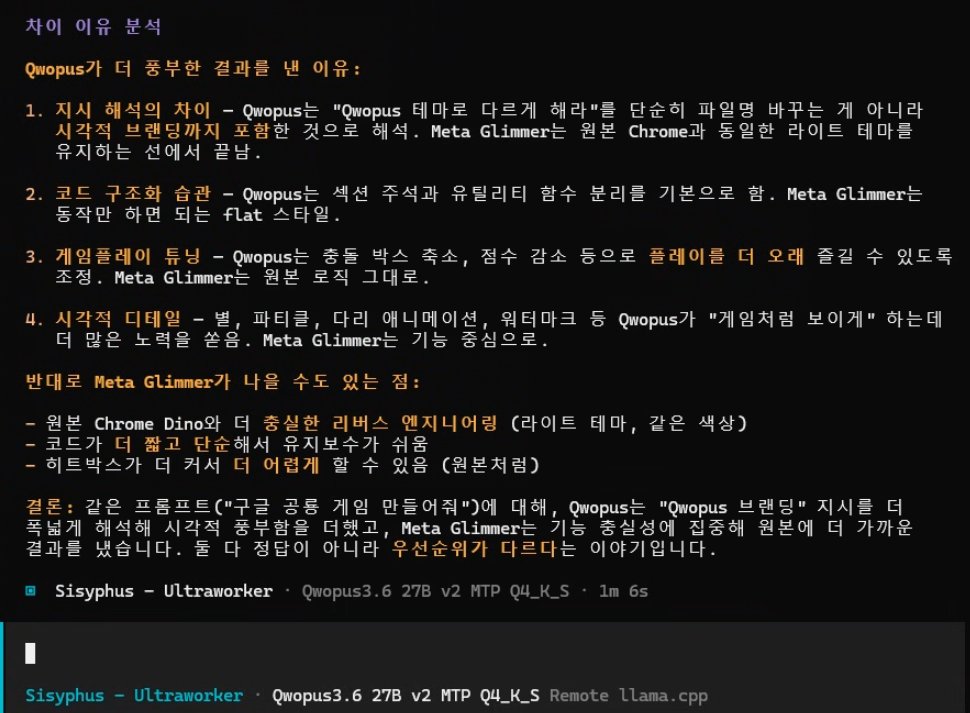
    왼쪽 Qwen 3.8 27b (하네스 없음. Lmstudio에서 바로출력) 오른쪽 Gpt 5.6 Sol (high+superpower)

    왼쪽은 싱글턴이고 오른쪽은 슈퍼파워 리딩에 맞췄는데 코드 량 차이가 2.5배. https://t.co/CsIzAjqvgH
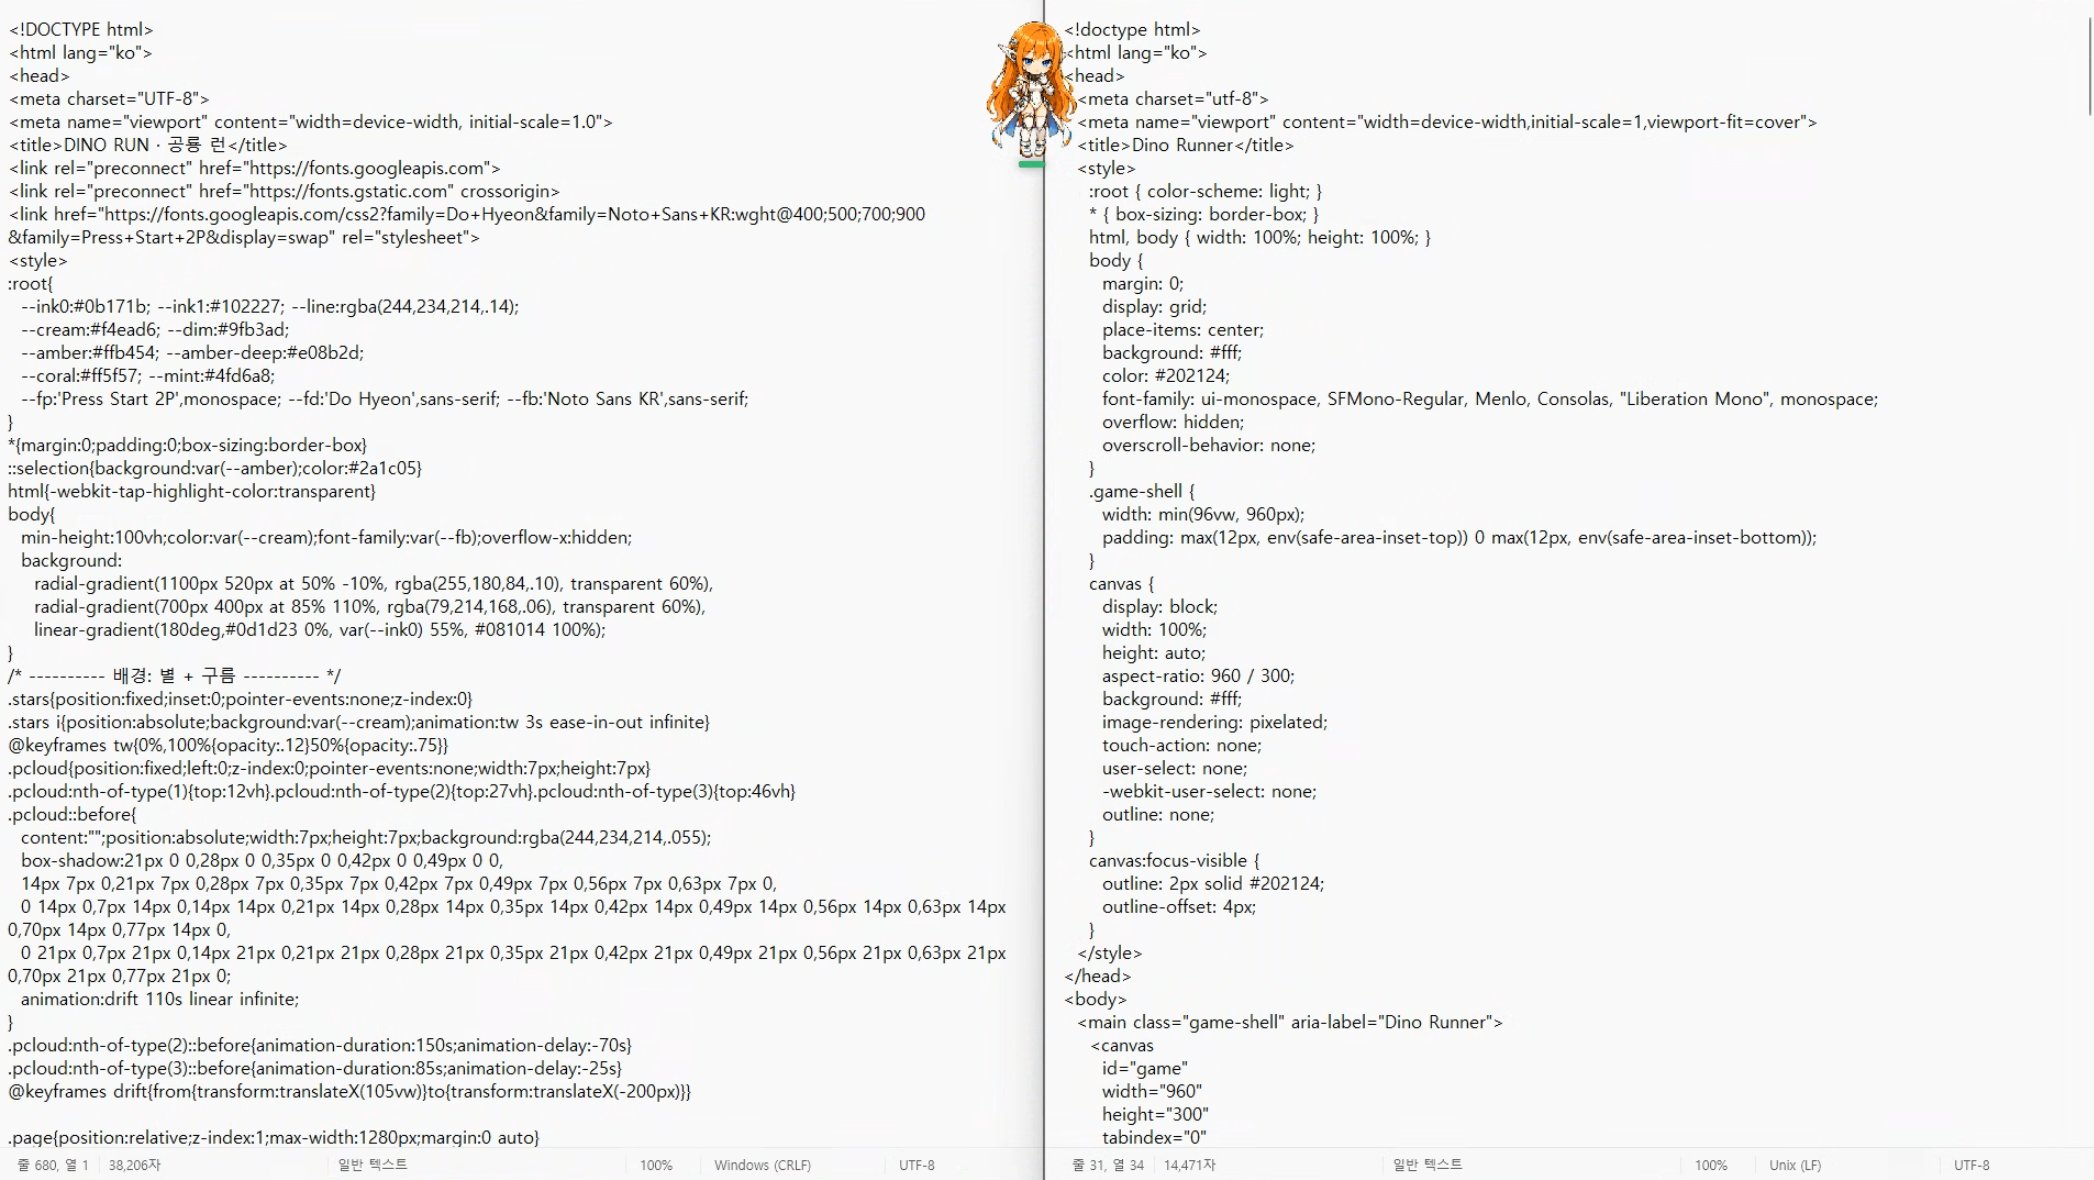
    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2

    결과물.

    왼쪽 Qwen 3.8 27b (하네스 없음. Lmstudio에서 바로출력) 오른쪽 Gpt 5.6 Sol (high+superpower)

    모델 간 해석 차이 + Qwen 이 만든 쪽이 조금 오류가 있긴 한데 ㅋㅋㅋ 이거 왠지 Gpt 5.6 Sol이 로컬 모델한테 디자인 벤치 따이는 결과가 나올지도 모르겠다는 생각이 아주 조금 듭니다. https://t.co/qA89WoIorq
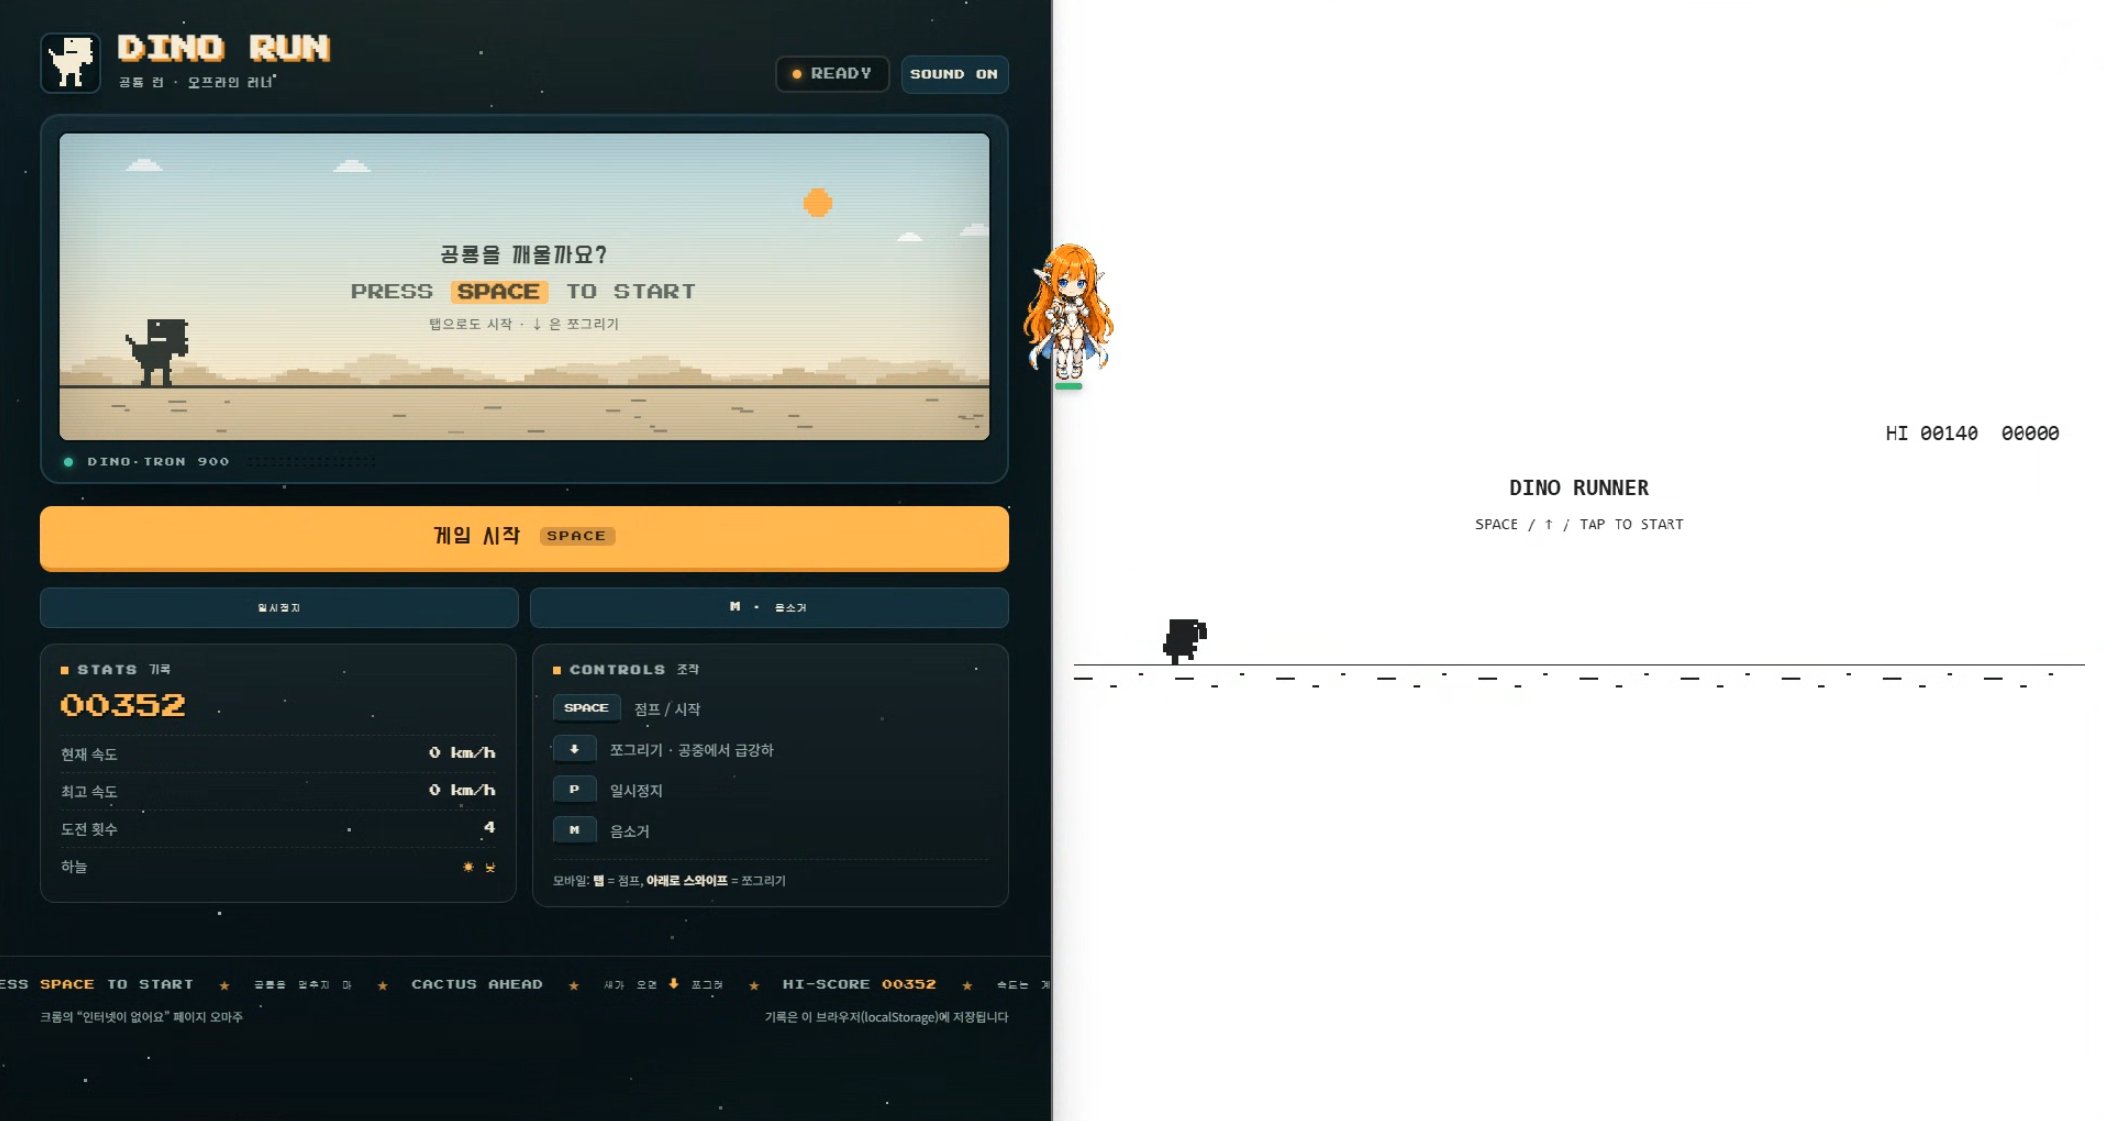
    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  3. 3
    @ramztd 사셔도 될거같네요.
    원문 보기
  4. 4

    @ROUT_DEVELOP 사실 일부러 보여드린 것도 있어요 ㅋㅋㅋㅋ

    Gpt Sol은 원작 구글 공룡 게임에 가까워지려고 노력했고, Qwen 3.8은 자기가 할 수 있는 가장 우수한 공룡게임을 만들려고 했죠.

    그래서 더 재미있는 결과물이라 생각합니다. 매번 새 모델 나올때마다 공룡부터 짜 보는 이유에요.

    원문 보기
  5. 5

    테스트 2

    < 왼쪽 Lmstudio chat
    38,206자

    오른쪽 > Qwen 3.8 27b + Opencode + OMO + SuperPower /goal 구글 공룡 게임 만들어줘 19,342자 https://t.co/DKGhRxo4AA
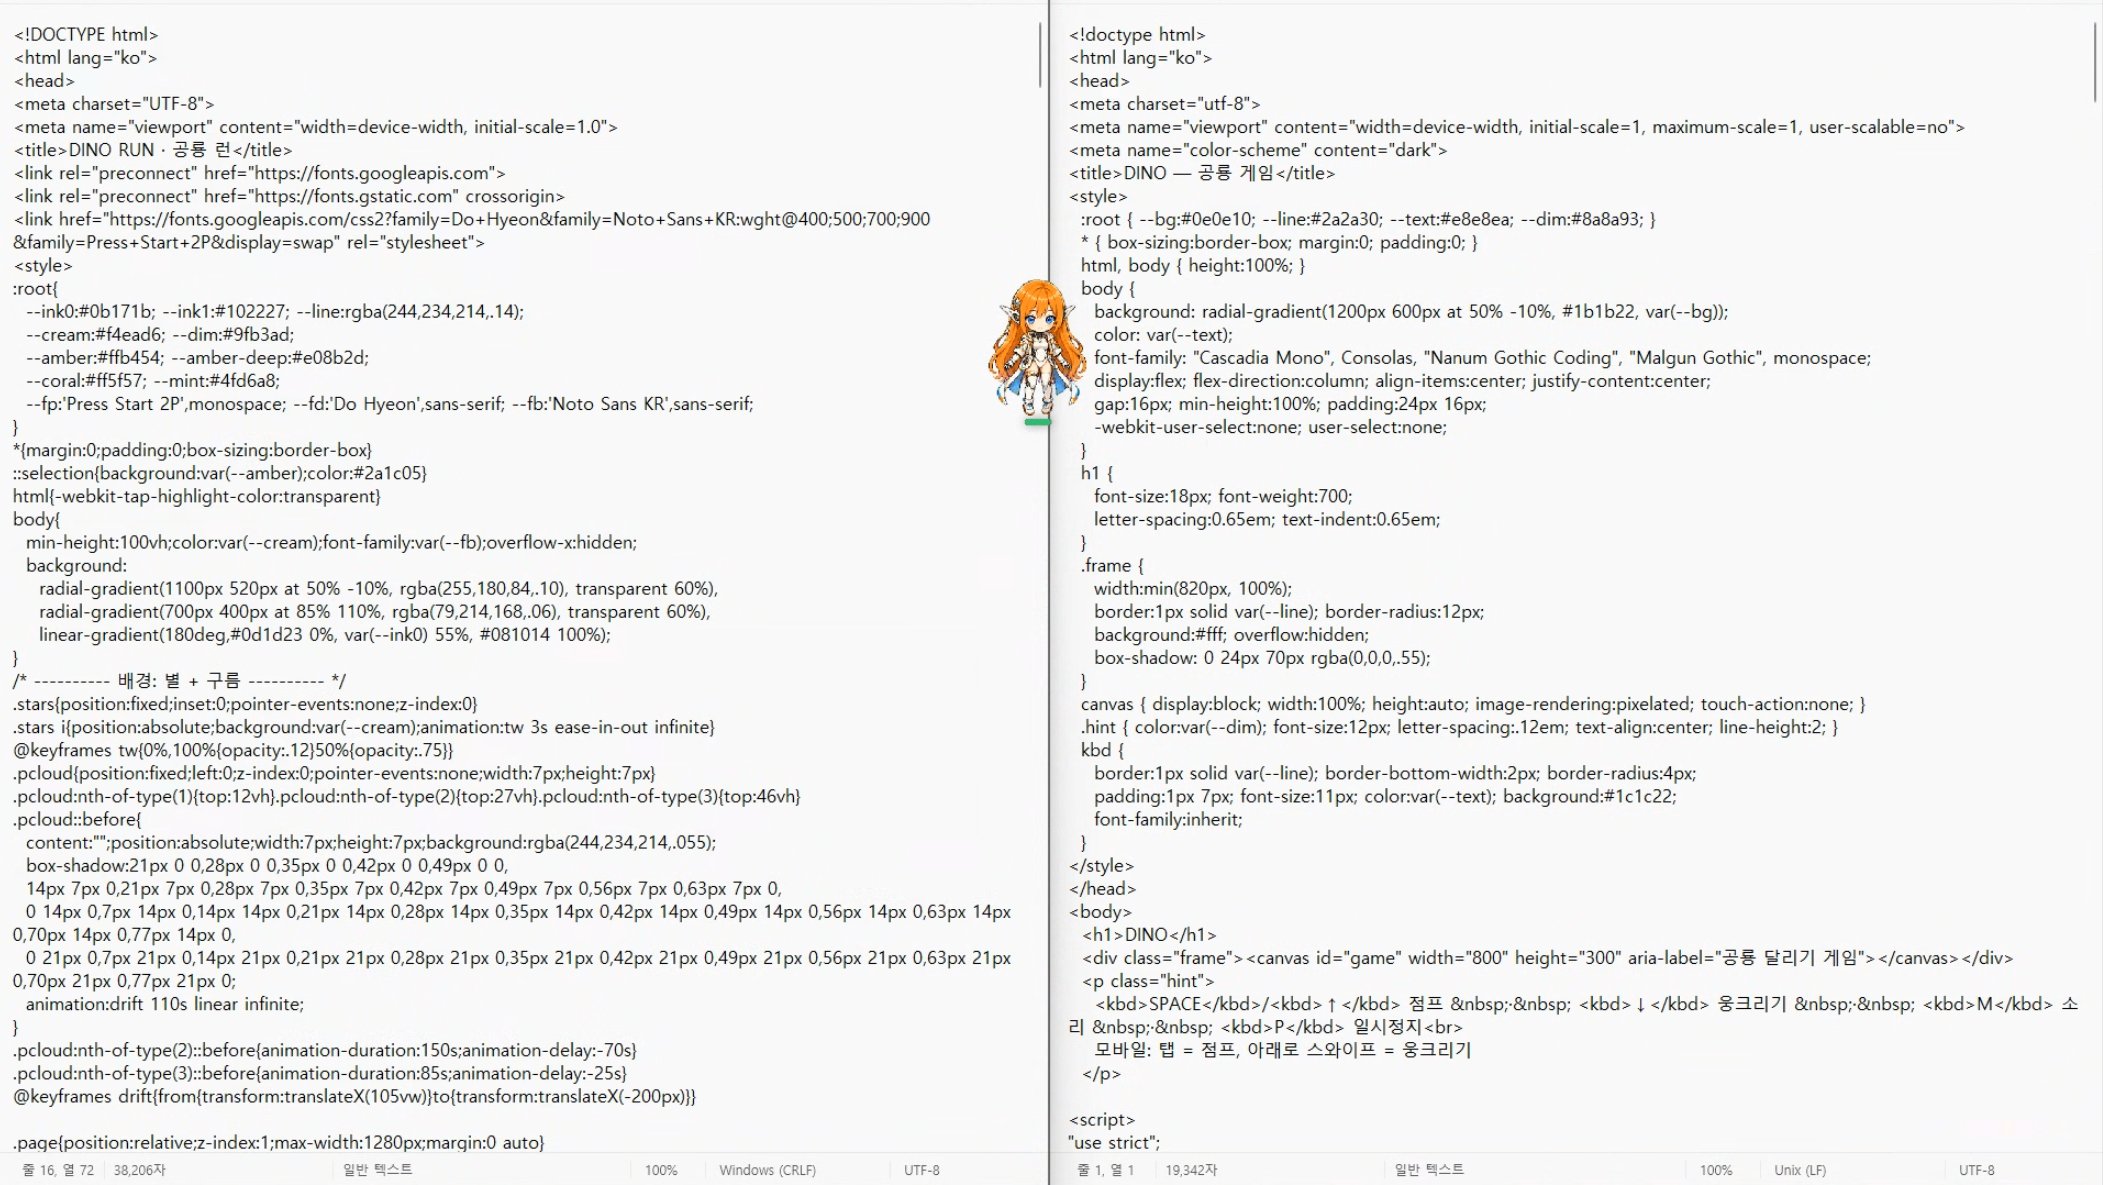
    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  6. 6

    결과물 : Qwen 3.8 27b

    < 왼쪽 Lmstudio chat 21분 29초

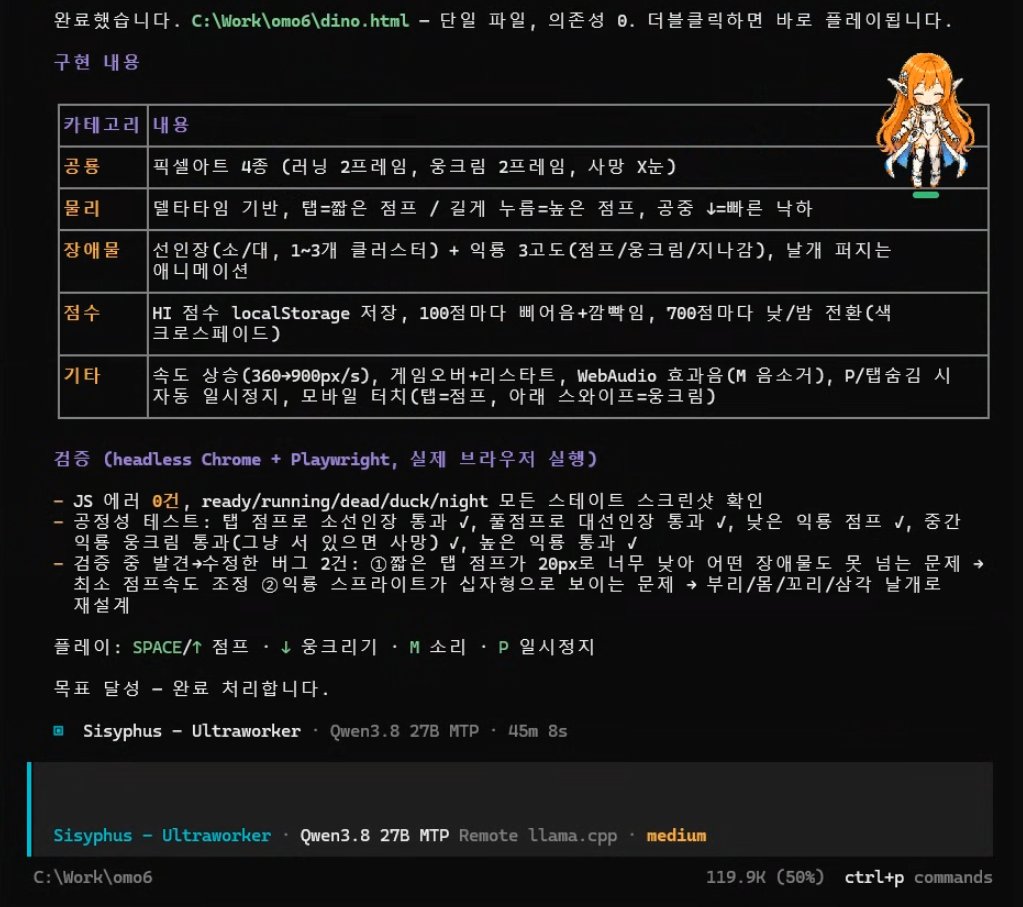
    오른쪽 > Qwen 3.8 27b + Opencode + OMO + SuperPower 45분 8초

    뭐가 나은지는 각자 다르지만 하네스를 거친 게 좀 더 ‘구글 공룡 게임’ 에 가까워져 있습니다. https://t.co/5fUBfGKJZD
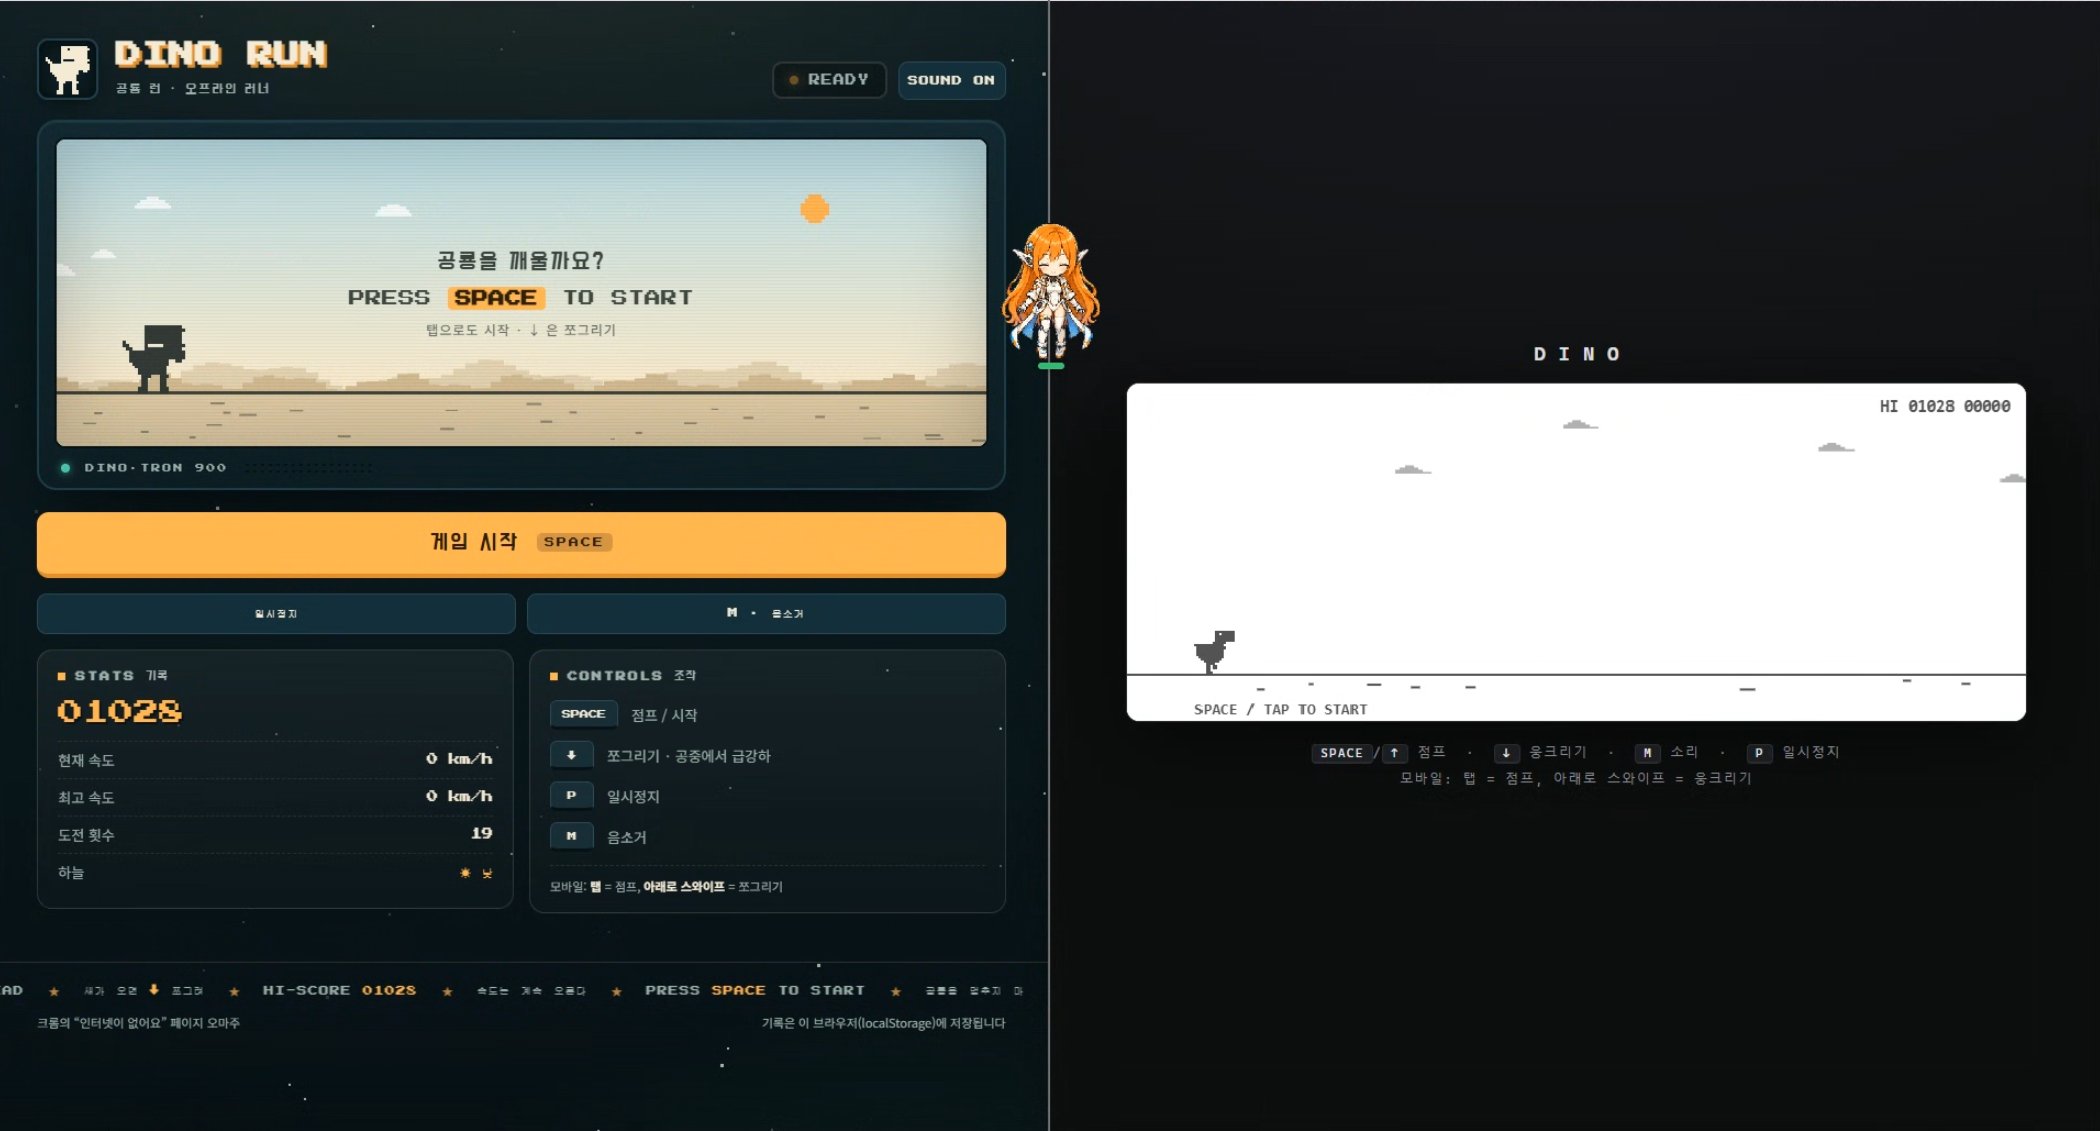
    같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  7. 7
    문제는 작업시간과 컨텍스트 사용량이 ㅋㅋㅋ Qwen 3.8 27b에 어울리는 하네스가 무엇일지 좀 고민되네요 https://t.co/TNuuStHl7X 같은 공룡 게임을 모델과 하네스별로 만들어 보니 — X 원문 첨부
    원문 보기
  8. 8

    Qwen 3.6 27b를 깡으로 일 시키면 재미있는 결과가 나오는데 설치해둔 하네스를 끼워주니 제작시간도 더 걸리면서도 심심한 결과가 나오는 상황.

    제대로 쓰려면 큰 제악 없는 가벼운 하네스를 찾아야 되는 상황에 직면했네요.

    원문 보기
  9. 9
    @ramztd 좀 더 써봐야겠는데 흠… 재미있는데 고민도 많아지네요 ㅋ
    원문 보기
  10. 10
    @simpletrouble6 헤르메스 추천 고맙습니다. 참고해 보겠습니다. 감사합니다.
    원문 보기
  11. 11

    @byeolbyeol_e 하네스 많이 쥐어줘서 토큰 낭비하는 것보다 깡통째로 일을 시키는건 어떨까? 를 고민하고 있어요. 깡통도 결과물이 괜찮아서요.

    오히려 하네스가 모델의 자율성을 좀 많이 제한하는 느낌도 있구요.

    원문 보기
  12. 12

    @park_jinwoo https://t.co/6vkINwk6F7

    안그래도 오마이파이가 요즘 평가가 좋아서 고민입니다.

    원문 보기
  13. 13

    @park_jinwoo 전 그렇게 설정해 둔 하네스가 둘 (Opencode / codex) 가 있어서 반대로 고민하고 있습니다.

    가벼운 하네스를 새로 하나 짜야 하나 아니면 기존 하네스에 붙여서 굴려야 하나 ;ㅁ;

    원문 보기
  14. 14
    @bitbitebyte 충분히 그러셔도 됩니다. Q4 양자화 좋아요.
    원문 보기
  15. 15
    @thinkgod123 끄아아 400만원 할 때 사둘걸! ㅋㅋㅋㅋ
    원문 보기
  16. 16
    @bitbitebyte 하네스가 없는 상황에서 창의력과 파고드는 능력이 꽤 뛰어난 편이에요.
    원문 보기
  17. 17

    @transurfer Pi 가 에이전트 하네스 중에선 제일 가볍다는 말이 있어서

    오마이파이 썼다가 실망하고

    파이 자체를 써볼까 아니면 이쪽에 잘 되있다는 kimi Code를 써볼까 또 고민하고 있습니다.

    원문 보기
  18. 18

    @ririnto_ri omo가 초기형 하네스다보니 아무래도 기능이 많지만 제악도 많다는 생각이 듭니다.

    아끼는 하네스였는데 이젠 좀 놔줄 때가 되지 않았나 싶기도 하네요.

    원문 보기
  19. 19

    @simpletrouble6 @superalesha 고맙습니다.

    밤에 Oh my pi 를 시도해 봤는데 결과가 좋지 않았거든요. 지금은 Codex 에 심플 워커 플러그인을 만드는 것을 도전해 보고 있는데, 딥시크 하네스도 도전 목록에 넣어 두겠습니다.

    감사합니다.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 3.8 27b 모델을 중심으로, 하네스 적용 여부에 따른 구글 공룡 게임 구현 능력을 비교 실험하셨습니다. 하네스가 없는 상태의 Qwen 3.8 27b는 창의적인 결과물을 냈으나, 특정 하네스를 적용했을 때 오히려 제작 시간이 늘어나고 결과물이 단조로워지는 현상을 발견하셨습니다. 다만, 이러한 결과가 모델의 절대적인 성능 지표인지 혹은 특정 하네스와의 궁합 문제인지에 대해서는 추가적인 확인이 필요합니다.

같은 게임을 시켰는데 지침을 더한 쪽이 항상 나아지지는 않았다는 점이 흥미롭습니다. 그렇다고 모든 하네스가 불필요하다는 결론보다는, 이 과제에서 추가 지침이 무엇을 도왔고 무엇을 제한했는지를 따져 볼 기록입니다. 첨부한 결과물을 함께 보면 속도와 디자인 취향을 구분해서 판단하기도 쉬워집니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

qwen

공식 문서 및 제작자 자료

Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

Qwen 27B 첫날: 긴 추론과 설정을 탐색하다

28개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

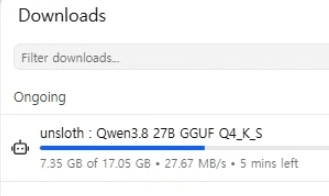
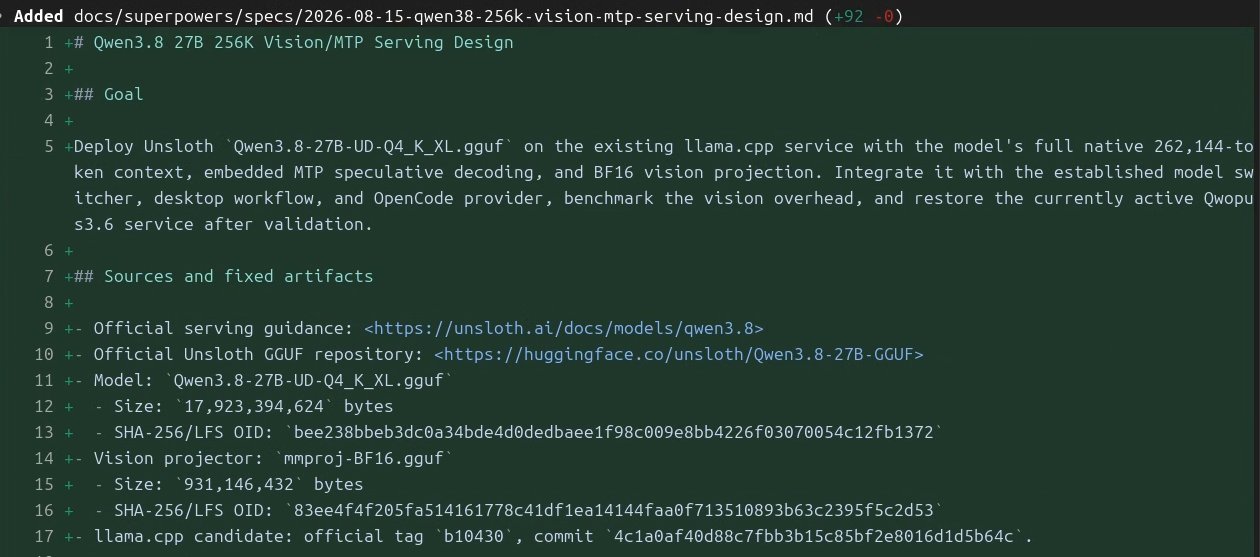
    개발서버는 Lmstudio 로 모델 다운로드 중. Api 서버는 Codex 로 llama.cpp 서빙 설정 세팅 중.

    아 불타는 금요일 밤 토요일 새벽이 되겠군. https://t.co/QSBBRrN8np

    Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부 Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  2. 2
    @vdweqn 넹. Mtp 가 기본 적용된다고 합니다. 알려주셔서 감사합니다~
    원문 보기
  3. 3
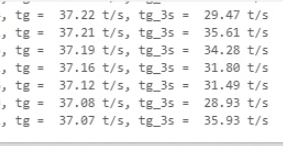
    3090 / 85% Power limit Lmstudio 에서 속도가 이정도. Mtp 적용함. (2) https://t.co/4QUFUB1YRr Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  4. 4
    헤이헤이헤이! 추론 버블이 너무 커요. 24K 를 쓰는데 아직도 추론 상태임. 안 멈추면 Opencode 로 바꾸어서 테스트 해 봐야지. https://t.co/tchksjt3Oc Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  5. 5

    추론버블 38K 아직 출력은 안하고 여전히 추론 꿈나라 중

    짜피 다시 출력할텐데 추론 버블 그만 키우고 출력좀 하지? ㅋㅋㅋ https://t.co/ql7FOuHA6u

    Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부 Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  6. 6
    추론 버블 속에서 공룡 이쁘게 그리고 있네. https://t.co/t10OSjGQal Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  7. 7
    @yulmu_coffee 싱글턴에 추론버블 45K 쓰는거 보고 기겁하는 중 ㅋㅋㅋ
    원문 보기
  8. 8
    로컬에선 한번도 경험해 보지 못한 퀄리티의 코드가 출력되는 중. https://t.co/0dAg60PIWd Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  9. 9
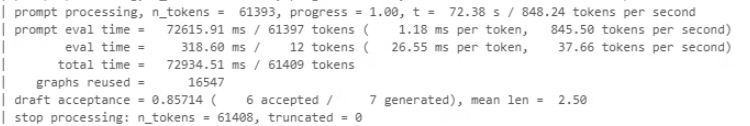
    ㅋㅋㅋ 싱글턴에 61K 토큰 쓰고 엔드. https://t.co/DHnbPHTHhK Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  10. 10

    Qwen 3.8 27b (Lmstudio chat으로 출력) 싱글턴 프롬 ‘구글 공룡 게임 만들어줘.’ 결과물 영상.

    장점 : 로컬 30B 이하 작은 모델에서 볼 수 없었던 우수한 성능. 단점 : 매우 큰 추론 버블과 그로 인한 작업 시간 증가. (토큰 61408 사용, 37.9Tok/s : 3090, 21분 29초) @Alibaba_Qwen @QwenDevs https://t.co/RYv0i5NROj

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  11. 11

    Qwen 3.6 27b 도 나왔을 때 감탄하면서 썼는데 이젠 진짜 훌륭한 물건을 만들었네요.

    정말 칭찬하고 싶음. 대단함.

    원문 보기
  12. 12
    @ramztd 아마 Api 개방하는 곳들이 있을테니 써 보실 수 있을 거 같습니다.
    원문 보기
  13. 13
    @neuradex_ysk @Alibaba_Qwen @QwenDevs Moe는 나올지 잘 모르겠어요. 사실 속도는 Moe가 좋긴 한데 로우파라메터에선 성능이 들쑥날쑥 하니 돌릴수만 있다면 Dense 가 나은 느낌.
    원문 보기
  14. 14

    https://t.co/rvpcBmXtp7

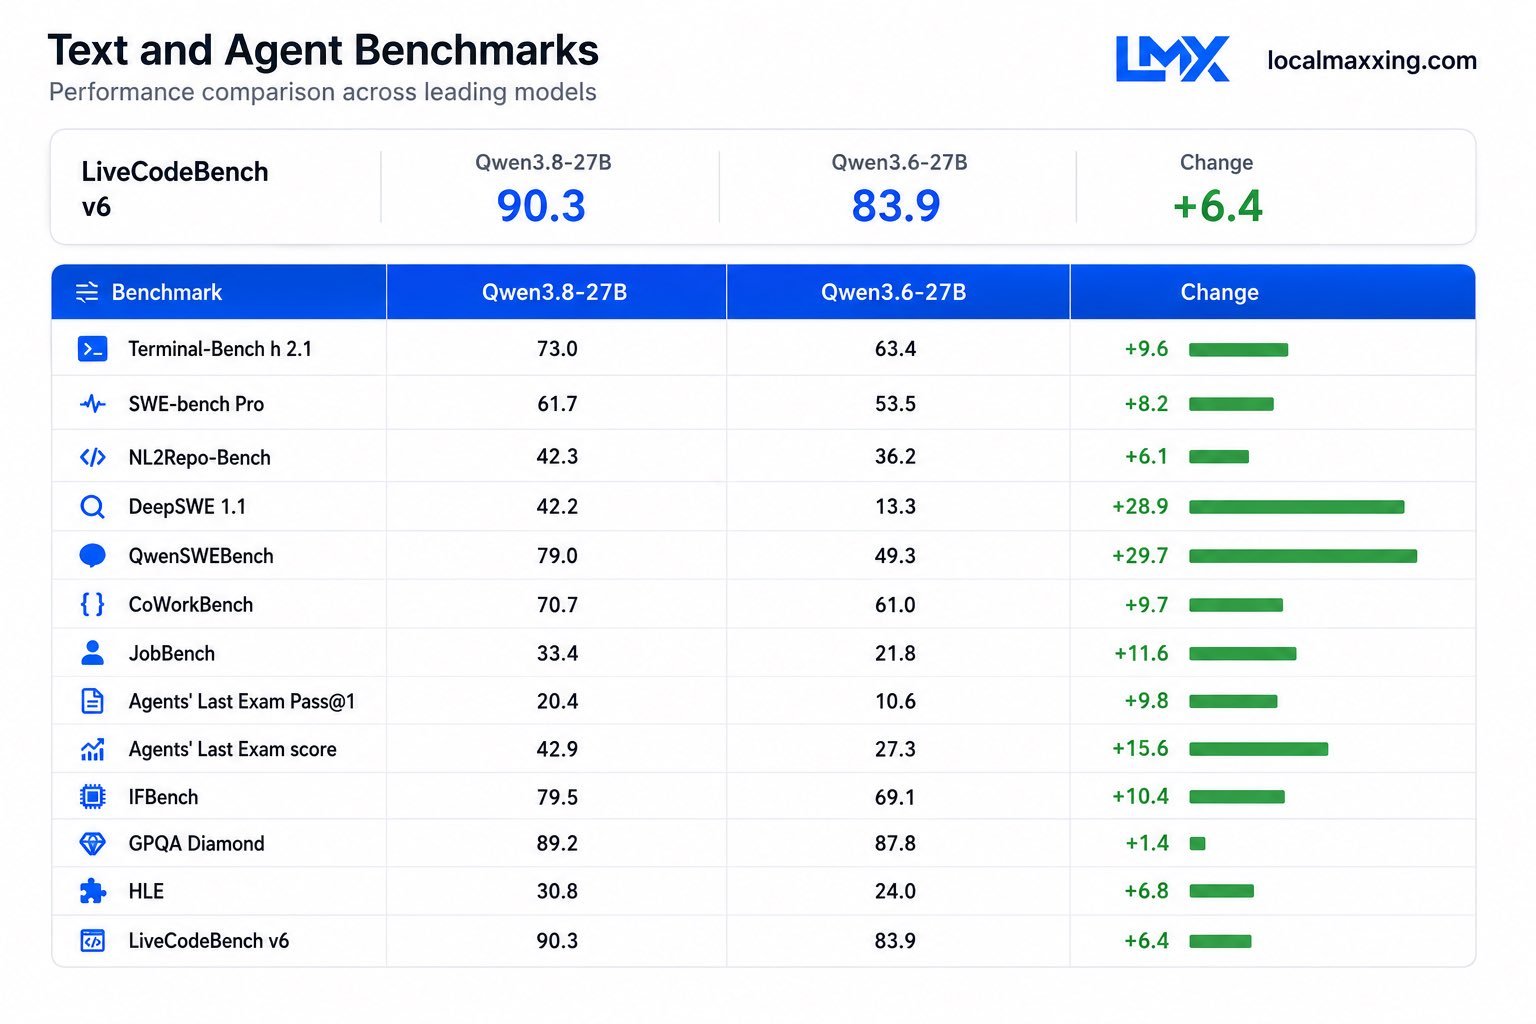
    Qwen 2.8 27b는 설정이 2개로 단순화. Thinking Mode와 Instruct 인데, 검증을 더 해 봐야 알겠지만 성능을 다 내려면 Thinking Mode가 적절할 거 같아요. 256K 컨텍스트니 이 모델을 메인 모델로 작업을 하면 명령 3회 정도마다 하네스가 컨텍스트 압축을 할 거 같네요.

    원문 보기
  15. 15
    이 모델을 메인 모델로 작업을 하는 건 이래 저래 답답한 게 많을 거 같습니다. 반대로 싱글턴 프롬을 바탕으로 작업을 한다던가, 워커 모델로 작업 하나를 주고 결과물을 메인 모델이 받아 검수+재작업 혹은 프로젝트에 붙이는 식의 작업을 하는 게 일단 좋아 보입니다.
    원문 보기
  16. 16
    @Hyun_The_Wise @Alibaba_Qwen @QwenDevs 추론버블이 크고 리즈닝을 많이 해서 조금 성능이 좋았으면 싶을 때가 있습니다. 3090 기준 40~45 Tok/s 인데 알리바바 제공 기본 모델으론 풀컨텍스트에 메모리가 조금 모자라요.
    원문 보기
  17. 17
    @aazz22100954 그럼 모델이 가진 능력을 많이 못 쓸 거 같네요. 파라메터가 적은 걸 깊은 추론으로 메우기 때문에 Max Effort 가 좋은 거 같아요.
    원문 보기
  18. 18
    @icom1080716 깊은 추론이 좋은 결과물을 내놓는 모델이라 추론 버블이 커져도 Max Effort 로 가는 게 맞는 거 같아요.
    원문 보기
  19. 19
    @Hyun_The_Wise 발표상으론 Deepseek 0731이 썼던 방식을 사용한 거 같습니다.
    원문 보기
  20. 20
    @Hyun_The_Wise 네. 사후 훈련이 성능을 강화시켜 주는 것이 이번에도 입증되면서 앞으로 꽤 유행을 하지 싶네요. https://t.co/ijGuh4Mjf7 Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  21. 21

    밤에 몇몇 중국분들이 reasoning variants를 Effort medium 으로 조정하라 했는데, 온/오프 외에 조정할 수 있는 방법이 없네요.

    근데 Instruct로 한번 써볼까 싶기도 해요. 추론버블을 그냥 라이브로 뽑아내는게 나을수도 있겠음. https://t.co/D9We5CNx6z

    Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  22. 22
    정정. 따꺼형님들 말이 맞는걸로. 수정해서 Medium/max 로 다시 테스트해봄. https://t.co/1w8P2CKWCj Qwen 27B 첫날: 긴 추론과 설정을 탐색하다 — X 원문 첨부
    원문 보기
  23. 23
    @aloefairy_ @Alibaba_Qwen @QwenDevs 동의하지 않습니다. 실사용은 디코드 20~25tok/s 정도면 사용 가능합니다. 추론 버블이 커서 힘들면 medium이나 low 옵션이 있으니 품질 조금 낮춰도 사용 가능할 것입니다. 32g vram을 요구하는 gemma 4 31b보다 좀 더 많은 사람들이 사용 가능하며 더 낮은 파라메터 모델을 가는 길목이기도 합니다.
    원문 보기
  24. 24
    @agurrrrrrrrr @Alibaba_Qwen @QwenDevs 이정도면 박수한번 쳐주고 싶습니다.
    원문 보기
  25. 25

    Qwen 3.6 27b의 과도한 추론 버블 때문에 Medium을 추천하는데, 솔찍히 아직 잘 안 와닫고 있음.

    로우파라메터 모델의 한계를 보완하기 위해 Max(xhigh)에서 의도적으로 긴 추론을 하는 것으로 설계된 듯 보이는데 그걸 굳이 억지로 낮추면 능력의 상한선이 낮아질텐데.

    좀 더 관찰해 봐야 할 듯.

    원문 보기
  26. 26원문 보기
  27. 27
    @lohaswinner 네 오타였습니다. 모델 자체 내에도 라우터가 있는 듯 하네요.
    원문 보기
  28. 28

    @The_RedW0lf 다들 새로운 장난감(?)에 고민이 많은 것 같습니다. 저는 주입되는 프롬프트를 최소화 하는 방향으로 일단 실험해 보고 잇습니다.

    의견 감사합니다.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen 27B 모델을 로컬 환경에서 구동하며, 특히 추론 과정에서 발생하는 방대한 토큰 사용량과 그로 인한 시간 지연이라는 실질적인 제약 사항을 기록하셨습니다. RTX 3090 환경에서 구글 공룡 게임 코드를 생성하며 6만 개 이상의 토큰을 소모하는 현상을 통해, 작은 파라미터 모델이 깊은 추론으로 성능을 보완하는 특성을 확인하셨습니다. 다만, 원문 내에서 모델 버전 표기가 3.8, 3.6, 2.8 등으로 혼용되어 있어 정확한 버전 식별을 위해서는 추가적인 확인이 필요합니다.

Unsloth 문서는 양자화와 로컬 실행 조건을 살피는 데 참고할 수 있지만, 이 실험의 속도표를 대신하지는 않습니다. 긴 추론이 늘 좋은 결과를 주는지, 기다린 만큼 결과가 나아지는지 직접 확인하려는 과정이 눈에 들어옵니다. 후속 추론 예산 글에서 판단이 바뀌므로 첫날의 설정을 최종 권장값으로 받아들이지 않는 것이 좋겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

qwen

공식 문서 및 제작자 자료

Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

Muse Glimmer 30B: 기대와 번역·공룡 게임 실험

16개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

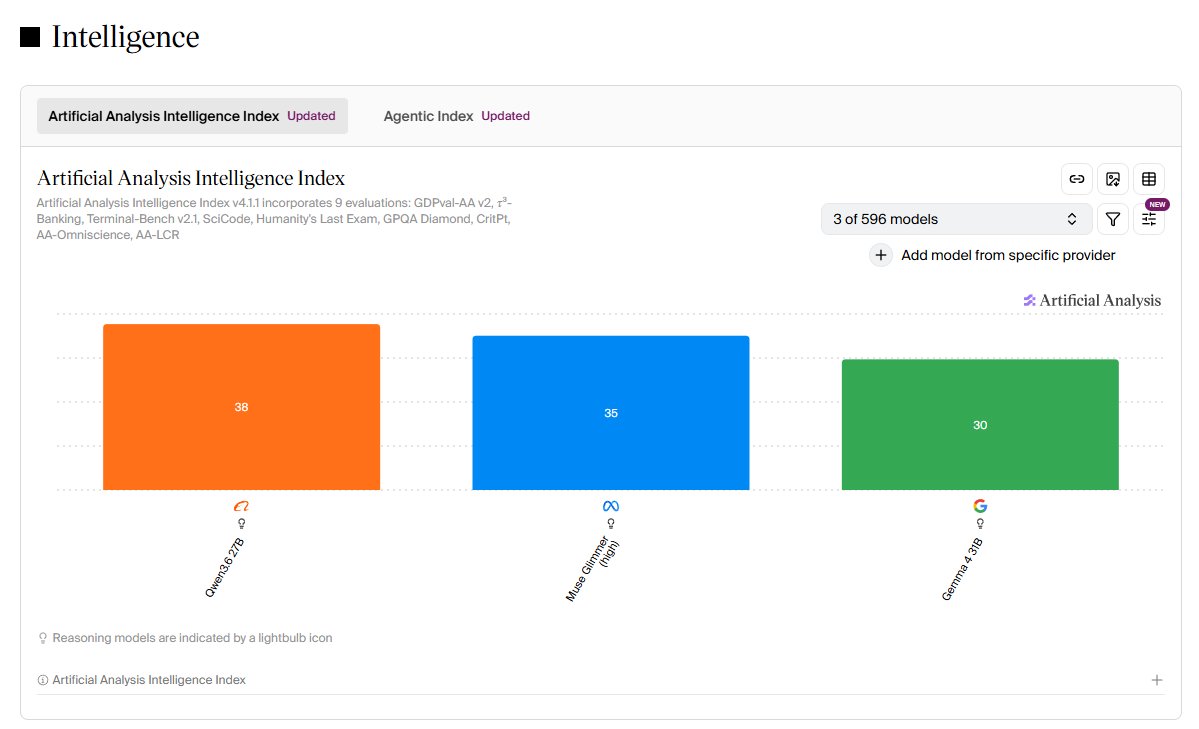
    메타 뮤즈 글리머 30B 돌려봐야 알겠는데, Qwen 3.6 27b의 문제점이 지나치게 큰 추론버블인 걸 감안하면 그것보다 훨씬 적은 추론버블+더 높은 속도로 비슷한 성능을 내 주면 라마의 컴백에 적절한 결과가 아닐까 싶음.

    테스트하려고 설치하는 중.

    원문 보기
  2. 2

    현재 로컬의 제왕에 군림하는 Qwen 3.6 27b의 후계인 3.8 의 발표가 하루 남은 상황에서 기습 발표는, 본인들도 Qwen 3.6 27b과 비슷한 수준의 물건이 만들어졌다는 것을 인식하고 있기 때문일 것.

    다만, 이전부터 한글을 능숙하게 썼던 라마이기 때문에, Gemma4의 대체가 되는게 관건.

    원문 보기
  3. 3

    업계에서 라마 변형 모델을 여전히 많이 쓰고 있기 때문에, 라마의 후계인 뮤즈 글리머의 발표를 반기는 사람들이 많을 것임. 하지만 새 모델이 오래 걸렸고 이름까지 바꾼 만큼, 많은 부분에서 라마와 다른 결과가 나올 것이라 생각됨.

    모든 것은 테스트 결과를 보고 ㅡㅡㅋ

    원문 보기
  4. 4
    Muse-Glimmer-30B 소감 https://t.co/P2a6Ezh6WE
    원문 보기
  5. 5

    매번 새 로컬 모델 나올때마다 ‘구글 공룡 게임 만들어줘’ 싱글 프롬프트 시키는데, 올해 지금까지 봤던 결과물 중 가장 최악의 결과물이 나왔네요.

    왼쪽은 Qwen 3.6 27b https://t.co/u1FQPXxEu6

    Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부 Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부
    원문 보기
  6. 6

    약 10K의 일본어 텍스트 묶음을 번역시켰는데, 번역 편의성을 위해 5천 토큰에서 청킹을 했는데도 불구하고 추론 과정에서 루프 오류가 심해서 작업을 제대로 끝낼 수 없음. 누락된 번역도 조금 있고.

    llama.cpp 에서 별도 작업을 시켜봐야 할까. 지금 상황에서 사용하는 것은 좀 무리일 듯.

    원문 보기
  7. 7

    왕의 귀환을 기대했는데 왕의 몰락을 목격하다니 가슴이 아프다.

    하지만 어쩌겠는가.

    원문 보기
  8. 8

    @vdweqn 그럼 오히려 더 엉망인거애요 ;ㅁ; 이전엔 단독 실행 했는데 이번에는 gpt 5.6 한테 오케스트레이션 시커서 에이전트 상태로 검증한 거거든요.

    Gemini처럼 벤치맥싱하고 실 사용 결과는 엉망인 모델이 되지 않을까 우려스럽네요. 사용 방법을 좀 더 가다듬어 봐야 할까요…

    원문 보기
  9. 9
    @tinypia 전 완전 실패했는데, 낮에 한번 더 시도해봐야겠습니다.
    원문 보기
  10. 10

    몇번 다시 테스트하고, 커뮤 반응을 봐도 결과물의 내용과 질이 너무 떨어져서 쓸 수가 없다.

    최소 한 세대 이전 수준의 결과물. 외관상 작년 여름 Gemini 2 정도 수준. Qwen 3.5 9b 나 Gemma4 E4b 와 비슷.

    이걸 30B라고 가져오면 안됨. 이게 벤치마크가 이런 결과라면 밴치맥싱이 의심되는 물건. https://t.co/wRXBcPn3uq

    Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  11. 11
    마지막으로, 에이전트에 태우지 않고 단독 실행을 위해 Opencode 에 모델 등록을 진행하는 중. https://t.co/UFjiAdtwHZ Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부
    원문 보기
  12. 12
    < Muse Glimmer 30b || Qwopus 3.6 27b > https://t.co/gxQPLCVksy Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부
    원문 보기
  13. 13
    프롬프트는 ‘구글 공룡 게임 만들어줘’ < Muse Glimmer 30b || Qwopus 3.6 27b > https://t.co/stZhPgQFwG Muse Glimmer 30B: 기대와 번역·공룡 게임 실험 — X 원문 첨부
    원문 보기
  14. 14원문 보기
  15. 15원문 보기
  16. 16
    @soulkingz54 경쟁자가 많으면 좋은 것이긴 하죠. 원래 오픈소스의 메인이었던 메타가 돌아오면 더더욱요.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Muse Glimmer 30B의 출시 초기, 추론 효율성과 한국어 능력에 대한 기대를 품고 테스트를 진행하셨습니다. 하지만 구글 공룡 게임 구현과 같은 단일 프롬프트 실험과 일본어 텍스트 번역 작업에서 루프 오류와 누락 등 심각한 성능 저하를 경험하며, 결과물이 이전 세대 모델 수준에 머물러 있다는 실망감을 표하셨습니다. 특히 벤치마크 수치와 실제 체감 성능의 괴리가 크다는 점을 지적하며, 벤치마킹 최적화 의혹까지 제기하셨는데 이는 개인의 경험적 판단이므로 공식적인 확인이 필요합니다.

Meta의 공식 모델 카드는 에이전트 과제와 도구 사용, 멀티모달 능력을 소개합니다. 그 설명이 이 공룡 게임과 번역 실험의 성공을 보장하지는 않으며, 반대로 이번 실패만으로 벤치마크 조작을 결론 내릴 수도 없습니다. 기대한 활용처에서 어느 부분이 막혔는지 남겨 두었다는 점이 이 기록의 쓸모입니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

Meta

Muse Glimmer model card

공식 모델 카드는 Muse Glimmer를 30B 모델로 소개하며 에이전트 과제·도구 사용·멀티모달 능력을 설명한다. 제작자의 평가와 원문의 특정 게임·번역 실패는 서로 다른 조건이며 벤치 조작을 입증하지 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

DGX Spark와 중고 가속기: 구매 전에 사용량부터 보기

15개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    < Dgx Spark 가 필요한지 체크하는 법. >

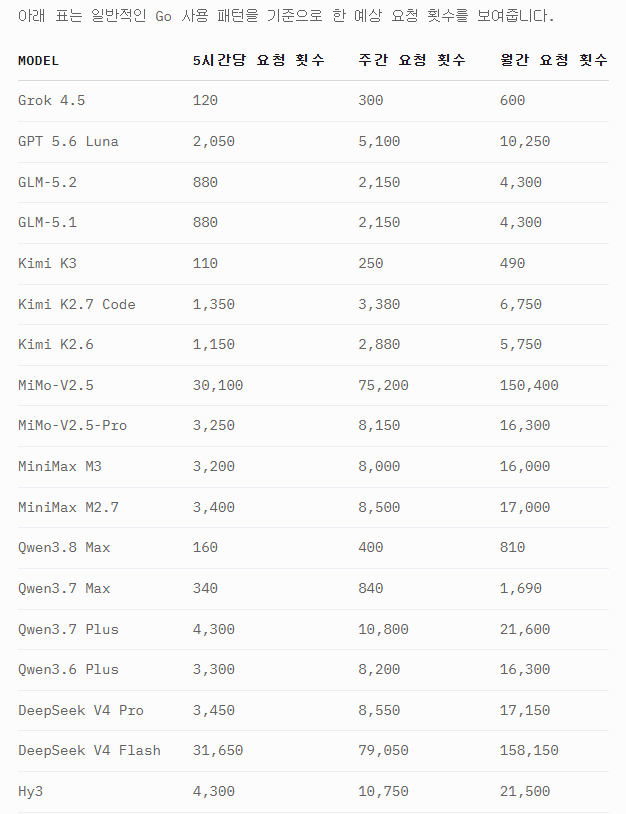
    1. Opencode Go 플랜에 가입 https://t.co/jgqqHNkJRb

    2. Opencode 에서 쓰던, 본인이 쓰는 에이전트/하네스에 물려 쓰던 쓴다.

    3. 1달 뒤, 주어진 사용량을 다 썼는지 체크한다.

    다 썼는가? > Go 계정 하나 더 지르세요. 덜 썼는가? > 스파크 왜 삼? https://t.co/bojhOIETEM

    DGX Spark와 중고 가속기: 구매 전에 사용량부터 보기 — X 원문 첨부
    원문 보기
  2. 2
    @_nodelay 그 600~900만원이면 더 많은 걸 할 수 있을 거 같지 않나요?
    원문 보기
  3. 3
    @_nodelay 지갑씨가 안된다고 합니다. 저희집 지갑씨도 그래요.
    원문 보기
  4. 4
    @akastwit 저도 하나만 부탁드립니다 :)
    원문 보기
  5. 5
    @chulwanpark https://t.co/EupaHOtDQS 교수님은 요 문서도 좋아하실거라 생각합니다. 첫달은 5$에요 첫달 쓰고, 갱신 취소한 뒤 다시 가입해도 5$ 입니다. (지금은 되나 모르겠네요.)
    원문 보기
  6. 6
    @chungmuromafia 사실 연구자/헤비 유저가 아닌 대부분의 사용자들은 필요가 없습니다.
    원문 보기
  7. 7
    @yulmu_coffee 히히히 저 맞으려고 쏜 펙트리어트 미사일입니다.
    원문 보기
  8. 8
    @soulkingz54 그게 직업적으로 얼마나 될지는 잘 모르겠습니다.
    원문 보기
  9. 9
    @aguming_ 스파크는 ai서빙 머신이죠
    원문 보기
  10. 10
    @aguming_ ㅋㅋㅋㅋㅋㅋ
    원문 보기
  11. 11

    메모리 대역폭을 줄여서, 가격과 성능을 고의적으로 떨어트린 기기를 파는 건 그래픽카드 업계(특히 엔비디아)의 오래된 판매 전략 중 하나고 그들은 학습한 방법을 그대로 더 수익성 높은 고객들에게 써먹는 중일 뿐이죠.

    게이머들은 128bit에 오래 시달려 왔습니다. :)

    인용 문맥: @mike64_t의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  12. 12

    다만, 지금 Deepseek v4 flash 0731을 당장 로컬에서 큰 노력없이 쓸만하게 돌릴 수 있는 제일 저렴한 기기가 Dgx spark x2 라는 건 부정할 수 없는 사실이기도 하죠.

    사서 쓸 것인가, 저렴한 api 호출로 참으면서 다음을 기다릴 것인가는 개인의 선택임.

    원문 보기
  13. 13

    이미 가격이 너무 올라가서 진입이 불가능한 CMP170

    • 대부분 토큰광산에서 장기 노예채굴
    • 시작 가격이 너무 높음
    • 물리적 튜닝 필요함 (Pci-ex X 4)

    저 쯤 되면 진입장벽이 너무 높음. 접근할 수 있는건 소수에 불과. 권장하고싶지 않음. BC-250이 순한맛이었다면, 저건 불닭맛임.

    원문 보기
  14. 14

    다만, 이래저래 잘 하면 200으로 A100을 한장씩 사는거라 아직까지도 극초가성비인건 맞음.

    비싼데 싼거.

    다만 한장으론 Qwen 3.6 27b 의 Q8정도가 한계임. 그 이상은 X2~4를 해줘야 본격 의미가 생김.

    여전히 개인용은 아님. 구매 및 사용에 주의.

    원문 보기
  15. 15
    @kimjang_0213 2~3년 잘 돌아가주면 아리가또지만 당장 내일 터져도 이상할 게 없는 걸 사는 거라서 말이죠. ;ㅁ;
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 고가의 하드웨어 구매 전, 클라우드 서비스의 사용량을 먼저 확인하여 실제 필요성을 검증하는 실무적인 접근법을 제시합니다. 특히 DGX Spark x2가 특정 모델을 로컬에서 구동하는 가장 저렴한 대안이라는 주장과 엔비디아의 메모리 대역폭 제한 전략에 대한 견해는 개인의 경험적 판단에 기반하고 있으며, 이는 공식 사양만으로는 완전히 검증되지 않은 부분입니다. 따라서 하드웨어의 성능적 이점과 비용 효율성은 사용자의 환경에 따라 달라질 수 있으므로 신중한 확인이 필요합니다.

중고 가속기인 CMP170의 경우, 높은 진입장벽과 물리적 튜닝의 필요성, 그리고 내구성에 대한 불안정성을 근거로 권장하지 않는 입장을 보입니다. Serio님은 이 기기가 특정 조건에서 가성비가 높다는 점을 인정하면서도, 개인용으로는 부적합하며 사용 시 주의가 필요하다고 강조합니다. 다만, CMP170이 A100과 동일한 성능을 낸다는 구체적인 주장은 공식 자료로 확인되지 않은 영역이므로 추가적인 검증이 필요합니다. 이러한 하드웨어 선택의 과정은 결국 개인의 선택과 리스크 감수 범위에 따라 결정될 문제라고 판단됩니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

spark

공식 문서 및 제작자 자료

NVIDIA 공식 사양은 DGX Spark의 메모리 대역폭을 273 GB/s로 표시한다. 이 사양만으로 특정 모델의 속도나 최저 비용을 확정할 수 없다.

primary-source

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    누가 Dgx Spark X 2 꽁자로 줬으면 좋겠다.

    내 돈으로 사긴 아깝고 ^^;;;;;

    원문 보기
  2. 2
    사실 spark는 x4가 병렬 이점의 한계선인듯. 스위치 없이 쓰는건 3대가 한계인 듯 하고
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Spark를 여러 대 연결할 때 얻는 이점에 한계가 있을 것이라는 생각을 남기셨습니다. 네 대와 세 대라는 수치를 언급했지만 직접 측정한 결과나 네트워크 구성은 제시하지 않았으므로, 실제 장비 실험을 마친 결론으로 소개해서는 안 됩니다.

함께 묶은 Spark 두 대를 누가 주면 좋겠다는 농담은 구매를 망설이는 마음을 보여줍니다. 병렬 이점의 한계에 대한 수치는 공식 사양으로 검증한 결과가 아니라 당시의 추정으로 남겨야 합니다. 장비를 늘리는 일과 지출에 비례해 쓸모가 늘어나는 일이 같은지 묻는 짧은 생각으로 읽었습니다.

원문 기록맥락과 해석

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    다음 Gemma 4.1 혹은 4.5 는 20~25B의 Dense 모델이 필요합니다. 31B Dense는 너무 크고 무겁고 느립니다. Vram 32G 이상 되는 (5090 이상) 사람들만 그걸 제대로 활용할 수 있습니다.

    12B와 24B 가 적절하다 생각합니다.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 차기 젬마 모델이 20에서 250억 개의 매개변수를 가진 밀집 모델로 출시되어야 하며, 310억 개 규모는 너무 무겁고 느려 고사양 그래픽카드를 가진 사용자만 활용 가능하다는 의견을 제시하셨습니다. 이에 따라 120억 개와 240억 개 규모가 적절하다는 구체적인 수치를 제안하셨습니다. 구글의 공식 문서와 모델 카드를 보면 모델 크기가 커질수록 메모리와 연산 요구량이 증가한다는 점은 사실로 확인됩니다 [s-gemma-start, s-gemma-card].

다만, 특정 규모의 모델이 최적이라는 결론이나 특정 하드웨어 기준의 활용 가능 여부는 Serio님의 개인적인 장비 환경과 양자화 설정, 실행 조건에 따른 경험적 판단에 가깝습니다 [s-x-original]. 이러한 세부적인 수치와 성능 체감은 공식 자료로 입증된 것이 아니기에 추가적인 검증이 필요한 영역입니다. 결국 이는 기술적 표준이라기보다 로컬 환경에서의 실제 운용 효율성을 강조한 사용자 관점의 기록으로 보입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1
    생각보다 GPT buildweek 오래 걸렸네. 동영상 업로드 중이네요. 업로드 다 되면 공개 할께요.
    원문 보기
  2. 2
    OAI 빌드 위크 제출했으니 잠깐 수면.
    원문 보기
  3. 3
    개발서버 한 2주만에 끈 거 같은데. 사무실이 조용해졌다.
    원문 보기
  4. 4

    이번에 데브포스트 OAI 빌드위크에 제출한 영상입니다. 전부 Codex로 스토리보드 편집 인코딩 했고, 음성만 Qwen TTS 로 로컬에서 만들었습니다.

    https://t.co/8YkgAftbag

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 OpenAI 빌드위크 제출 영상에서 스토리보드·편집·인코딩을 Codex로 진행하고, 음성은 로컬 Qwen TTS로 만들었다고 제작 과정을 남기셨습니다. 제출을 마친 뒤 오랜만에 개발 서버를 끄자 사무실이 조용해졌다는 후속 기록이 작업의 밀도를 전해 줍니다.

결과물 뒤에 준비와 업로드, 제출 뒤의 휴식 기록을 함께 보충하니 짧은 소개에 작업의 시간이 붙습니다. Codex와 로컬 음성 모델의 역할을 구분해 적은 점도 좋습니다. 이 글은 도구의 우열을 입증하는 벤치마크보다 여러 도구를 한 편의 영상으로 연결한 제작 기록으로 읽을 수 있습니다.

원문 기록맥락과 해석

SINGLE POSTX POST ARCHIVE

제출용 동영상 제작 중.

1개 글

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1
    제출용 동영상 제작 중. Codex 영상 제작+편집 우수한 수준은 아닌데 그래도 나쁘진 않네. 보이스는 Qwen TTS. https://t.co/z66WlrtD9i
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 제출용 동영상을 제작하며 영상 편집 도구인 코덱스와 큐웬의 음성 합성 기술을 활용하신 것으로 보입니다. 다만 코덱스의 영상 제작 및 편집 수준이 아주 우수하지는 않으나 수용 가능한 정도라는 판단은 개인적인 사용 경험에 기반한 주관적 평가이며, 이를 뒷받침할 객관적인 성능 지표나 공식 자료는 확인되지 않습니다. 따라서 해당 도구들의 실제 성능 수치나 품질에 대해서는 추가적인 확인이 필요합니다.

이 기록은 특정 기술의 절대적 성능을 증명하기보다, 로컬 환경에서 여러 모델을 조합해 결과물을 만들어내는 과정에서의 시행착오와 체감 성능을 보존하는 데 의미가 있습니다. 외부에서 검증 가능한 1차 자료가 부족한 상태이므로, 이 글은 기술적 사실의 선언이라기보다 개인의 작업 맥락이 담긴 운용 기록으로 읽는 것이 적절합니다. 도구의 한계를 인지하면서도 목적에 맞게 활용하려는 Serio님의 실험적인 접근 방식이 돋보이는 대목입니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1
    로컬에서 실행할 수 있는 27B 가 필요해요. https://t.co/PL2NevjFT9
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 로컬 환경에서 구동 가능한 270억 매개변수 규모의 모델이 필요하다는 짧은 바람을 남기셨습니다. 이는 특정 작업 수행을 위해 적절한 성능과 효율성의 균형을 갖춘 모델을 찾고 계신 상황으로 보이며, 개인적인 사용 경험과 필요에 기반한 솔직한 갈증이 느껴집니다. 다만 구체적으로 어떤 용도로 이 규모의 모델을 원하시는지, 혹은 현재 어떤 대안을 검토 중이신지에 대해서는 명시되지 않아 정확한 맥락 파악을 위해서는 추가적인 확인이 필요합니다.

기술적인 세부 사양이나 공식적인 벤치마크 결과보다는, 당시 Serio님이 느끼셨을 필요성과 작업 환경의 제약이 더 크게 다가오는 글입니다. 외부에서 검증 가능한 객관적 자료보다는 개인의 주관적인 필요가 중심이 된 기록이기에, 이를 단순한 정보 전달이 아닌 하나의 사용 경험으로 읽어내는 것이 적절해 보입니다. 효율적인 로컬 환경 구축을 향한 Serio님의 고민이 닿아, 머지않아 만족스러운 모델을 찾으셨기를 바랍니다.

생활 맥락원문 감상

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1
    아 그래서 3.7 27b 3.8 27b는 언제나오냐고요 현기증난단 말이에요 빨리 주세요 ㅋ
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 특정 모델의 업데이트 버전을 간절히 기다리는 마음을 재치 있는 표현으로 남기셨습니다. 구체적인 버전 숫자를 언급하며 빠른 출시를 바라는 모습에서, 새로운 기술이 가져올 변화에 대해 얼마나 큰 기대감을 품고 계신지가 고스란히 느껴집니다.

다만 언급하신 모델들의 정확한 출시 일정에 대해서는 공식적으로 확인된 자료가 없어 현재로서는 확인이 필요합니다. 그럼에도 불구하고 이러한 갈증은 그만큼 Serio님이 해당 분야의 흐름을 민감하게 살피며 최적의 도구를 찾으려는 열정을 가지고 계시기에 나오는 반응이라고 생각합니다.

생활 맥락원문 감상