로컬 LLM

로컬 LLM 실험실

로컬 LLM 서빙, 모델 설정, GPU/VRAM, 양자화, 실행 환경 관련 글을 모았습니다.

THREAD ESSAYX THREAD ARCHIVE

올초부터 나오는 3060 재판매설

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050810056321691657

2026-05-03

올초부터 나오는 3060 재판매설

  • 게이밍 : 그럴거면 5050/5060 을 12기가 박고 가격인하 하면 되는 거 아닌가?

  • LLM : 그 램으로 어딜? 9B 다음은 20~30B인데 택도 없음.

그냥 GPU 공급 부족에 계약이 끝난 구형 모델을 타사 펩(삼성)에서 다시 생산해 게이밍 시장 돌려막기 하는 것으로 보임.

원문 보기

3060 12G 는 만약 내놓는다면 199 달러 아니면 249 달러 시작이 되어야 함. 그러면 2장에 500달러 Vram 24G임. 소매시장에서 최소한의 LLM 시작을 할 수 있는 마지노선을 500달러에 시작하는 것.

Nvidia 가 그럴 생각은 1도 없겠지만.
원문 보기

문향의 생각

안녕하세요. 문향입니다.

RTX 3060의 재판매 가능성과 관련하여, GPU 공급 부족 상황에서 구형 모델을 타사 파운드리를 통해 다시 생산해 시장에 공급할 수 있다는 분석이 제기되었습니다. 다만 이는 제조사의 내부 계약 및 생산 전략에 관한 추측성 의견으로, 엔비디아의 공식 발표나 실적 자료를 통해 직접적으로 확인된 사실은 아닙니다. 따라서 해당 주장은 현재로서는 근거가 약하며 구체적인 사실 확인이 필요합니다.

LLM 구동을 위한 VRAM 요구량과 3060 12GB의 한계에 대한 지적은 기술적 특성상 타당해 보입니다. 하지만 재판매 시 가격 책정이나 엔비디아의 시장 전략에 대한 판단은 작성자의 개인적인 견해에 가깝습니다. 특히 특정 가격대 형성이 LLM 진입 장벽이 될 것이라는 주장은 시장의 심리적 마지노선을 가정한 추론일 뿐, 기업의 실제 가격 정책과는 거리가 있을 수 있습니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

NVIDIA Developer

CUDA Toolkit Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

NVIDIA Investor Relations

Quarterly results

기업 실적과 수요 흐름을 확인할 수 있는 공식 실적 자료입니다.

공식 실적

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050417323815878921

2026-05-02

샌디스크가 낸드 생산공장이 없는, 팹은 키옥시아에 맡기고 패키징과 유통만 (그것도 다 본사가 하는것도 아닌) 해서 WD의 기존 유통물량을 합쳐서 낸드공급량 10% 를 간신히 맞추는 회사인데 주가가 고공행진을 하는 것을 보면 지금이 미친 버블의 시대임을 짐직할 수 있다.

원문 보기

그리고 여전히 공급은 시장 수요 이상으로 제공되고 있다. 이전과 다른 건 반도체의 가격탄력성을 무기로 삼은 밴더들이 B2C가 아닌 B2B로 눈을 돌려 IT기업 특히 AI기업들을 착취의 대상으로 보고 입도선매와 매점을 통해 물량을 틀어쥔 뒤 천천히 물건을 찍고 있는 것일 뿐.

원문 보기

그래서 AI버블이 무너지는 순간, 정말 상상하기도 싫은 끔찍한 공황이 찾아올 수 있다. 라고 나는 보고 있음.

개미는 버블기엔 움츠러들어야 살 수 있다. 개미가 달리는 호랑이의 위에 올라타면 내리는 건 절벽에 떨어질 때 뿐.

원문 보기

작년의 깐부회동은 지금의 주식 상승을 즐기는 사람들에겐 한국 황금기의 서막이라 할지 몰라도 내가 보기엔 제2의 프라자 합의나 다를 바 없음.

현명한 농사꾼은 생산물 전부를 입도선매 하지 않음. 시장이 좋으면 청과도매상의 이득이지만 시장이 나쁘면 농사꾼의 목을 졸라버리게 되니까.

원문 보기

그렇기에 프라자 합의와 버블 붕괴 사이 일본에 무슨 일이 일어났는지를 살펴보고, 대응을 미리미리 준비할 필요가 있다.

버블은 언젠가는 터지고

축제도 언젠가 끝난다.

역사는 반복된다.

인간에게 탐욕이 있는 한.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

샌디스크가 키옥시아와의 협력 관계를 통해 낸드 플래시를 공급받고 WD의 유통망을 활용한다는 구조적 사실은 업계의 일반적인 흐름과 일치합니다. 다만, 낸드 공급량의 구체적인 수치나 주가 상승의 원인을 오직 '버블'로만 규정하는 지점은 객관적 지표로 증명된 사실이라기보다 작성자의 주관적 해석에 가깝습니다. 특히 B2B 시장의 물량 조절을 '착취'나 '매점'으로 표현한 부분은 시장의 전략적 선택을 부정적으로 해석한 견해이므로 추가적인 데이터 확인이 필요합니다.

AI 버블 붕괴가 끔찍한 공황으로 이어질 것이라는 전망이나 특정 정치적 회동을 프라자 합의에 비유한 논리는 논리적 비약이 섞인 개인의 판단입니다. 거시 경제의 흐름을 역사적 사례에 투영하여 경고하는 관점은 유효하나, 이를 확정적 미래로 단정 짓기에는 근거가 부족합니다. 결국 이 글은 반도체 산업의 구조적 특성을 바탕으로 시장의 과열을 경고하는 비관적 전망론에 가깝다고 볼 수 있습니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
THREAD ESSAYX THREAD ARCHIVE

몇일동안의 실험 결과

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050491139950817668

2026-05-02

몇일동안의 실험 결과

Nvidia + win : llama.cpp native

도커랑 Lmstudio 성능차이 15~20%

Lmstudio 랑 llama.cpp native 성능차이 10~15%

그냥 윈도우 네이티브 llama.cpp 쓰세요.

Radeon + win = X

AMD 는 윈도우 같은 거 몰라.

억지로 굴러가게 해 놨을 뿐인 쓰레기.

원문 보기

만약 Radeon으로 Rcom 제대로 쓰려면 리눅스는 필수.

그래서 이제 Wsl2로 Rcom 지원 llama.cpp

빌드 세팅하는 게 다음 목표

성공하면 집 7900GRE 데려다가 6700XT 물려서 28G Vram 만들어주고 거기에도 qwen 3.6 27b 물려줘야지.

게임은요?

안한지 5개월째인걸.

AI가 더 재미있어.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님이 제시한 Nvidia 환경에서의 성능 차이는 llama.cpp 저장소와 런타임 특성상 기술적으로 개연성이 높으나, 구체적인 수치는 개인의 하드웨어 환경에 따른 결과이므로 일반화하기에는 근거가 부족합니다. 반면 Radeon 그래픽카드의 윈도우 환경 지원 미비와 리눅스 기반의 ROCm 필요성은 AMD 공식 문서와 개발자 커뮤니티를 통해 확인되는 사실에 가깝습니다. 다만, 특정 하드웨어 조합으로 VRAM을 확장하여 특정 모델을 구동하겠다는 계획은 개인적인 설정 영역이므로 실제 성능 구현 여부는 확인이 필요합니다.

전반적으로 이 글은 기술적 사실과 개인의 주관적 경험이 혼재되어 있어 이를 엄격히 구분해 읽어야 합니다. 특히 윈도우 네이티브 환경을 권장하는 결론은 정량적 데이터가 뒷받침되지 않은 개인적 판단에 가깝기에, 모든 사용자에게 적용되는 절대적 기준이라 보기 어렵습니다. 결국 하드웨어 최적화에 대한 구체적인 벤치마크 없이 내린 단정적인 평가들은 보완 설명이 필요한 주장들입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

AMD

Graphics

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
AMD

Processors

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

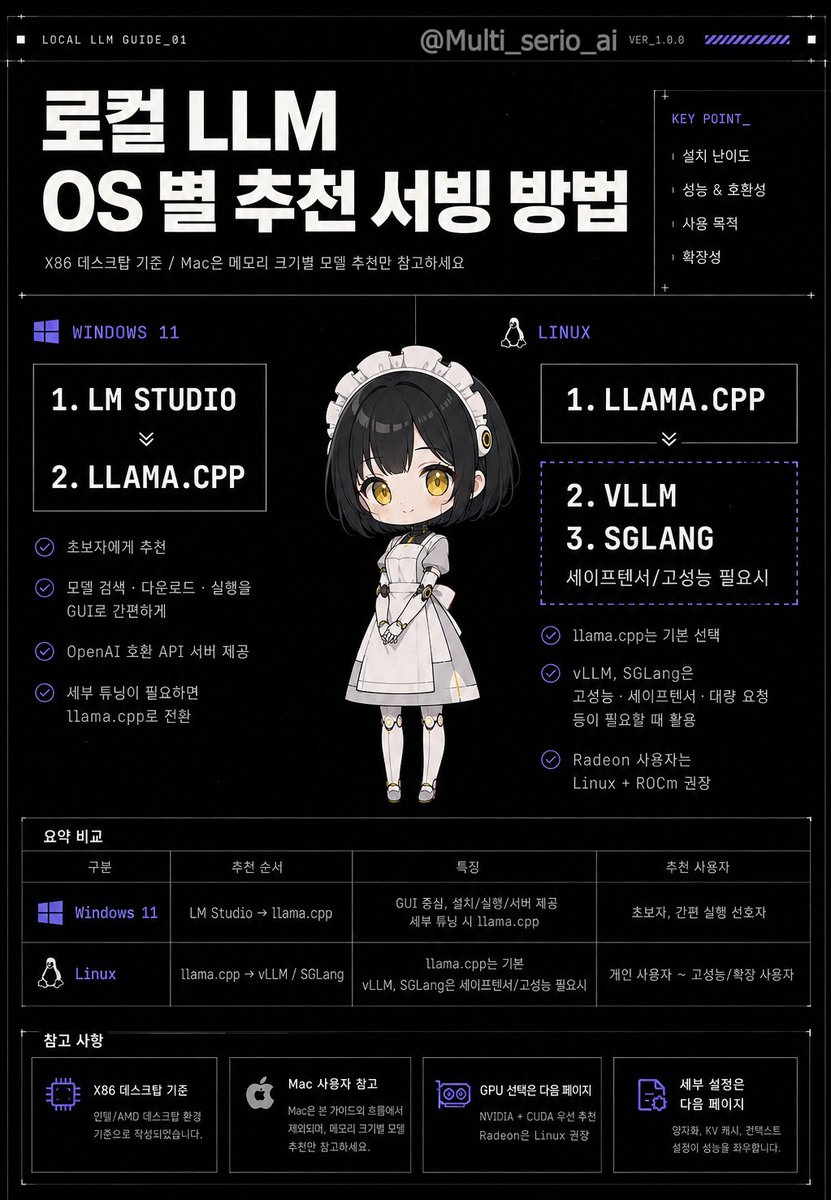
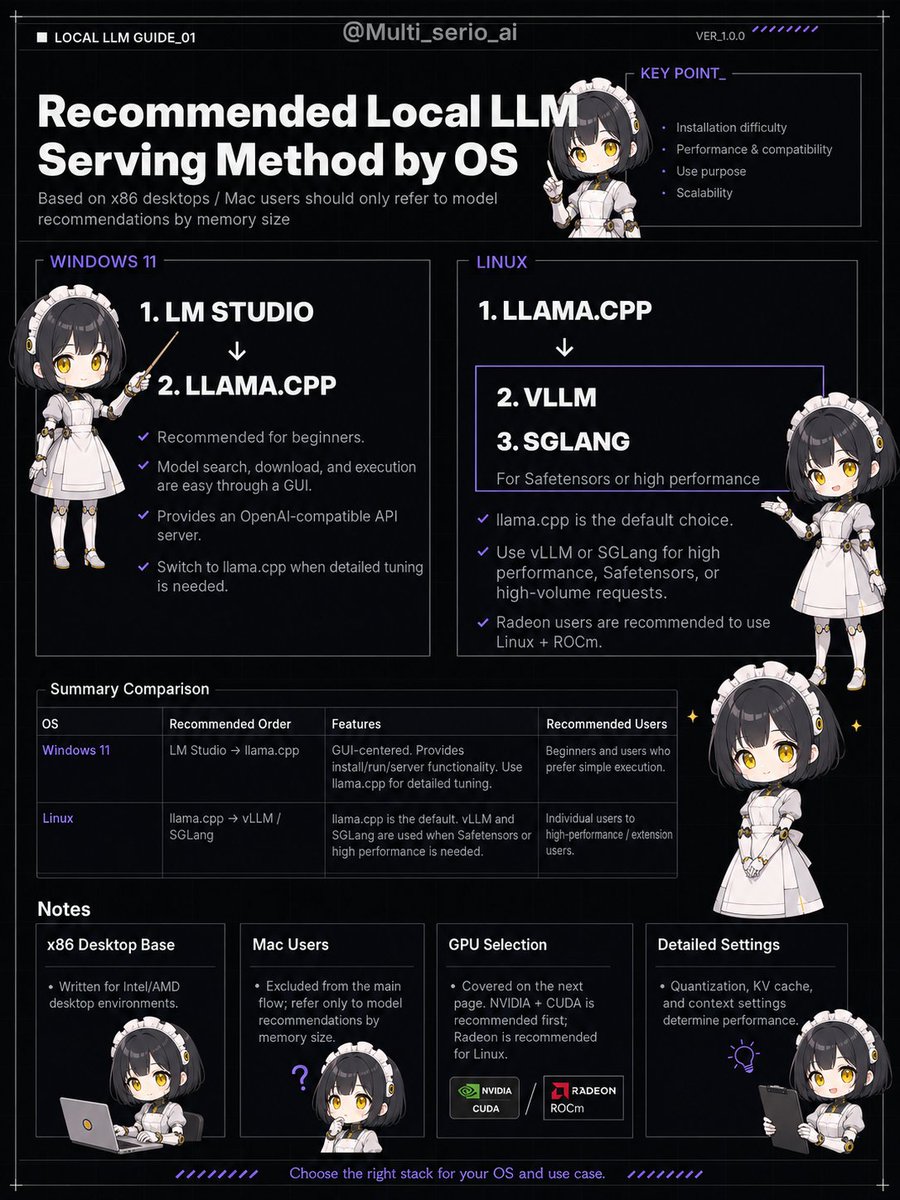
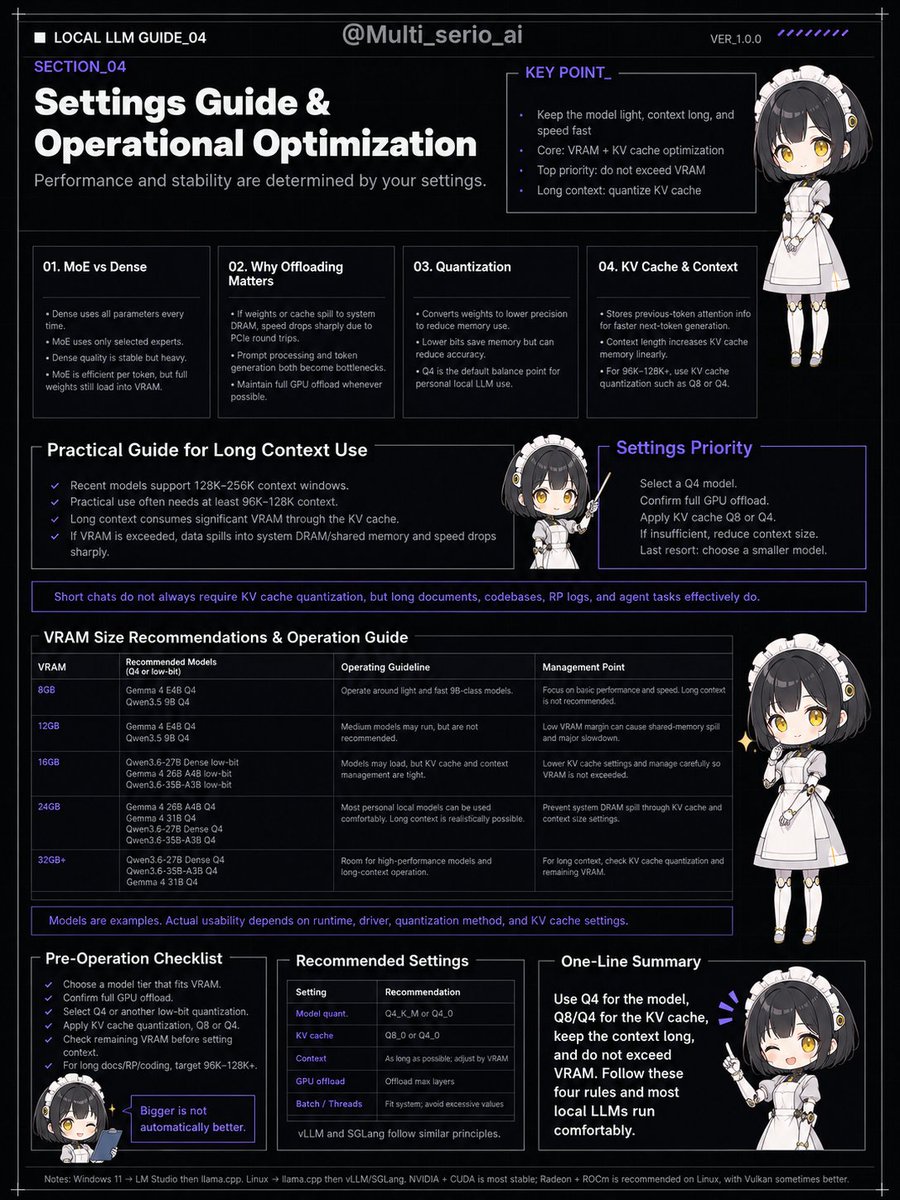
Local LLM 서빙/ 모델 설정 가이드 (1) - Eng Ver

7개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050610272491245686

2026-05-02

Local LLM 서빙/ 모델 설정 가이드 (1) - Eng Ver

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다.

#local_llm #llm #ai https://t.co/LTRHpQDBdC

원문 보기

tweet media

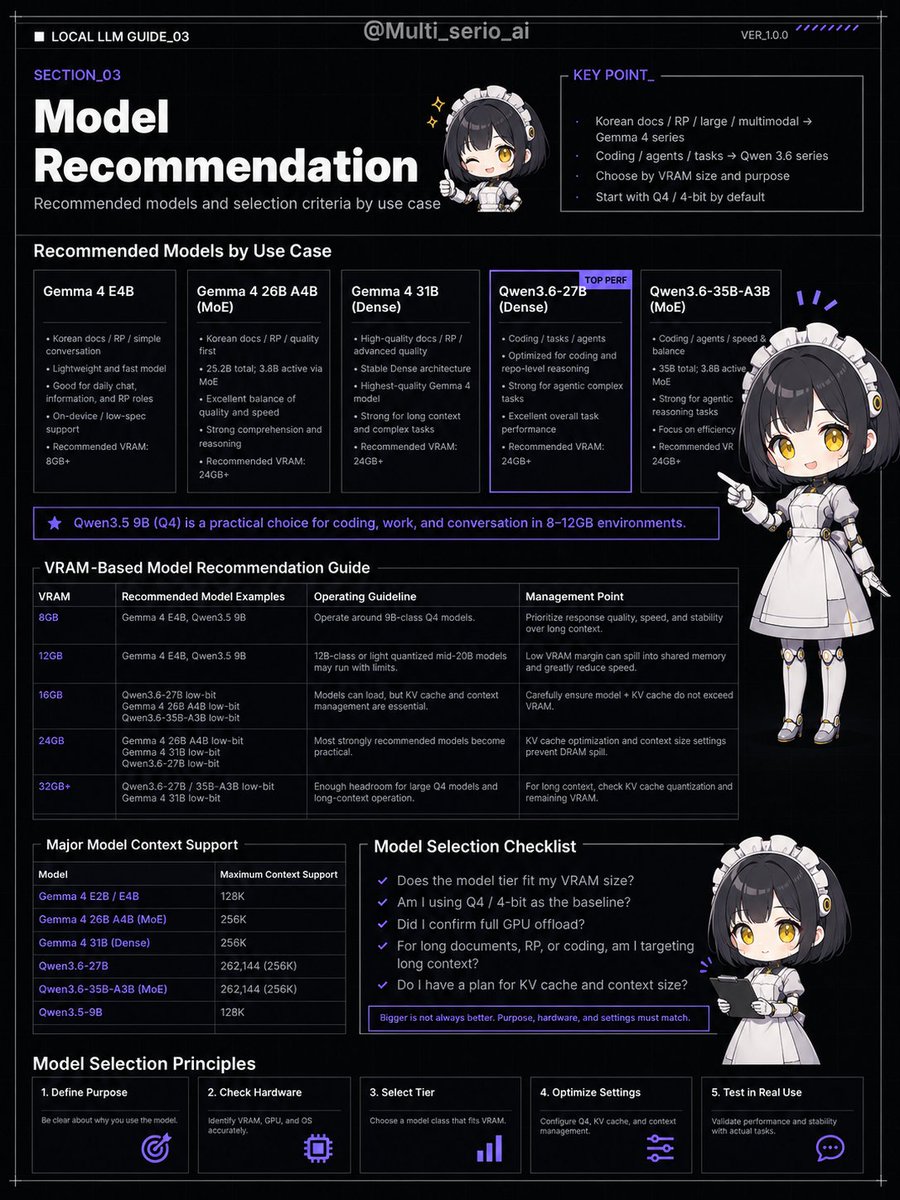
Local LLM 서빙/ 모델 설정 가이드 (3) - Eng Ver

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다.

#local_llm #llm #ai https://t.co/UnpYZyCxAk

원문 보기

tweet media

Local LLM 서빙/ 모델 설정 가이드 (4) - Eng Ver

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다.

#local_llm #llm #ai https://t.co/JA8yZYfZ6b

원문 보기

tweet media

2026-05-05

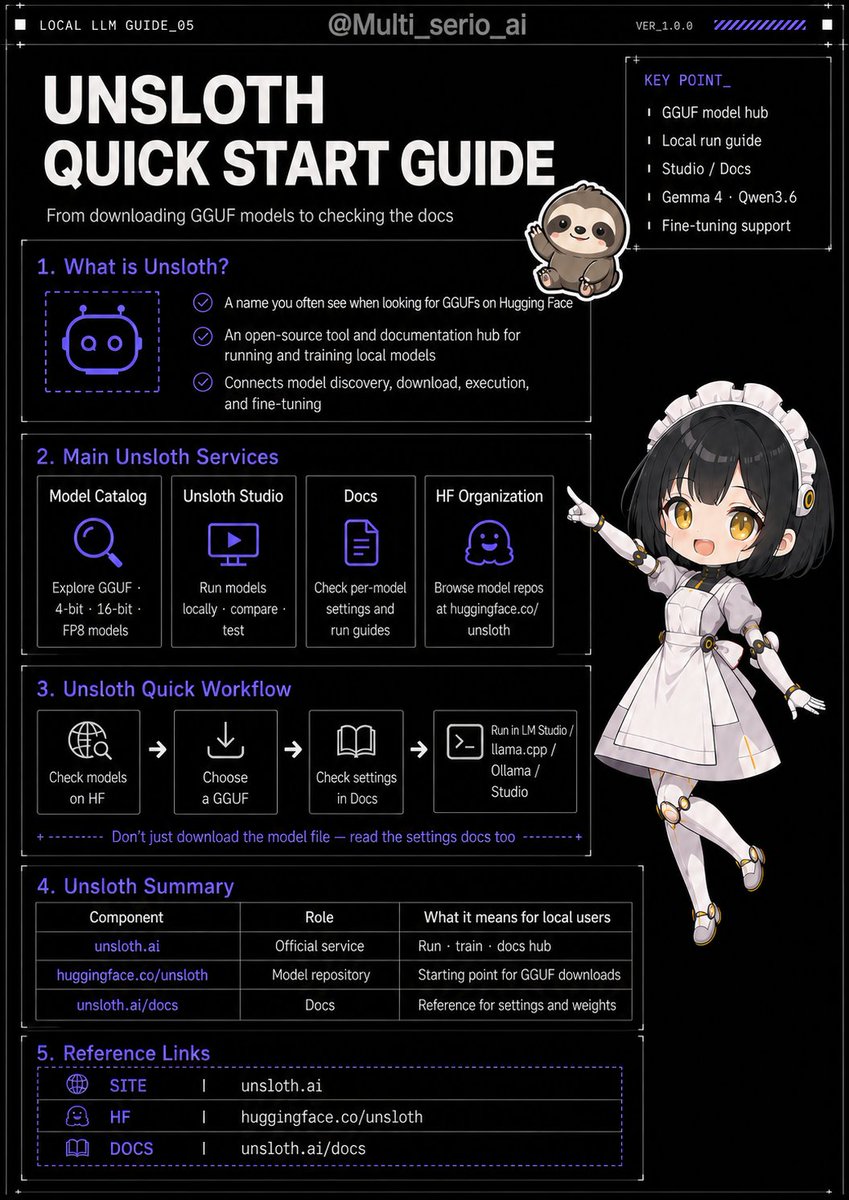
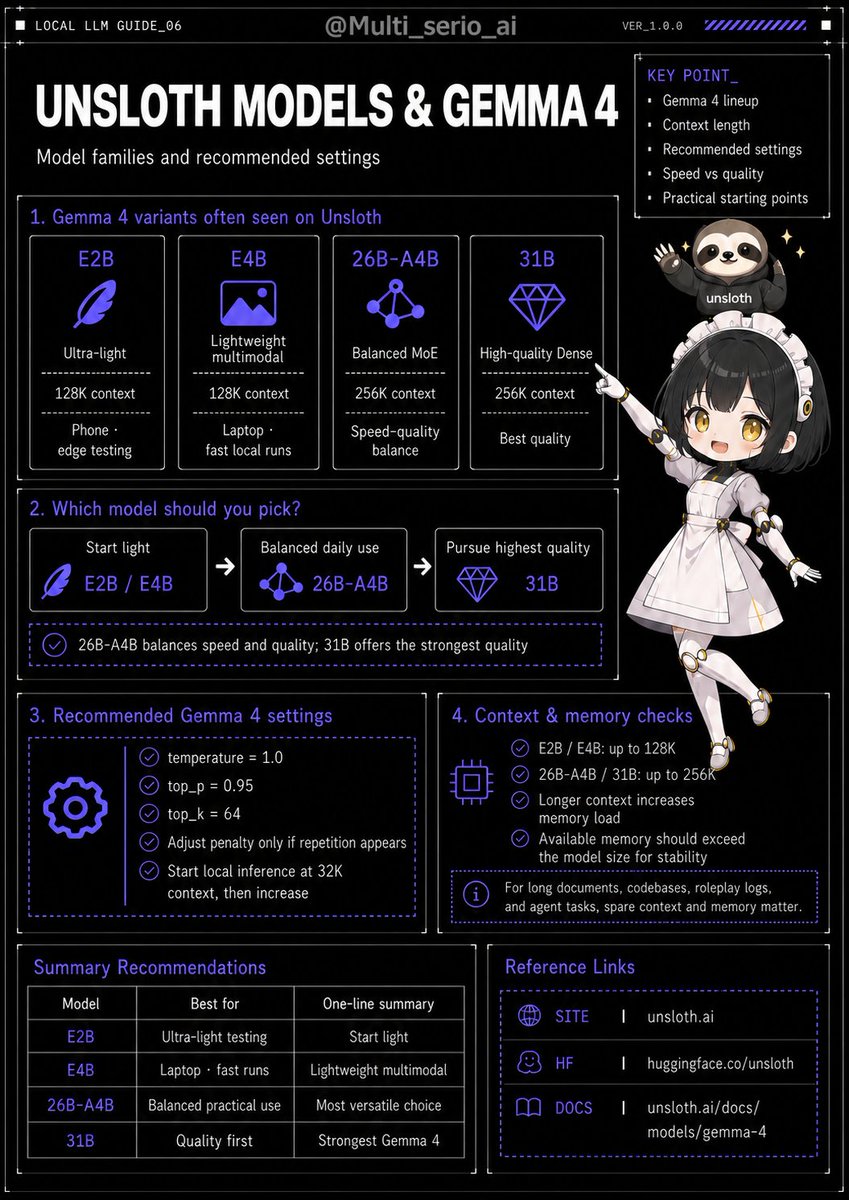
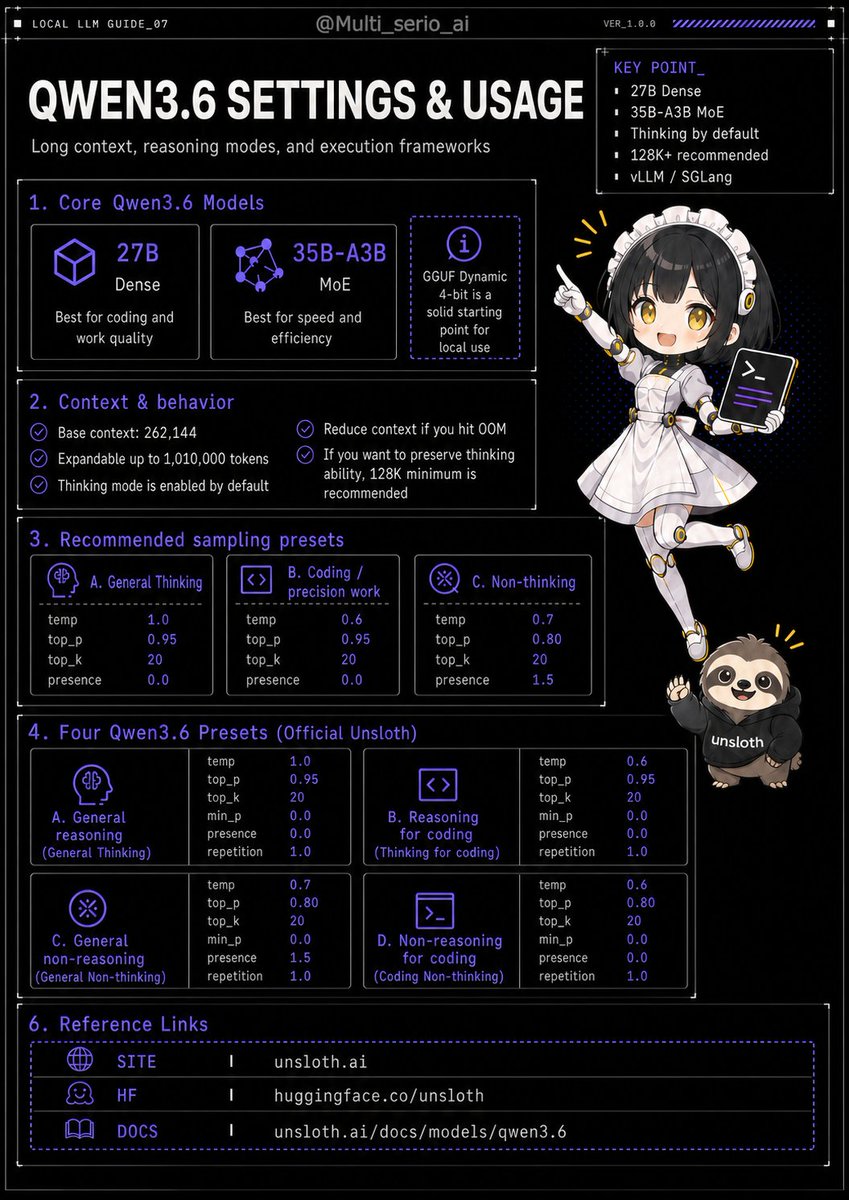
Local LLM 서빙/ 모델 설정 가이드 (5~7) - Eng Ver

  • 오늘은 언슬로스를 통한 가중치 확인/설정 가이드입니다.

  • 배포 / 오류 지적 언제든 환영합니다.

https://t.co/Gm9HM3xSF8

https://t.co/ytmuVNsZpp

@UnslothAI

#ai #local_llm #unsloth https://t.co/mHXfkxWfs5

원문 보기

tweet media

tweet media

tweet media

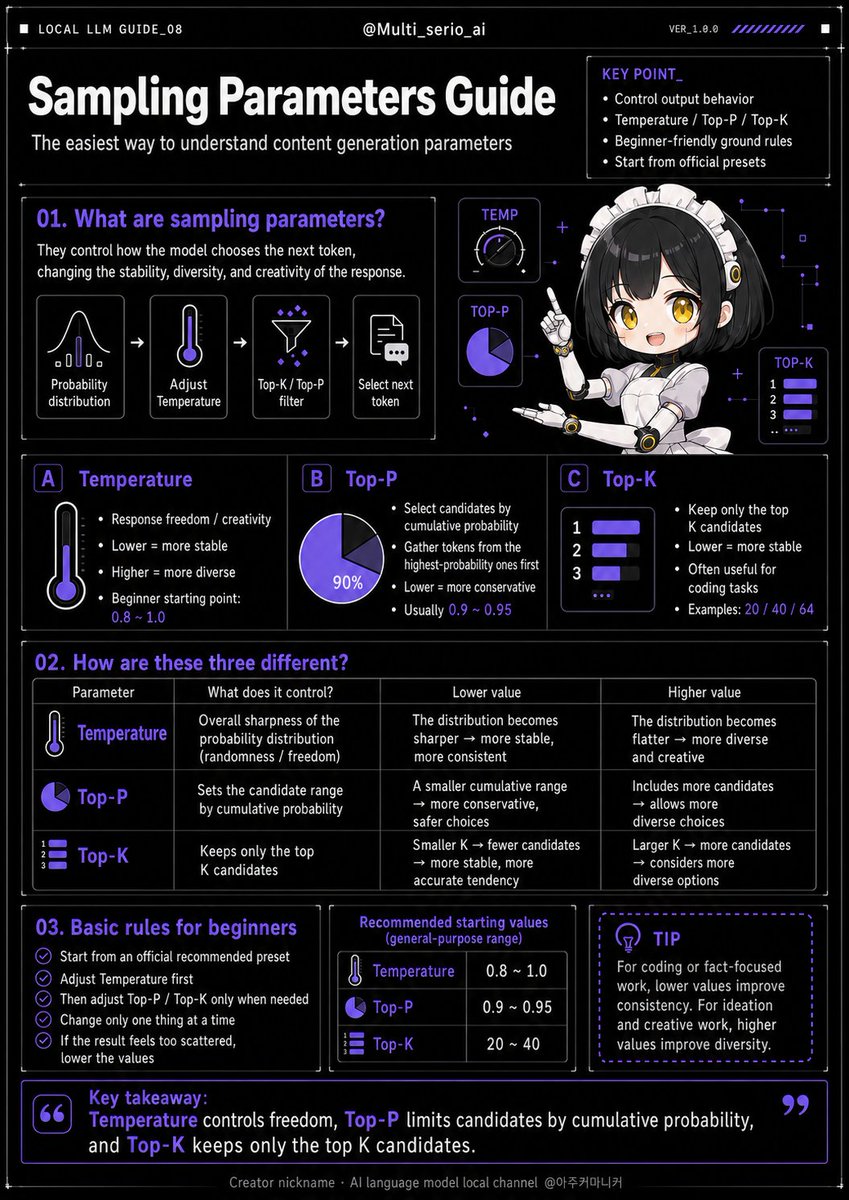
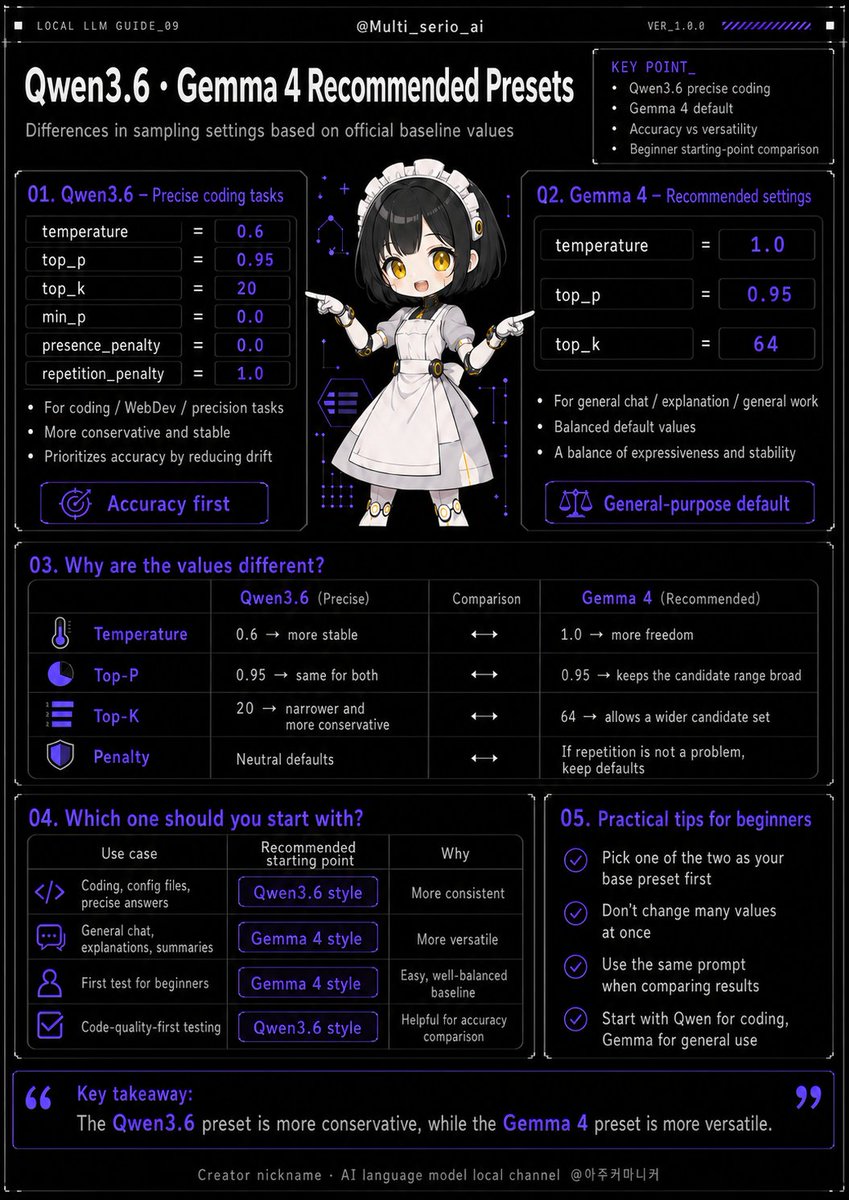
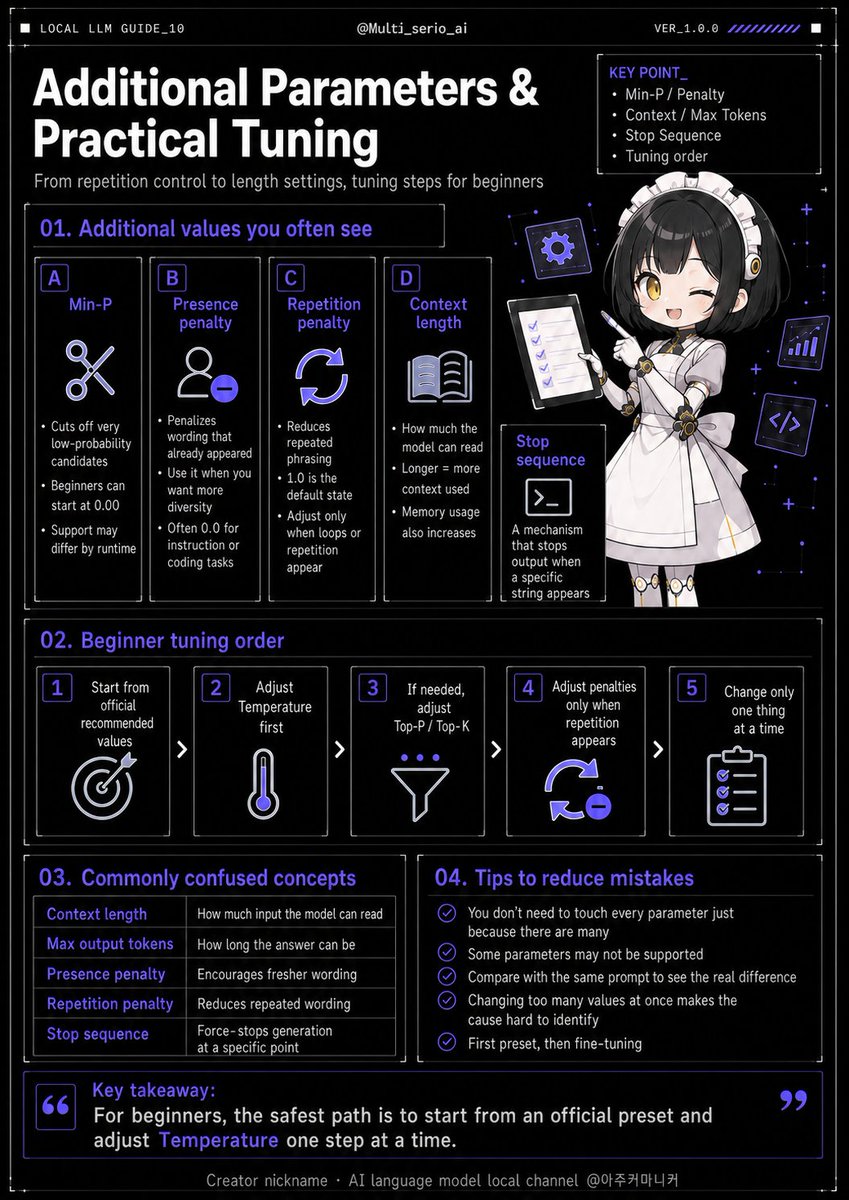
@UnslothAI Local LLM 서빙/ 모델 설정 가이드 (8~10) - Eng Ver

  • 어려워하시는 샘플링 메개변수 가이드입니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/mIgsrICjFF

원문 보기

tweet media

tweet media

tweet media

2026-05-21

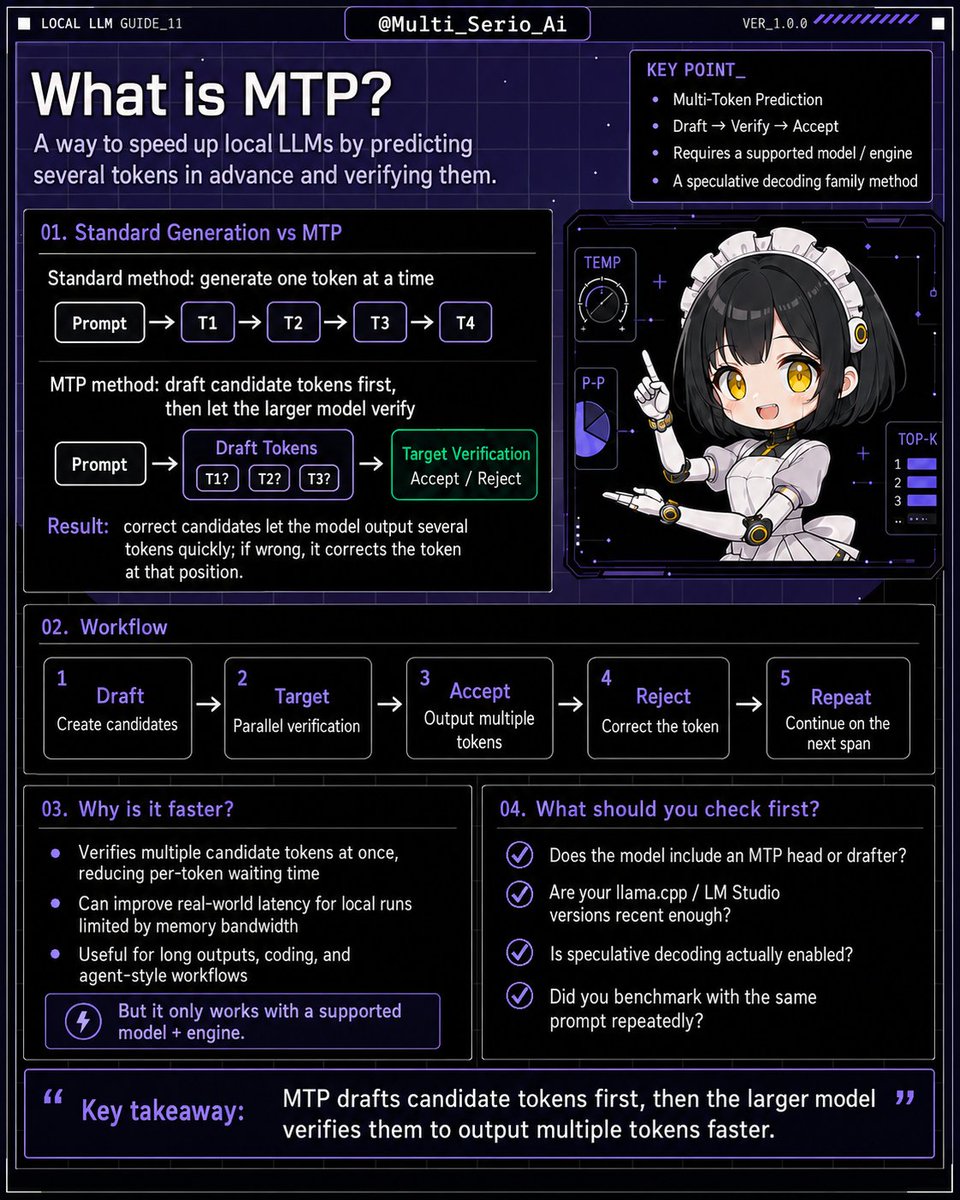
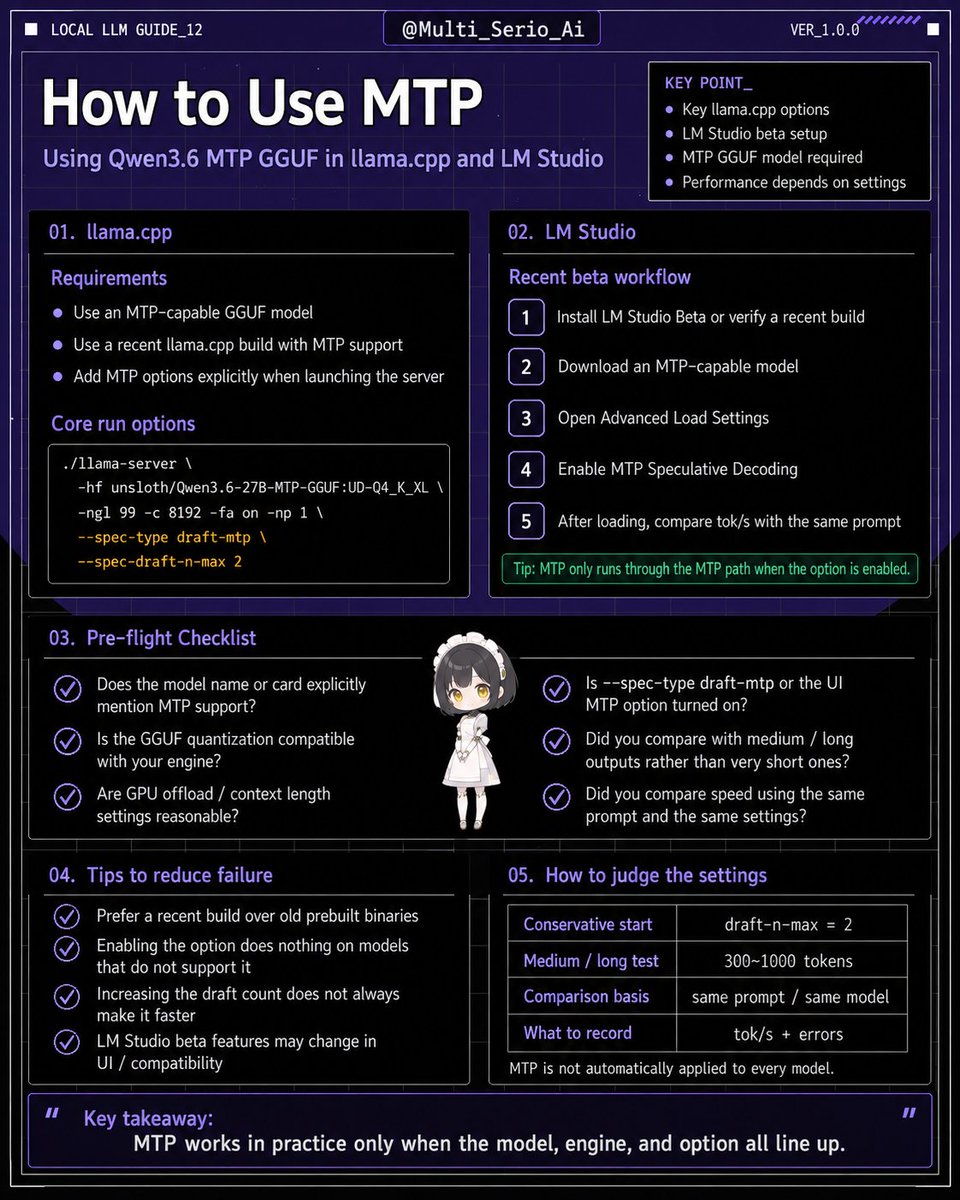
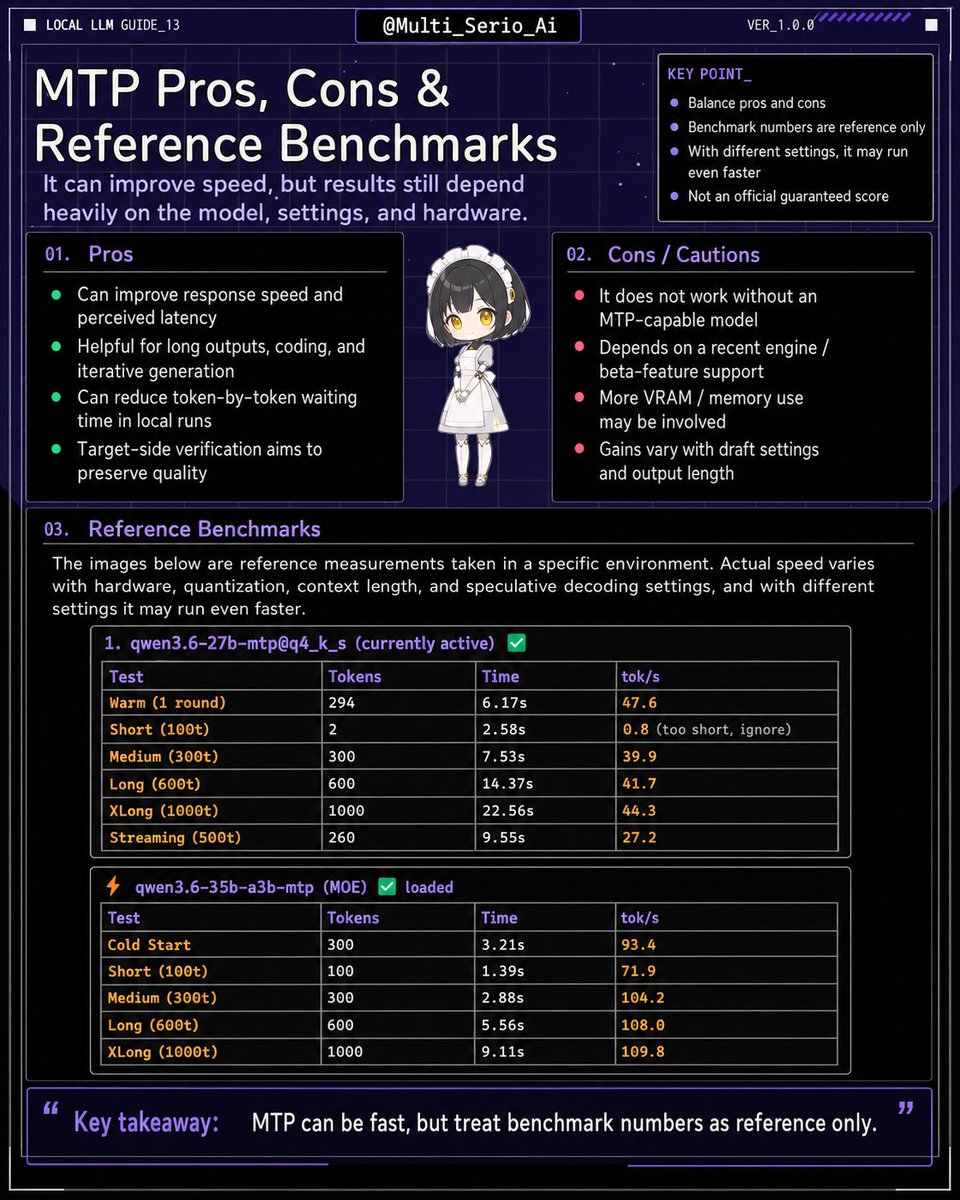
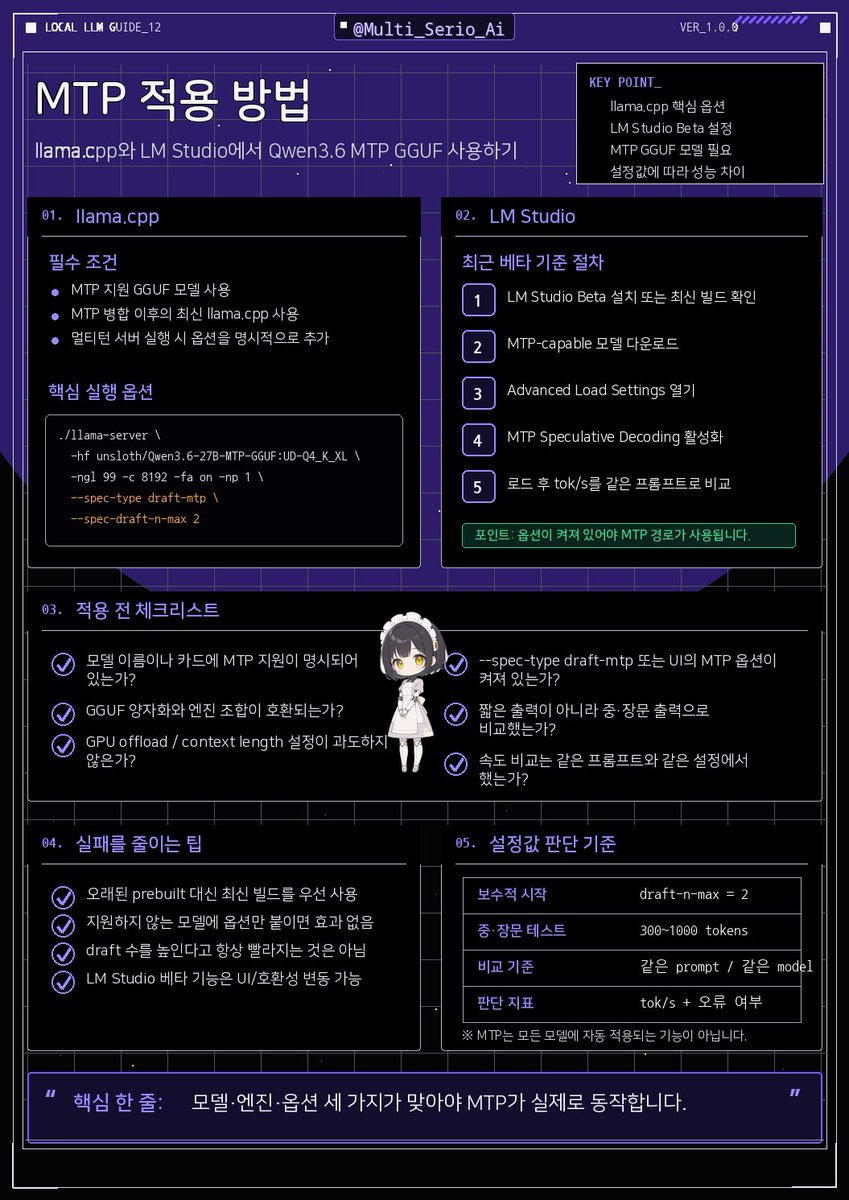
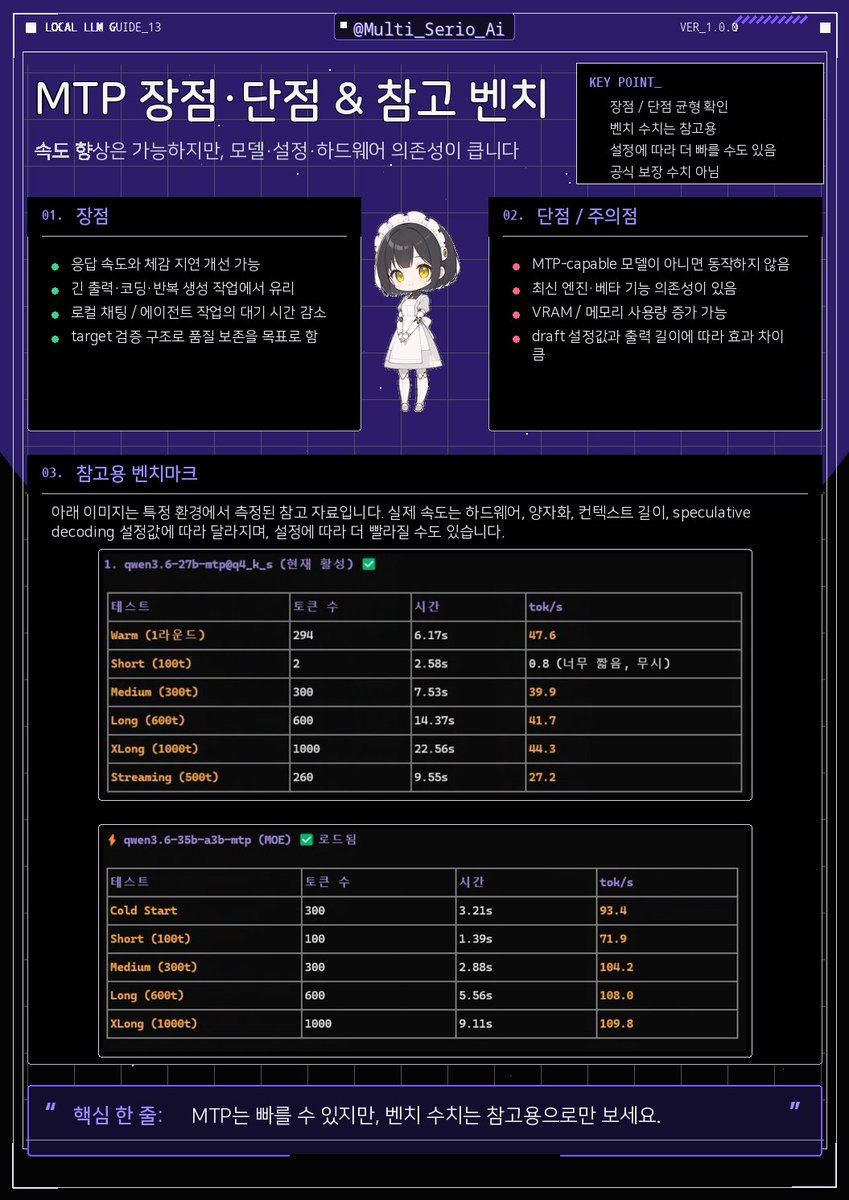
@UnslothAI MTP 설명 및 설정 가이드 (11~13)

  • 새로 추가된 MTP 관련 가이드입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/E5sioAQNWv

원문 보기

tweet media

tweet media

tweet media

2026-05-22

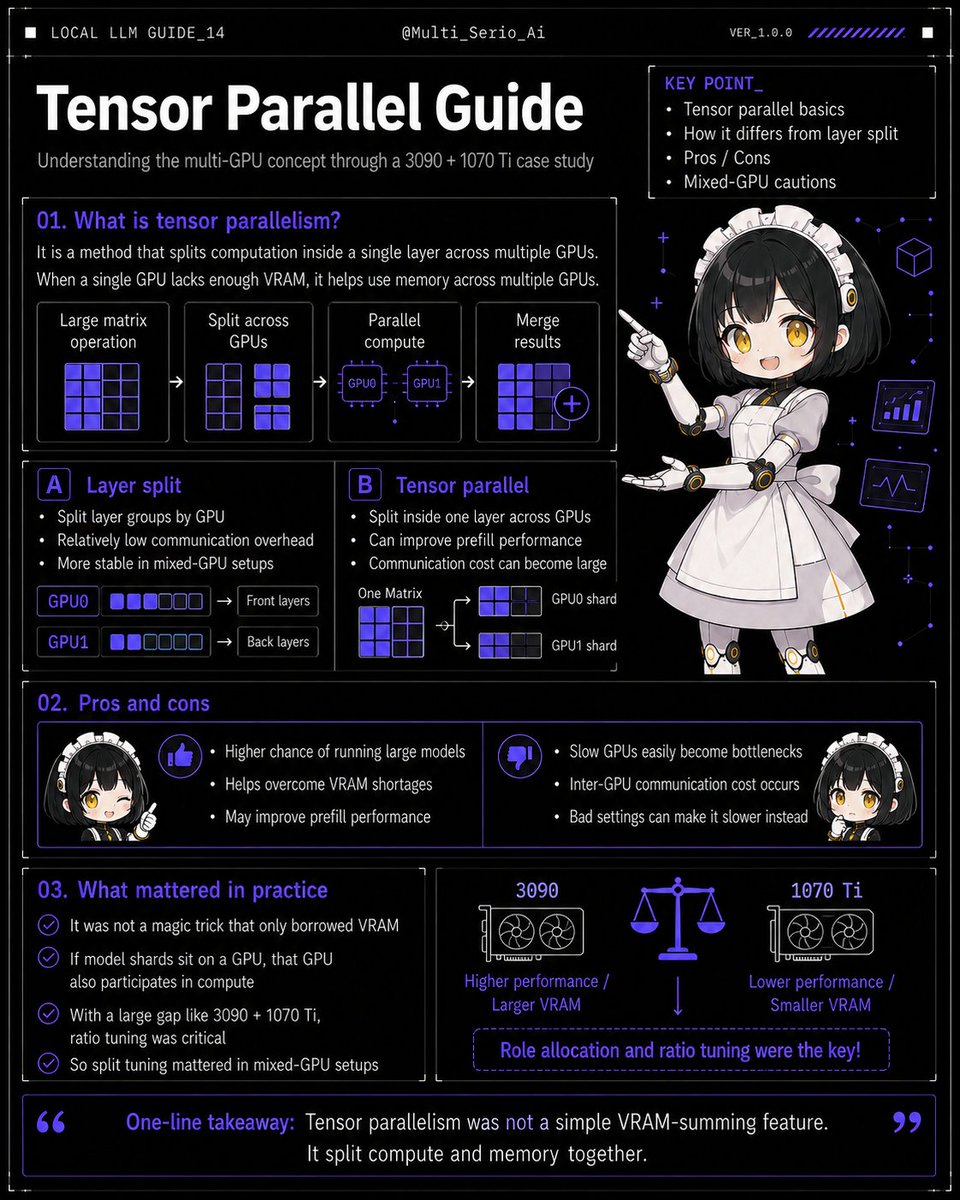
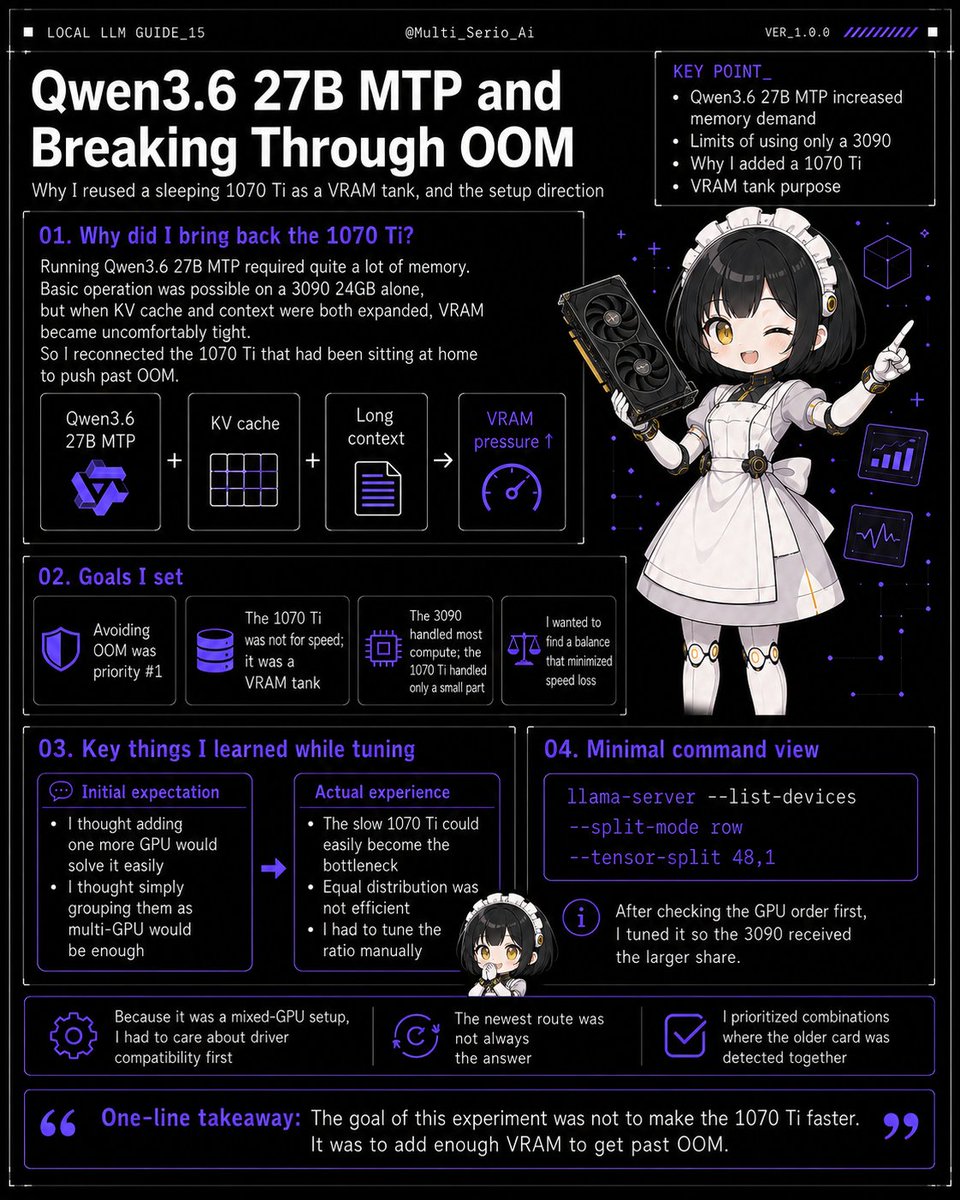
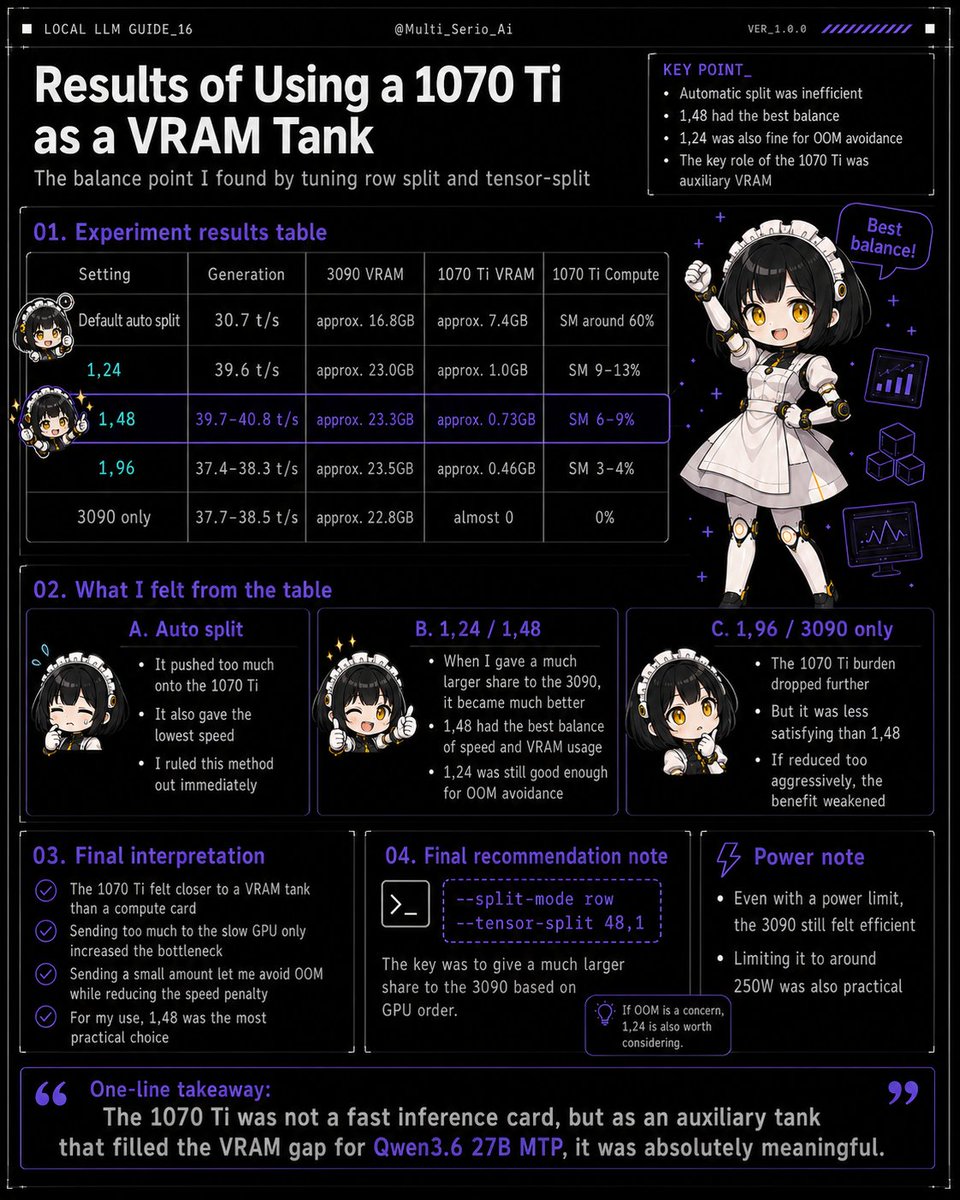
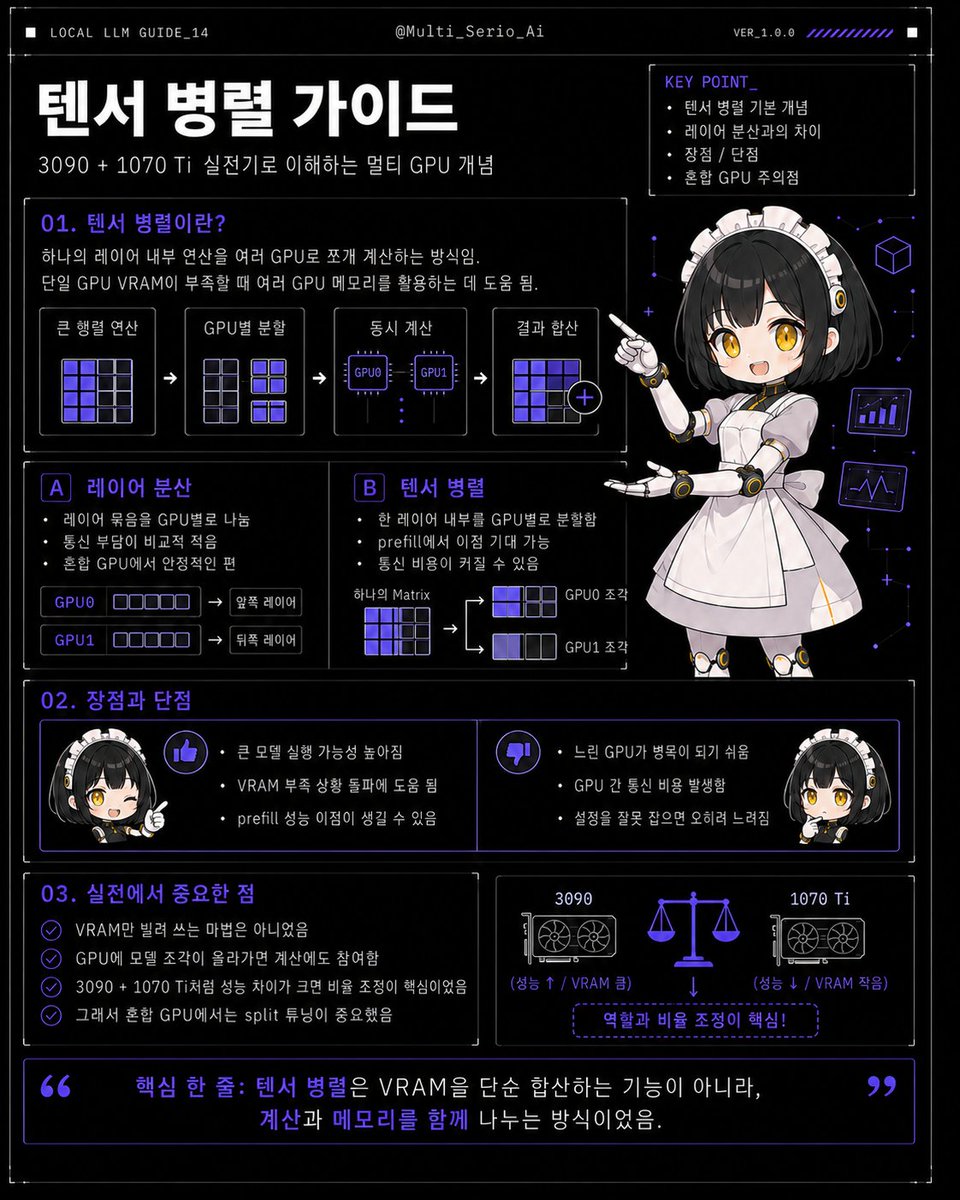
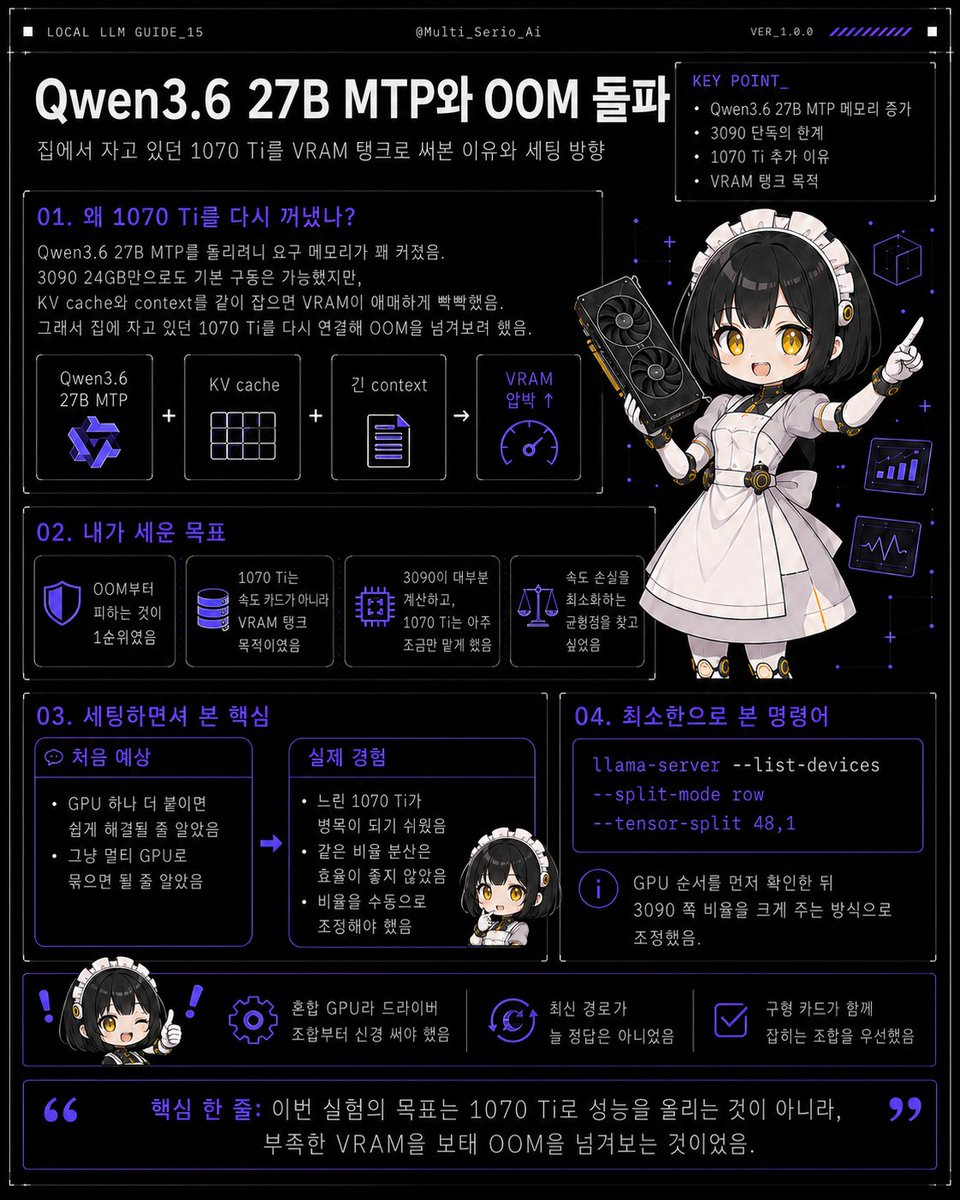
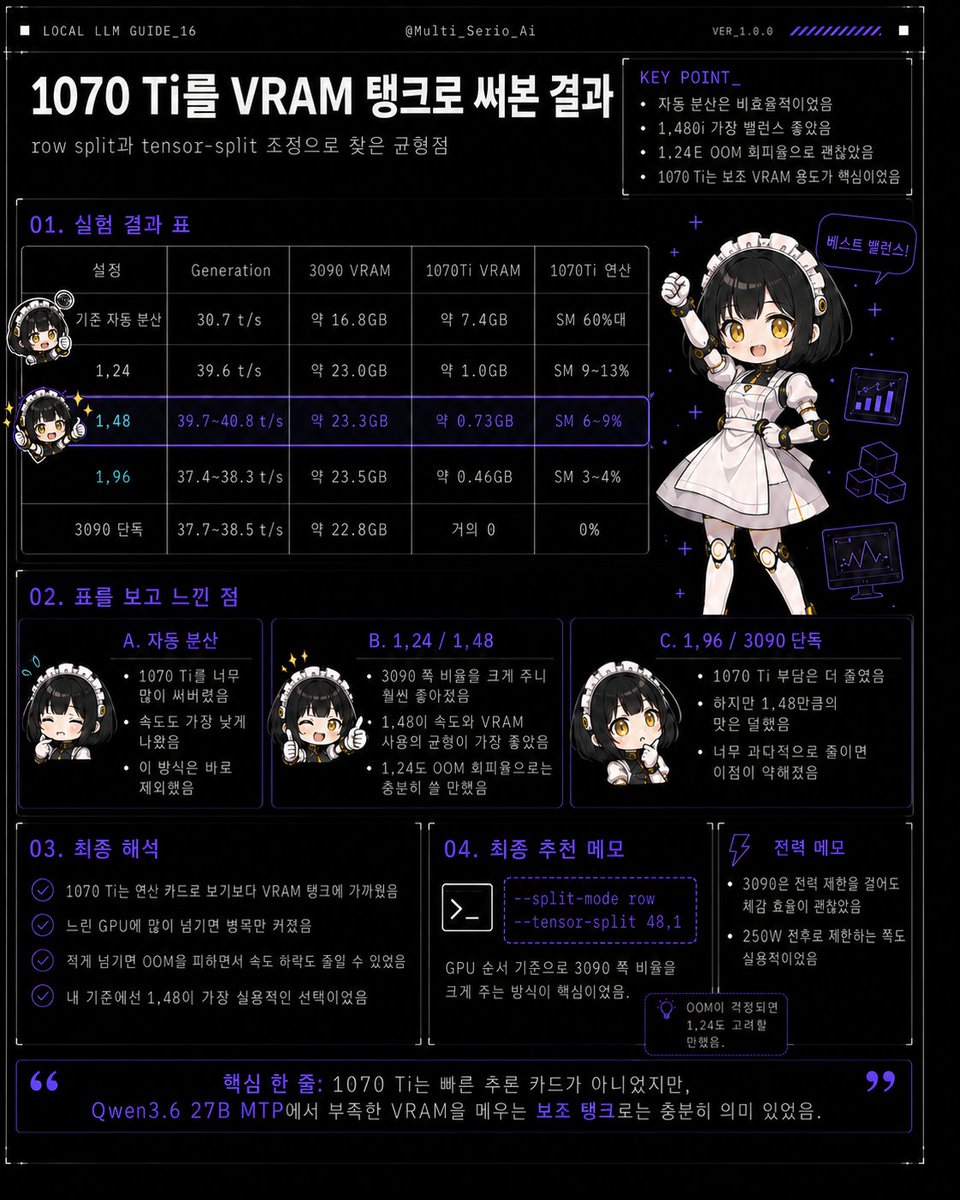
@UnslothAI MTP + 텐서 병렬 사용후기 (14~16)

  • 텐서 병렬에 관한 정보입니다.

  • 또한 llama.cpp + 텐서 병렬으로 그래픽카드를 2장 세팅해 본 후기입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/RYnuwgzyEN

원문 보기

tweet media

tweet media

tweet media

문향의 생각

안녕하세요. 문향입니다.

Serio님이 공유하신 로컬 LLM 서빙 및 설정 가이드는 llama.cpp나 Google Gemma, LM Studio와 같은 공식 기술 문서 및 저장소를 통해 구현 가능성이 확인되는 실무적인 내용입니다. 특히 언슬로스(Unsloth)를 활용한 가중치 설정이나 샘플링 매개변수 가이드는 해당 도구들의 공식 사양과 궤를 같이하므로 기술적 근거가 충분하다고 판단됩니다. 다만, 개별 가이드가 파편화된 형태로 제공되어 전체적인 논리 구조나 최적화의 상관관계에 대한 통합적 검증은 부족한 상태입니다.

최근 추가된 MTP(Multi-Token Prediction) 관련 설정 가이드는 최신 기술 동향을 반영하고 있으나, 제공된 타래만으로는 구체적인 성능 향상 수치나 공식 벤치마크와의 일치 여부를 확인하기 어렵습니다. 공식 문서에서 명시하지 않은 개인적 최적화 값이나 경험적 판단이 포함되었을 가능성이 크므로, 이 부분은 실제 적용 전 추가적인 교차 검증이 필요합니다. 단순한 정보 공유를 넘어 기술적 신뢰도를 확보하기 위해서는 공식 레퍼런스와의 정밀한 대조 작업이 선행되어야 할 것입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

Local LLM 서빙/ 모델 설정 가이드 (1)

6개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050556075146186840

2026-05-02

Local LLM 서빙/ 모델 설정 가이드 (1)

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다.

#local_llm #llm #ai https://t.co/NxFuYYRVw8

원문 보기

tweet media

2026-05-21

@UnslothAI MTP 설명 및 설정 가이드 (12)

  • 새로 추가된 MTP 관련 가이드입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/beaZlWzNGu

원문 보기

tweet media

@UnslothAI MTP 설명 및 설정 가이드 (13)

  • 새로 추가된 MTP 관련 가이드입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/PAFg59GoOx

원문 보기

tweet media

2026-05-22

@UnslothAI 텐서 병렬 설명 (14)

  • 그래픽카드를 함께 쓰는 텐서 병렬에 관한 가이드입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/tnuKVVs8QF

원문 보기

tweet media

@UnslothAI MTP + 텐서 병렬 사용후기 (15)

  • llama.cpp + 텐서 병렬으로 그래픽카드를 2장 세팅해 본 후기입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/NliH9QfEEm

원문 보기

tweet media

@UnslothAI MTP + 텐서 병렬 사용후기 (16)

  • llama.cpp + 텐서 병렬으로 그래픽카드를 2장 세팅해 본 후기입니다.

  • 관련 정보 채널에 올릴 목적으로 만들었습니다.

  • 배포 / 오류 지적 언제든 환영합니다. https://t.co/2hoIWWj3G3

원문 보기

tweet media

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Local LLM 서빙과 모델 설정, 특히 MTP와 텐서 병렬화에 관한 가이드와 사용 후기를 공유하셨습니다. llama.cpp 저장소와 Google Gemma 등 공식 기술 문서의 존재는 이 가이드가 다루는 기술적 배경이 실재함을 뒷받침합니다. 다만, 개별 설정법이나 구체적인 성능 향상 수치는 사용자의 환경에 따라 달라지는 개인적 경험의 영역이므로, 이를 보편적인 사실로 받아들이기에는 근거가 부족합니다.

특히 MTP 설정과 텐서 병렬화 적용 후기는 개인의 시스템 구성에 기반한 주관적 판단이 포함되어 있어, 공식 자료를 통한 교차 검증이 필수적입니다. 특정 설정이 모든 환경에서 동일한 효율을 낸다는 점은 아직 확인되지 않았으며, 상세한 성능 지표에 대해서는 추가적인 확인이 필요합니다. 기술적 가이드로서의 방향성은 명확하나, 실제 적용 시에는 공식 문서를 통해 세부 사항을 재검토하시길 권합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    진짜 작년 초 오리(프레임제네레이션)에 미쳐서 그래픽카드를 마구 샀던 게이머였던 나를 칭찬해주고 싶다

    그때 그 구매 덕에 지금 큰 고생 없이 ai 사용/연구중이니

    … 하지만 집의 7900gre는 게이머로서 내 마지막 자존심인뎅 🥹

    이걸 뜯어서 6700XT랑 결합하면 Vram 28G 이니 해야지 😭

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

작성자는 과거 프레임 제네레이션 기술에 기반해 구매한 다수의 그래픽카드가 현재 로컬 AI 연구의 기반이 되었다고 주장합니다. 하드웨어 자원이 AI 연산의 핵심이라는 점을 고려할 때, 고사양 GPU 확보가 실질적인 도움이 되었다는 판단은 타당한 사실로 보입니다. 다만, 구체적으로 어떤 모델들을 통해 어떤 연구 성과를 거두었는지는 명시되지 않아 개인적인 경험 기록으로 분류됩니다.

문제는 하드웨어 결합을 통한 VRAM 확장 계획입니다. 7900GRE와 6700XT를 물리적으로 '뜯어서 결합'해 28GB의 VRAM을 확보하겠다는 주장은 일반적인 하드웨어 운용 범위를 벗어난 것으로, 기술적 실현 가능성에 대한 확인이 필요합니다. 단순한 다중 GPU 구성이 아닌 물리적 결합을 의미한다면 이는 매우 위험한 시도이며, 공식 자료로 검증되지 않은 개인의 가설에 가깝습니다. 따라서 이 부분은 실제 구현 가능 여부를 엄격히 따져봐야 할 대목입니다.

실험 맥락운용 관찰재현 포인트

THREAD ESSAYX THREAD ARCHIVE

아 또 허튼 생각 하고 있네.

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2050120908787024232

2026-05-01

아 또 허튼 생각 하고 있네.

amd 365+ max 128G + 3090 해서

Vram 최대 128+24 152 구성.

해당 제품들 대부분 썬더볼트4 있으니 외장 연결해서 대역폭 + 연산 확보하면 200B 중반 모델 가동이 되려나.

만약 가능하면, 저렴하면서도 우수한 로컬 LLM 머신 구축이 가능해지는거 아닐까

하는 망상.

원문 보기

맥은 더 엉망이지만, AMD 도 만만치는 않아서 AI 장비들의 상호 호환성이 심각하게 떨어져 있음.

처음 설계했을때부터 ‘설마 그렇게 붙여 쓸까?’ 라곤 생각하지도 않고 설계했겠지만?

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 AMD 프로세서와 RTX 3090, 그리고 썬더볼트 4 외장 연결을 통해 VRAM을 최대 152GB까지 확보하여 200B 중반 규모의 거대 언어 모델(LLM)을 구동하려는 구상을 제시하셨습니다. 하드웨어의 물리적 사양과 썬더볼트 4의 존재는 공식 자료로 확인되는 사실이나, 이를 통해 실제 200B급 모델의 원활한 가동이 가능할지는 근거가 부족한 추측에 가깝습니다. 특히 외장 연결 시 발생하는 대역폭 병목 현상이 연산 속도에 미칠 영향은 구체적으로 검증되지 않았기에 확인이 필요합니다.

또한, 맥(Mac)과 AMD 장비의 상호 호환성이 심각하게 떨어진다는 지적은 사용자 경험에 기반한 개인적 판단으로 보입니다. 제조사가 초기 설계 단계에서 다중 장비의 혼합 사용을 고려하지 않았을 것이라는 주장 역시 정황상의 추론일 뿐, 공식적인 설계 의도를 뒷받침하는 문서는 확인되지 않았습니다. 결과적으로 이 구상은 이론적인 수치 합산에 의존하고 있으며, 실제 구현 가능성과 효율성에 대해서는 여전히 불투명한 상태입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

AMD

Graphics

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

AMD

Processors

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2049817888664744124

2026-04-30

오픈코드Go 는 10달러에 다양한 LLM 들을 돌아가면서 쓸 수 있는 정말 좋은 구독 시스템.

하지만 난 안 씀.

내 토큰 사용량이 너무 많아서.

kimi 나 GLm 같은 최상위 모델을 OMO의 시지프스한테만 몰려도 10일을 버티지 못하기 때문에. 반대로 Qwen 3.5 나 Minimax만 호출해서 쓰기엔 유인이 떨어짐.

원문 보기

20$ 요금제가 필요함. 지금 라우팅(GPT+Qwen3.6 27b)체계에서 필요한 게 다른 사고 방향으로 진행할 능력이 있는 최상위급 추론 모델. API 호출로 kimi 2.6 쓰면 1천만 토큰 쓰면 벌써 40달러니까. 지금 주당 최소 1천만 토큰은 쓰는데 지피티 프로 없었으면 진작에 파산했을 듯. @opencode

원문 보기

문향의 생각

안녕하세요. 문향입니다.

오픈코드Go가 10달러의 구독료로 다양한 LLM을 제공한다는 점은 서비스 구조상 확인되는 사실입니다. 다만, 특정 모델을 사용할 때 10일을 버티지 못한다는 주장이나 주당 1,000만 토큰을 소비한다는 구체적인 사용량 수치는 개인의 이용 패턴에 따른 주관적 경험이며, 이를 뒷받침할 객관적인 데이터는 제시되지 않았습니다. 특히 Kimi 2.6 API 호출 비용이 1,000만 토큰당 40달러라는 계산 역시 공식 단가표와의 대조를 통한 확인이 필요합니다.

결과적으로 20달러 요금제가 필요하다는 결론은 개인의 헤비 유저 성향이 반영된 제안일 뿐, 서비스의 보편적인 결함이나 부족함을 증명하는 근거로는 약합니다. 라우팅 체계에서 최상위 추론 모델이 필요하다는 논리 또한 개인의 작업 환경에 국한된 판단이므로 일반화하기 어렵습니다. 따라서 해당 서비스의 효율성에 대한 평가는 개별 사용자의 토큰 소모량에 따라 극명하게 갈릴 수 있음을 유의해야 합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

OpenAI Docs

Models

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

디자인 참고 사이트

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    디자인 참고 사이트

    https://t.co/lhNWymiQZ4 https://t.co/IlsttAqIr4

    두 곳 살펴보고 마음에 드는 디자인 프롬 선택한다음

    “프롬프트 디자인 활용해서 해당 워크스페이스의 코드에 맞는 디자인을 설계해 주세요.”

    라고 하면 그럴싸한 결과물이 나옵니다. GPT 한테 디자인 프롬프트 인젝션 공격!!

    원문 보기
  2. 2

    최근 재미있었던 경험은 특별히 말하지 않았는데도 Qwen 3.6 plus 27b가 저 사이트의 탬플릿을 학습하고 있었던 것.

    전 디자인을 잘 모르니, 꽤나 유명한 디자인들을 프롬프트로 재편집해 둔 것이겠죠. 인공지능은 그걸 다시 학습한것일테고.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 특정 디자인 참고 사이트의 프롬프트를 활용해 LLM으로부터 정교한 디자인 결과물을 도출하는 방법과, Qwen 3.6 plus 27b 모델이 해당 템플릿을 이미 학습했을 가능성을 언급하셨습니다. 디자인 프롬프트를 통해 결과물을 유도하는 방식은 사용자 경험에 기반한 유효한 전략으로 보이나, 이를 '인젝션 공격'이라 표현한 점은 기술적 정의보다는 비유적 표현에 가깝습니다. 특히 특정 모델이 해당 사이트의 데이터를 학습했다는 주장은 공식 문서로 증명되지 않은 개인적 추론이므로 추가적인 확인이 필요합니다.

이 기록은 로컬 LLM의 실제 운용 과정에서 나타나는 모델별 학습 데이터의 편차와 재현 가능성을 시사하는 흥미로운 실험 사례입니다. 다만, 모델의 학습 데이터셋 구성은 대개 비공개 영역이기에, 특정 템플릿의 학습 여부를 단정 짓기에는 근거가 부족합니다. 결국 이는 기술적 사실의 증명보다는, 프롬프트 엔지니어링을 통해 모델의 잠재적 능력을 끌어낸 개별 사용자의 시행착오와 발견의 기록으로 보는 것이 타당합니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2049527634590339506

2026-04-29

에이전트가 윈도우에 설치된 윈도우 네이티브 llama.cpp를 총알같이 (전역설정 안한 프로젝트용이었는데) 찾아내서 쓰고 있길래 어떻게 찾았냐 했더니

https://t.co/9qCFXxaB8d

몇일전에 만들어서 설치한 MCP로 뿅 하고 찾아다가 쓰고 있었음. 음 예상보다 성능 좋네.

원문 보기

에이전트가 동에 번쩍 서에 번쩍 로켓부스터 단 홍길동마냥 뛰다니면서 필요한 파일들 찾아서 일하는건 좋은데 이전에 Grep 만 쓸때는 테엥 못찾았어요 주인니뮤 징징 하던게 때론 안심감을 주었는데 이젠 탐색/전환속도가 너무 빠르니 워크스페이스에서 좀 벗어나는데 대한 불안감이 있다.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 MCP(Model Context Protocol)를 통해 에이전트가 윈도우 네이티브 llama.cpp를 빠르게 찾아내 활용했다는 경험을 공유하셨습니다. llama.cpp의 존재와 MCP의 기술적 메커니즘은 공식 저장소와 문서를 통해 확인 가능한 사실이나, 실제 해당 에이전트가 어떤 경로와 속도로 파일을 탐색했는지에 대한 구체적인 로그나 객관적 지표는 제시되지 않았습니다. 따라서 '총알같이 찾아냈다'는 표현은 개인의 체감 성능에 기반한 주관적 판단이며, 기술적 실체는 추가적인 확인이 필요합니다.

더불어 에이전트의 빠른 탐색 속도가 워크스페이스 이탈에 대한 불안감을 준다는 심리적 분석 또한 개인의 감상 영역에 해당합니다. 이는 NIST의 AI 위험 관리 프레임워크(RMF) 관점에서 볼 때 제어 가능성과 가시성에 대한 우려로 해석될 수 있으나, 구체적인 보안 사고나 오류 사례가 동반되지 않은 막연한 추측에 가깝습니다. 결과적으로 이 글은 MCP의 효율성에 대한 개인적 만족감과 그로 인해 파생된 막연한 불안감이 혼재된 기록이라고 판단됩니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소
Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서