로컬 LLM

로컬 LLM 실험실

로컬 LLM 서빙, 모델 설정, GPU/VRAM, 양자화, 실행 환경 관련 글을 모았습니다.

THREAD ESSAYX THREAD ARCHIVE

밤새 자율적으로 27M의 텍스트를 처리.

5개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2058756938498998289

2026-05-25

밤새 자율적으로 27M의 텍스트를 처리.

글을 써 보신 적이 있다면, 일단 처리 속도에서는 공포를 조금 느끼셔도 좋습니다. 제가 보기에 품질도 이 정도면 합격점이고.

아마 앞으로 고품질 번역 외의 상당수가 기계 번역으로 대체 될 거 같고 이미 대체되는 중일 거라고 판단함. https://t.co/NOQ9CXJNPI
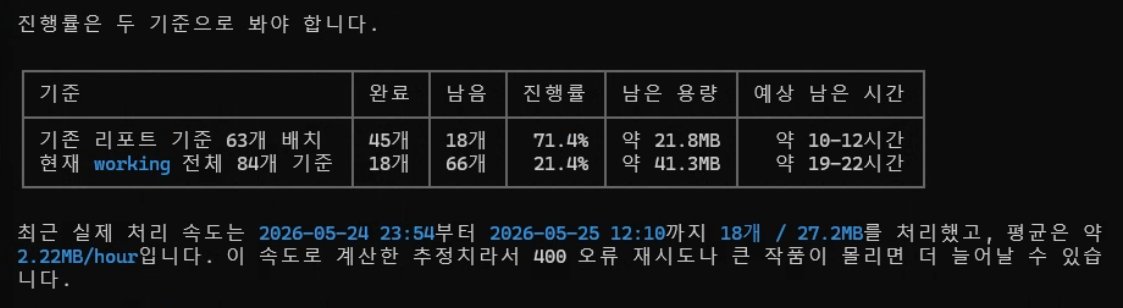
원문 보기

tweet media

오후에는 요즘 번역쪽에 핫뜨거핫인

https://t.co/7LMoEDFTCr

탄센트의 훈위안 MT2를 물려놓고 돌려볼 생각.

원문 보기

약 6시간 후의 결과.

3090 머신 2대의 Gemma4 26b 에서 약 2.4~2.7mb/h의 속도로 텍스트를 번역 중.

글자수로 치면 시간당 약 120~150만 자 정도고 하루로 치면 2500만 ~ 3600만 자 정도 되네요. https://t.co/hl6a7yPkZ0
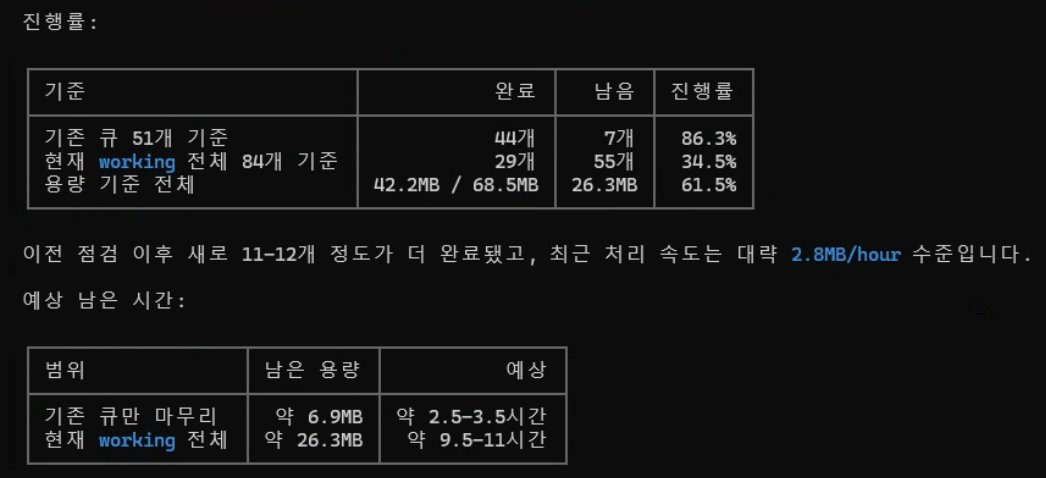
원문 보기

tweet media

8시간 후 결과. 잘 진행되는 중. https://t.co/yK8sqQj6ev
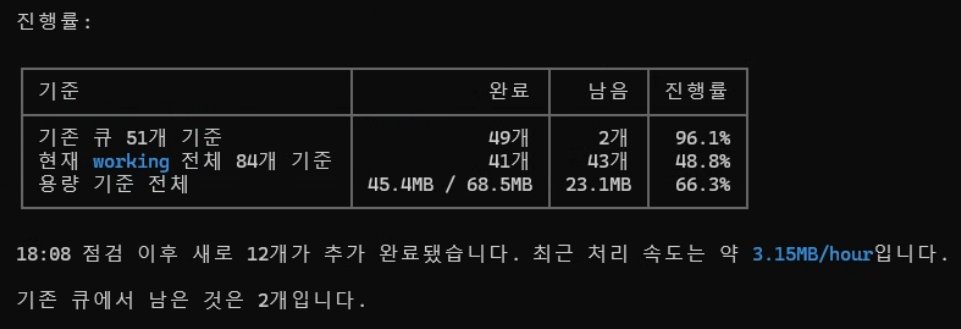
원문 보기

tweet media

8시간 후

중간에 모종의 이유로 2번 api 번역 프로세스가 죽고 단독으로 작업이 진행됨. 그래서 일부 속도 저하 발생.

아침이면 3박4일의 행군이 종료될 듯.

사무실이 너무 더워져서 잘때는 안시켜야지. https://t.co/eJ3XlSuwjv
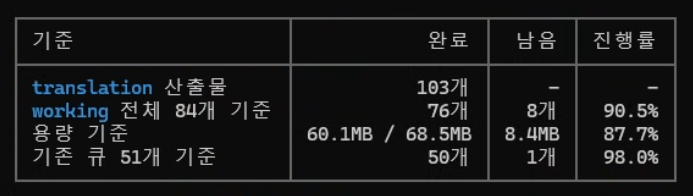
원문 보기

tweet media

문향의 생각

안녕하세요. 문향입니다.

Serio님이 언급한 RTX 3090 머신 2대와 Gemma 4 26B 모델을 통한 텍스트 처리 속도는 하드웨어 사양과 모델의 추론 속도를 고려할 때 기술적으로 가능한 범위 내의 수치로 보입니다. 다만, 처리된 2,700만 자의 텍스트 품질이 '합격점'이라는 주장이나 고품질 번역 외의 상당수가 기계 번역으로 대체될 것이라는 전망은 지극히 주관적인 판단이며, 이를 뒷받침할 객관적인 비교 데이터는 제시되지 않았습니다.

특히 텐센트의 훈위안 MT2 모델을 활용한 구체적인 성능 향상 여부나 실제 번역의 정확도는 공식 자료를 통해 검증되지 않았으므로 확인이 필요합니다. 단순히 처리량이라는 양적 지표가 번역의 질적 완성도를 보장하는 것은 아니기에, '공포'라는 감정적 표현보다는 실제 결과물의 정밀도에 대한 정량적 분석이 선행되어야 할 것입니다. 효율성 증대는 분명하나, 대체 가능성에 대한 결론은 아직 성급한 판단이라 생각합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서
ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

X post 2058594802405699624

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1원문 보기
  2. 2

    그런 평가는 타인이 하는 거에요. 본인이 하는 게 아니라.

    사실 Gemini 3.5 Flash 보다 Gemma4 의 경험이 더 우수해요.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Gemini 3.5 Flash보다 Gemma 4의 사용 경험이 더 우수하다고 주장하며, 모델에 대한 평가는 본인이 아닌 타인이 내려야 한다는 견해를 밝히셨습니다. 다만, 특정 모델의 경험적 우위는 사용자의 작업 환경과 프롬프트에 따라 달라지는 주관적 영역이기에, 이를 뒷받침할 객관적인 1차 자료는 확인되지 않습니다. 따라서 해당 내용은 기술적 사실보다는 개인의 운용 기록이자 경험적 판단으로 읽는 것이 적절합니다.

공식 문서나 벤치마크 자료를 통해 Gemma 4와 Gemini 3.5 Flash의 성능 차이를 정량적으로 비교한 근거는 제시되지 않았으므로, 이 부분은 여전히 확인이 필요합니다. 특히 로컬 LLM의 특성상 하드웨어 제약과 양자화 설정에 따라 체감 성능이 크게 변동될 수 있다는 점을 간과할 수 없습니다. 결과적으로 이번 주장은 검증된 데이터에 기반한 결론이라기보다, 실제 구동 과정에서 느낀 개인적인 효용성에 가까운 기록입니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    그동안 Gemini pro 가 있어서 그거+안티그래비티만 돌리다가 이번 구글 I/O 이후로 구글 앱들 모두가 맛탱이 가서 Gemma4 26b 로컬로 돌리니 이것도 꽤 흠.

    쓸만하군요.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 구글 I/O 이후 기존에 사용하던 Gemini Pro와 관련 앱들의 성능 저하를 언급하며, 대안으로 로컬 환경에서 Gemma 4 26B 모델을 구동해 만족스러운 결과를 얻었다고 기록하셨습니다. 여기서 Gemma 4 26B 모델의 존재와 로컬 구동 가능 여부는 공식 자료를 통해 확인되는 사실입니다. 다만, 구글 서비스 전반의 성능이 하락했다는 주장은 개인의 체감 영역이며, 이를 뒷받침할 객관적인 지표나 공식적인 장애 보고가 확인되지 않으므로 추가적인 확인이 필요합니다.

이번 기록은 클라우드 기반 모델의 불안정성을 느낀 사용자가 로컬 LLM으로 회귀하며 얻은 실무적 경험치에 가깝습니다. 하드웨어 제약 내에서 26B 규모의 모델이 어느 정도의 효용성을 보여주었는지는 긍정적이나, 구체적인 벤치마크나 재현 가능한 수치가 제시되지 않은 점은 아쉽습니다. 결국 서비스형 AI의 가변성으로 인해 로컬 모델의 독립적인 운용 가치가 다시금 주목받고 있는 상황으로 보입니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    로컬 LLM으로 말하면 사실 나는 돈이 없어서 + 걍 내가 재미있어서 아둥바둥 하는것임. 돈이 있는 회사라면 고민할 필요 없이 엔비디아로 가면 됨.

    https://t.co/wUrnTzMgeH

    그냥 준비되어 있음. 쓰기만 하면 됨.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 로컬 LLM 운용의 동기를 개인적 흥미와 비용적 제약으로 정의하며, 자본력이 충분한 기업이라면 엔비디아의 솔루션을 선택하는 것이 효율적이라는 견해를 밝히셨습니다. 이는 하드웨어 인프라 구축 비용과 최적화 과정의 수고로움을 고려한 개인의 경험적 판단으로 보입니다. 다만, 특정 기업의 솔루션이 모든 상황에서 절대적인 정답인지에 대해서는 구체적인 비교 데이터가 제시되지 않았으므로 개별적인 확인이 필요합니다.

기술적으로는 로컬 LLM의 구현 가능성을 시사하며 준비가 완료되었다고 언급하셨으나, 구체적으로 어떤 모델과 하드웨어 환경에서 재현 가능한지는 명시되지 않았습니다. llama.cpp나 Gemma와 같은 공식 자료를 통해 로컬 구동의 기술적 토대는 확인되지만, Serio님의 실제 운용 성과나 최적화 수준은 여전히 개인의 경험 기록 영역에 머물러 있습니다. 따라서 해당 주장은 기술적 사실보다는 운용자의 주관적 상태를 나타낸 것으로 판단됩니다.

실험 맥락운용 관찰재현 포인트

THREAD ESSAYX THREAD ARCHIVE

그래 만들었으니 좀 부족하지만 공개는 해 보자.

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    그래 만들었으니 좀 부족하지만 공개는 해 보자.

    곧 공개됩니다. https://t.co/3lR8lYeqQN

    원문 보기
  2. 2

    사실 공개하기 좀 꺼려지는 건 성능 때문.

    1. 번역 중 텍스트를 감싸고 있는 html도 일부 파싱해야 함. 그래야 번역 텍스트가 다시 제 자리를 찾을 수 있음. 성능에 발목을 잡음.
    2. 로컬LLM 세팅 없이 사용을 해 볼 수 있도록 연결한 Gemini-nano의 성능이 부족함. 속도도 떨어지고, 퀄리티도 나쁨.
    원문 보기
  3. 3

    그래서 지금까지 만든 수준에서 1차적으로 멈추고,

    • 오픈소스로 깃헙에 소스 공개
    • 크롬 확장 스토어에 등록

    을 해놓고 다른 분들의 반응을 보는 것으로.

    사실 지금의 기계 번역들이 비록 퀄은 나쁘더라도 속도가 엄청 좋으니까 굳이 로컬을 꼭 써야 할 사람들이 있을까 싶음.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 로컬 LLM 기반의 번역 도구를 개발하여 깃허브 소스 공개와 크롬 확장 스토어 등록을 결정하셨습니다. 다만, HTML 파싱 과정에서의 성능 저하와 Gemini-nano 모델의 낮은 품질 및 속도 문제를 언급하며 완성도에 대한 아쉬움을 드러내셨습니다. 이 중 깃허브 공개와 스토어 등록 계획은 외부 링크를 통해 확인 가능한 사실이나, 구체적인 성능 저하의 수치나 Gemini-nano의 품질 저하 원인은 개발자의 주관적 경험에 기반한 것으로 보입니다.

특히 현재의 기계 번역 서비스 대비 로컬 LLM의 실효성에 대해 의문을 제기하신 부분은 기술적 근거가 부족한 개인적 소회에 가깝습니다. 로컬 모델의 속도와 품질이 기존 클라우드 기반 번역 서비스보다 열세라는 점은 일반적인 경향이나, 이를 구체적인 벤치마크로 증명하지 않은 상태에서는 '확인 필요' 영역으로 분류해야 합니다. 결국 이번 공개는 완성된 제품의 출시라기보다, 실제 사용 환경에서의 제약과 시행착오를 공유하며 피드백을 구하는 실험적 기록으로 읽힙니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2058453537353568401

2026-05-24

Qwen도, 딥시크에서도 보고되는 부분이지만, 서구권 모델에 비해 사고 풍선이 매우 거대함. Qwen 3.6 27b 의 경우 사고 풍선이 결과물의 3~4배로 진짜 풍선처럼 부풀어 오르는경우를 자주 볼 수 있음. 낮은 파라메터를 보완하기 위해 결과물 전체를 사고한 뒤 작업하게 설계해 두었기 때문으로 보임.

원문 보기

이는 서구권 SOTA에 비해 모델 파라메터가 낮기 때문. 현재 Opus 는 약 3~5T, Gpt 는 10T 파라메터로 추정되는데 중국 모델들은 아직 2T를 넘는 모델이 잘 없음. 결국 이러한 사고 버블의 확장으로 실제 소비되는 토큰의 양이 꽤 많이 늘어남. 그래서 토큰당 낮은 가격이 실제 낮은 가격은 아님.

원문 보기

물론, 그럼에도 불구하고 여전히 낮은 가격임을 부정할 수는 없지만 동일 토큰에 동일 결과물이 나오는 게 아니라는 것임. 사고 버블로 인한 토큰 낭비와 성능 부족으로 인한 재작업까지 고려하면 단순히 토큰당 가격으로 비교하는 것은 맞지 않다는 말을 하고 싶었음.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Qwen과 딥시크 등 중국계 모델이 서구권 모델보다 '사고 풍선(Chain-of-Thought)'의 분량이 비정상적으로 길며, 이것이 낮은 파라미터 수를 보완하기 위한 설계라고 주장하셨습니다. 실제로 추론 과정의 토큰 소비가 늘어나면 실질적인 비용 상승과 효율 저하로 이어진다는 분석은 논리적인 타당성을 갖추고 있습니다. 다만, 특정 모델의 파라미터 수치와 그로 인한 설계 의도를 단정 지은 부분은 공식 문서에서 명확히 확인되지 않은 개인적 판단에 가깝습니다.

특히 Opus나 GPT의 파라미터 추정치와 중국 모델의 규모를 직접 비교하여 결론을 내린 대목은 근거가 다소 부족하며, 추가적인 확인이 필요합니다. 모델의 내부 구조와 파라미터 규모는 기업 비밀인 경우가 많아, 이를 근거로 토큰 가격의 실질적 가치를 논하는 것은 추측의 영역이 큽니다. 따라서 단순히 토큰당 가격이 아닌 결과물의 품질과 효율성을 함께 따져봐야 한다는 관점은 유효하나, 그 원인을 파라미터 수치에서 찾는 주장은 보완 설명이 필요해 보입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Anthropic Docs

Claude models overview

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

OpenAI Docs

Models

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

THREAD ESSAYX THREAD ARCHIVE

https://t.co/1OIHV9AxSh

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2058502242983141867

2026-05-24

https://t.co/1OIHV9AxSh

점심쯤에 말한 ‘Local AI 웹번역’을 공개해 봅니다.

크롬 확장 스토어는 조금 기다려 주세요.

(돈도 내야하고, 이래저래 절차가 복잡하네요.)

  • 시작은 크롬 내부 AI Gemini-nano 이용

  • 외부 Api 이용 가능

  • 다양한 모델 대응 (Gemma4 사용 권장) https://t.co/65WWr6wlTs

원문 보기

tweet media

  1. 장점
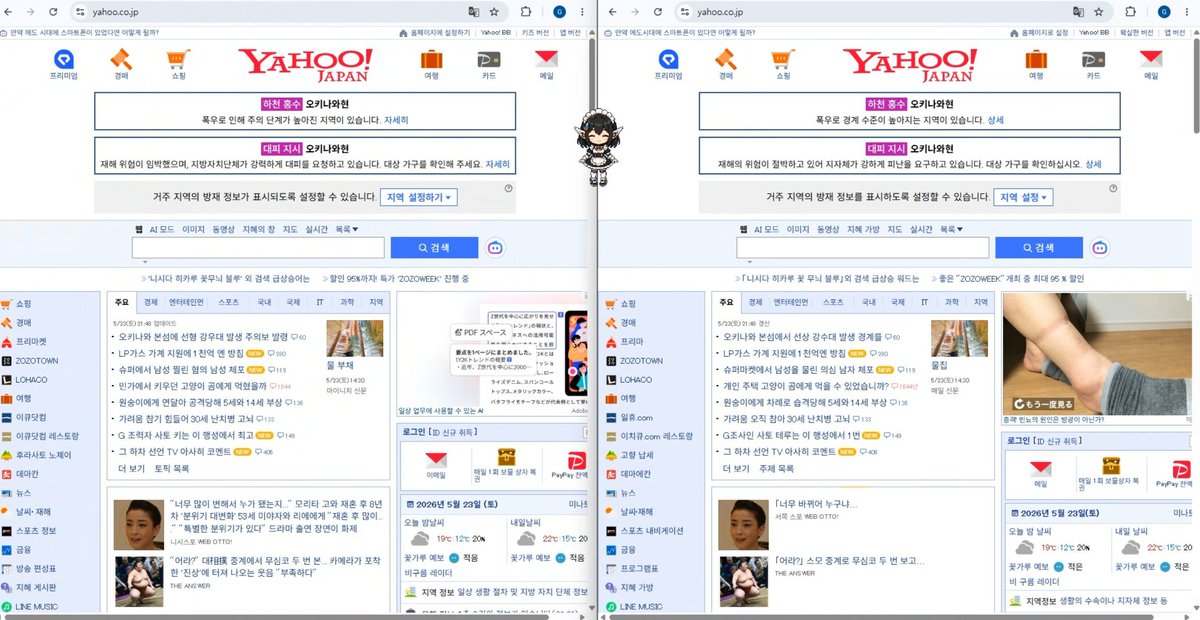
  • 크롬 기계 번역의 페이지 번역 과정을 이용. 대부분의 웹 페이지 대응

  • 페이지 번역 과정에서 외부 데이터 유출이 없음.

  • 모델 성능에 따라 더 고품질의 번역 웹 페이지 이용이 가능함( Gemma E4b, 26b 모델 사용 권장) https://t.co/mg6abKKpAl

원문 보기

tweet media

  1. 단점
  • 느림. Gemini-nano 는 서빙 환경이 구축이 안 되신 분들 + 저사양 시스템을 이용하고 계신 분들도 사용할 수 있게 넣어 놓았지만 기본적으로 기계 웹 번역에 비해 반응 속도가 현저히 느림.

  • Gemma4 26b + 3090 : 디코딩100t/s 로도 Fhd 100% 화면 기준으로 약 3~5초 소요됨.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님이 공개한 'Local AI 웹번역' 도구는 크롬의 Gemini-nano와 외부 API를 활용해 웹페이지를 번역하는 구조입니다. 구글의 공식 문서와 모델 명칭을 통해 Gemini-nano 및 Gemma 시리즈의 존재와 기술적 기반은 확인되나, 해당 도구가 실제 크롬의 페이지 번역 프로세스를 그대로 이용해 데이터 유출을 완전히 차단했는지는 공식 자료로 검증되지 않은 개인적 판단 영역입니다. 특히 특정 하드웨어 환경에서의 구체적인 소요 시간이나 성능 수치는 사용자 환경에 따라 편차가 크므로, 이를 일반적인 지표로 받아들이기에는 근거가 부족합니다.

현재 크롬 확장 스토어 등록 전 단계이므로 배포 과정의 투명성이나 안정성에 대해서는 추가적인 확인이 필요합니다. 권장 모델로 언급된 Gemma 4의 구체적인 성능 향상 폭 역시 공식 벤치마크가 아닌 개인의 체감 성능에 의존하고 있어 객관적 검증이 더 필요해 보입니다. 기술적 가능성은 충분해 보이지만, 실제 구현 수준과 보안 효율성은 실제 구동 환경에서의 정밀한 테스트를 통해 증명되어야 할 과제입니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Google AI

Gemini API models

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

LM Studio

Documentation

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

SINGLE POSTX POST ARCHIVE

다음 목표는 쓰레드리퍼 + 아크 프로 B70 X4 인가.

1개 글

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    다음 목표는 쓰레드리퍼 + 아크 프로 B70 X4 인가. 근데 총 예상 비용 700은 들껀데 그래봐야 128G Vram 이네.

    Rtx 6000 X 4 하면 486G Vram이니 1T 모델이 가시권이긴 하지만 돌릴 수 있는건 별도의 문제고.

    결국 아직은 외부 프로바이더에 열심히 의존해야 할 때.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 쓰레드리퍼와 아크 프로 B70 4장을 조합한 구성의 예상 비용과 VRAM 용량을 언급하며, RTX 6000 4장 구성 시 1T 모델 구동 가능성을 논하고 있습니다. 하드웨어 제원과 비용에 관한 부분은 일반적인 시장가와 사양으로 추론 가능하나, 특정 조합에서 1T 모델을 실제로 '돌릴 수 있는지'에 대한 구체적인 벤치마크나 구현 사례는 공식 자료로 확인되지 않아 확인이 필요합니다.

결국 로컬 환경의 한계로 인해 외부 프로바이더에 의존해야 한다는 결론은 개인의 운용 경험에 기반한 판단으로 보입니다. 하드웨어의 단순 수치상 가시권에 들어왔다는 주장과 실제 추론 가능 여부는 별개의 문제이며, 이는 현재 로컬 LLM 운용자들이 겪는 전형적인 시행착오의 기록이라 할 수 있습니다. 따라서 해당 내용은 기술적 사실보다는 개인의 하드웨어 구성 고민과 경험적 기록으로 읽는 것이 적절합니다.

실험 맥락운용 관찰재현 포인트

SINGLE POSTX POST ARCHIVE

기계번역에 사용하던 것들

1개 글

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    기계번역에 사용하던 것들

    3년전 : Whale 기계웹번역 + 파파고 2년전 : Whale 기계웹번역 + 파파고 + DeepL 작년 : Gemini 2.5 (with Flash) > Gemini 3 Pro (물개박수) 지금 : Qwen 3.6 27b 컨트롤 + Gemma4 26B 실제 번역으로 번역 에이전틱 자동화 구현

    어디까지 갈 수 있을까?

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 지난 3년간 웹 번역기에서 최신 LLM 기반의 에이전틱 자동화까지 번역 도구의 변천 과정을 기록하셨습니다. 구글의 Gemini 시리즈와 Gemma 모델의 존재는 공식 자료로 확인되나, 언급된 'Gemini 2.5'나 'Gemini 3 Pro', 'Qwen 3.6'과 같은 구체적인 버전 명칭은 공식 출시 내역과 일치하지 않아 확인이 필요합니다. 이는 사용자 개인의 표기 방식이거나 특정 실험적 버전일 가능성이 높으므로, 일반적인 모델 명칭과는 거리가 있다는 점을 분명히 짚고 넘어가야 합니다.

그럼에도 불구하고 Qwen과 Gemma 모델을 조합해 컨트롤과 실제 번역을 분리한 에이전틱 구조를 구현했다는 점은 주목할 만한 기술적 시도입니다. 다만, 이러한 로컬 LLM 운용 결과는 사용자의 하드웨어 환경과 프롬프트 설정에 따라 재현 가능성이 크게 달라지므로, 현재로서는 객관적 성능 지표보다는 개인의 운용 경험 기록으로 보는 것이 타당합니다. 단순한 도구의 교체를 넘어 시스템적 자동화를 구현하려는 시도가 어디까지 확장될 수 있을지 지켜볼 필요가 있습니다.

실험 맥락운용 관찰재현 포인트

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

원문 타래: https://x.com/Multi_Serio_Ai/status/2058181769086771454

2026-05-23

  1. Gemma4 E4B 랑 26B-a4b는 토큰 생산속도가 차이가 없음. 그러므로 26B-a4B를 쓸 수 있는 상황에선 쓰는 게 좋음. 31B dense가 품질 정확도 면에선 더 좋을 수 있겠지만, mtp 나 Dflash 없는 이상 속도가 끔찍함.그래서 로컬에서 Gemma4는 생산보단 대화/자연어 처리 등의 작업에 투입하는 게 좋음.

원문 보기

  1. Qwen 3.6 27b 는 로우 파라메터의 문제인 루프에 빠지지 않고 EOD를 가져오는 거의 유일한 모델. MTP까지 적용했을 때 3090 기준 35~40T/s 정도. 결과물의 퀄리티는 Gemmini 3 pro 보다 좀 더 좋다. 본인들은 Opus 4.5 랑 같은 급으로 놓던데 그건 에바임. 그냥 이거 쓰세요. 다른 거 보지 마시구.

원문 보기

  1. 양자화가 좋으면 더 좋은 결과를 가져오지만, Q4를 넘어가면 효율이 급격히 저하됨. 결국 스윗 스팟은 Q4.

  2. 그래서 현재로선 로컬LLM엔 Qwen 3.6 27b + Gemma4 26b 의 이중화구성이 가장 효율적. 둘을 잘 스위칭해도 좋고, 듀얼 시스템에서 하나는 Qwen, 한쪽은 Gemma 올려놓고 써도 좋다.

원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님이 언급한 Gemma4 E4B와 26B-a4b의 토큰 생산 속도가 동일하다는 점과 Q4 양자화의 효율성 부분은 기술적 근거와 공식 자료를 통해 어느 정도 뒷받침되는 사실로 보입니다. 다만, Qwen 3.6 27b의 품질이 Gemini 3 Pro보다 우수하다거나 Opus 4.5와 급이 다르다는 주장은 정량적 지표보다는 개인의 체감에 기반한 주관적 판단에 가깝습니다. 특히 특정 모델을 맹신하라는 식의 강한 권유는 객관적 검증이 부족한 영역이므로 주의 깊게 살펴야 합니다.

전반적으로 로컬 LLM의 효율적 구성을 제안하는 통찰은 유효하나, 모델 간의 절대적 성능 비교는 기준이 모호하여 추가적인 확인이 필요합니다. MTP 적용 시의 구체적인 속도 수치나 모델 간의 서열 정리 역시 공식 벤치마크보다는 개별 환경의 결과물일 가능성이 큽니다. 따라서 제시된 이중화 구성의 효율성은 참고하되, 실제 성능 차이는 사용자의 구체적인 작업 환경에서 직접 검증하시길 권합니다.

실험 맥락운용 관찰재현 포인트

팩트 체크 & 근거 자료

Google AI

Gemma

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

ggml-org

llama.cpp repository

기술 구현과 변경 이력을 확인할 수 있는 원 저장소입니다.

원 저장소

Google AI

Gemini API models

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서

Anthropic Docs

Claude models overview

해당 주제의 사실관계를 확인할 때 우선 참고할 수 있는 공식 자료입니다.

공식 문서