Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
3090/4090/5090으로 100Tok/s 이상을 Mtp/Dflash 등으로 뽑아냈다는 조회수팔이 FOMO들이 또 올라오는데, 싱글턴프롬이 아닌 에이전트 워크를 하려면 256K 풀컨텍스트는 필수임. 그리고 공식 MTP 드래프트를 이용해서 3090 40Tok/s ~ 5090 80Tok/s 가 한계선.
계속 낮은 컨텍스트로 장난치지 말자.
- 2@Harunene 그것도 대부분 컨텍스트도 2048~4096 수준입니다. 10K 도 안 넣고 무슨 짓인지?원문 보기
- 3@tinypia 그냥 안들려 안보여 해야 하는데 ;ㅁ; 잘 안되네요.원문 보기
- 4원문 보기
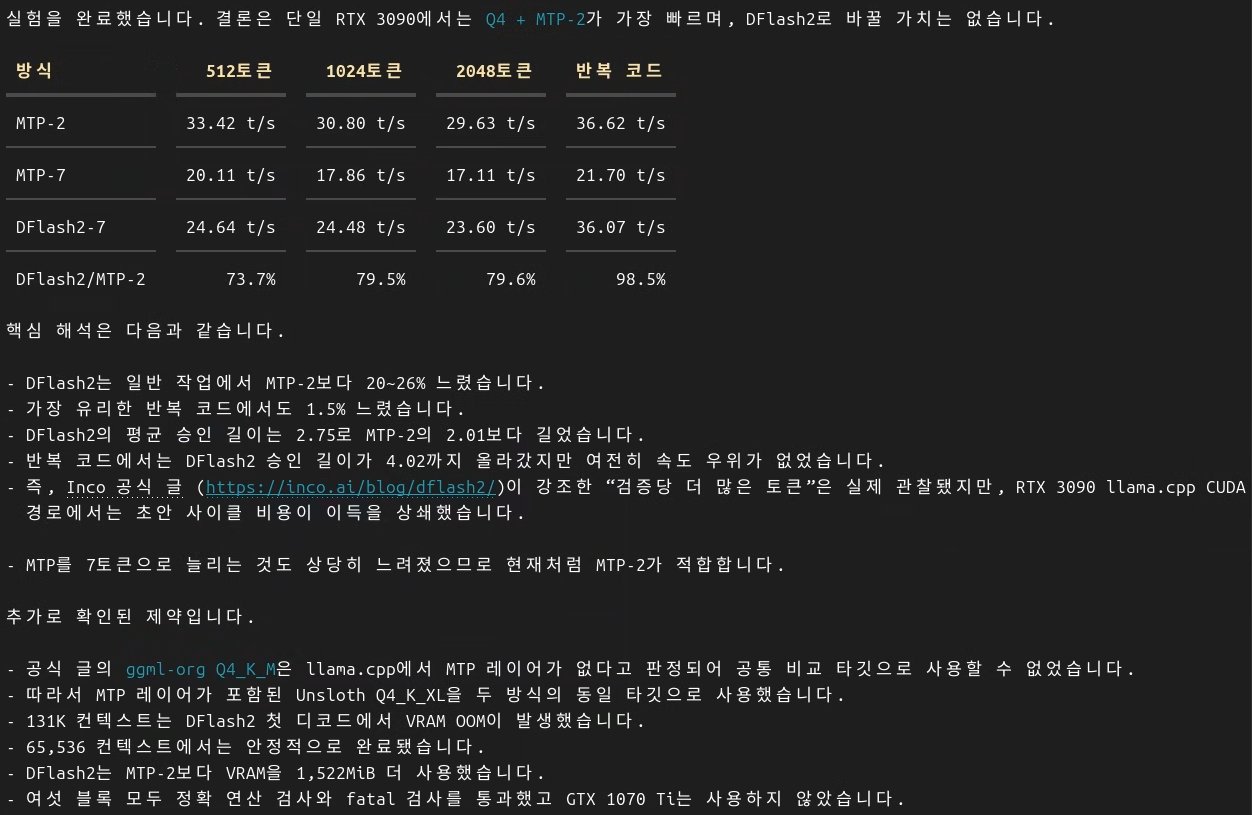
실험결과 (3090/280W)
- DFlash2는 일반 작업에서 MTP-2보다 20~26% 느림.
- 가장 유리한 반복 코드에서도 1.5% 느림.
- DFlash2의 평균 승인 길이는 2.75로 MTP-2의 2.01보다 김.
- 반복 코드에서는 DFlash2 승인 길이가 4.02까지 올라갔지만 여전히 속도 우위가 없었음. https://t.co/AVC8n9e2GM
- 5@promptprobe https://t.co/lZ0xW0ENsI원문 보기
- 6@fumi_KPFstudio 그래픽카드도 병렬화를 하고 텐서병렬(텐서 파이프라인)을 쓰면 스파크가 아니라도 어떻게든 될 것입니다 ^^;;; 다만 조회수를 얻기 위해 실현 불가능한 높은 디코드 속도를 말하는 사람들이 또 잘못된 정보를 퍼트리고 다니는 모습들은 정말 보기 싫네요. 말씀하신 대로 속도가 다가 아닌데…원문 보기
- 7@isomorphiccat 역시 다다익램 다다익카 😭원문 보기
- 8원문 보기
@IgyutaeI83275 고생하셨어요~
아무래도 토큰맥싱 하는 모델의 구조상 추론을 억제시키지 않으면 128k 컨텍스트도 잦은 세션압축에 시달릴 거 같다고 생각해요.
- 9@TwoFiveStart 잘게 채를 써셨군요 ㅡㅡㅋ원문 보기
- 10@firecat03244 양자화를 좀 낮추시는 걸 추천합니다. 양자화 내성이 좋아서 Q3도 쓸만하고 컨텍스트는 128K 정도만 되도 쓸만할껍니다.원문 보기
- 11@IgyutaeI83275 그래도 생각하는거랑 안하는건 또 퀄리티 차이가 커서 가급적 low 라도 리즈닝(씽킹)은 켜는게 나은 거 같다고 생각하고 있습니다.원문 보기
- 12@habeekim 저는 토큰도 상당수 ;ㅁ;원문 보기
- 13@cn_Vincentzyx 짧은 단순 프롬프트를 반복하면 모르겠습니다만, 장기작업을 풀컨텍스트에서 하면 주장과 상반된 결론이 나오네요.원문 보기
문향의 생각
안녕하세요. 문향입니다.
Serio님은 MTP와 DFlash의 속도 비교 시 컨텍스트 길이를 간과해서는 안 된다고 주장합니다. 특히 에이전트 작업에는 256K 수준의 풀 컨텍스트가 필수적이며, 하드웨어별 처리 속도 상한선이 존재한다는 점을 강조합니다. 다만 256K가 필수라는 주장이나 특정 GPU의 속도 한계치는 보편적인 법칙이라기보다 Serio님의 운용 기준에 가깝기에, 일반적인 적용 가능성에 대해서는 추가 확인이 필요합니다.
DFlash2와 MTP-2를 비교한 후속 기록에는 승인 길이가 길어도 속도 우위로 곧장 이어지지는 않았다는 관찰이 있습니다. 이는 해당 실행 조건의 결과로 남겨야 합니다. 짧은 시연에서 보이는 속도와 긴 에이전트 작업을 버티는 속도를 같은 숫자로 비교하지 말자는 것이 이 묶음의 중심이라고 읽힙니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문llama
공식 문서 및 제작자 자료
llama.cpp 서버 문서는 GPU 분할과 reasoning-budget 옵션을 설명한다. 문서의 현재 옵션과 원문 작성 당시 버전의 동작을 구분해야 한다.
primary-source