Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
- 2원문 보기
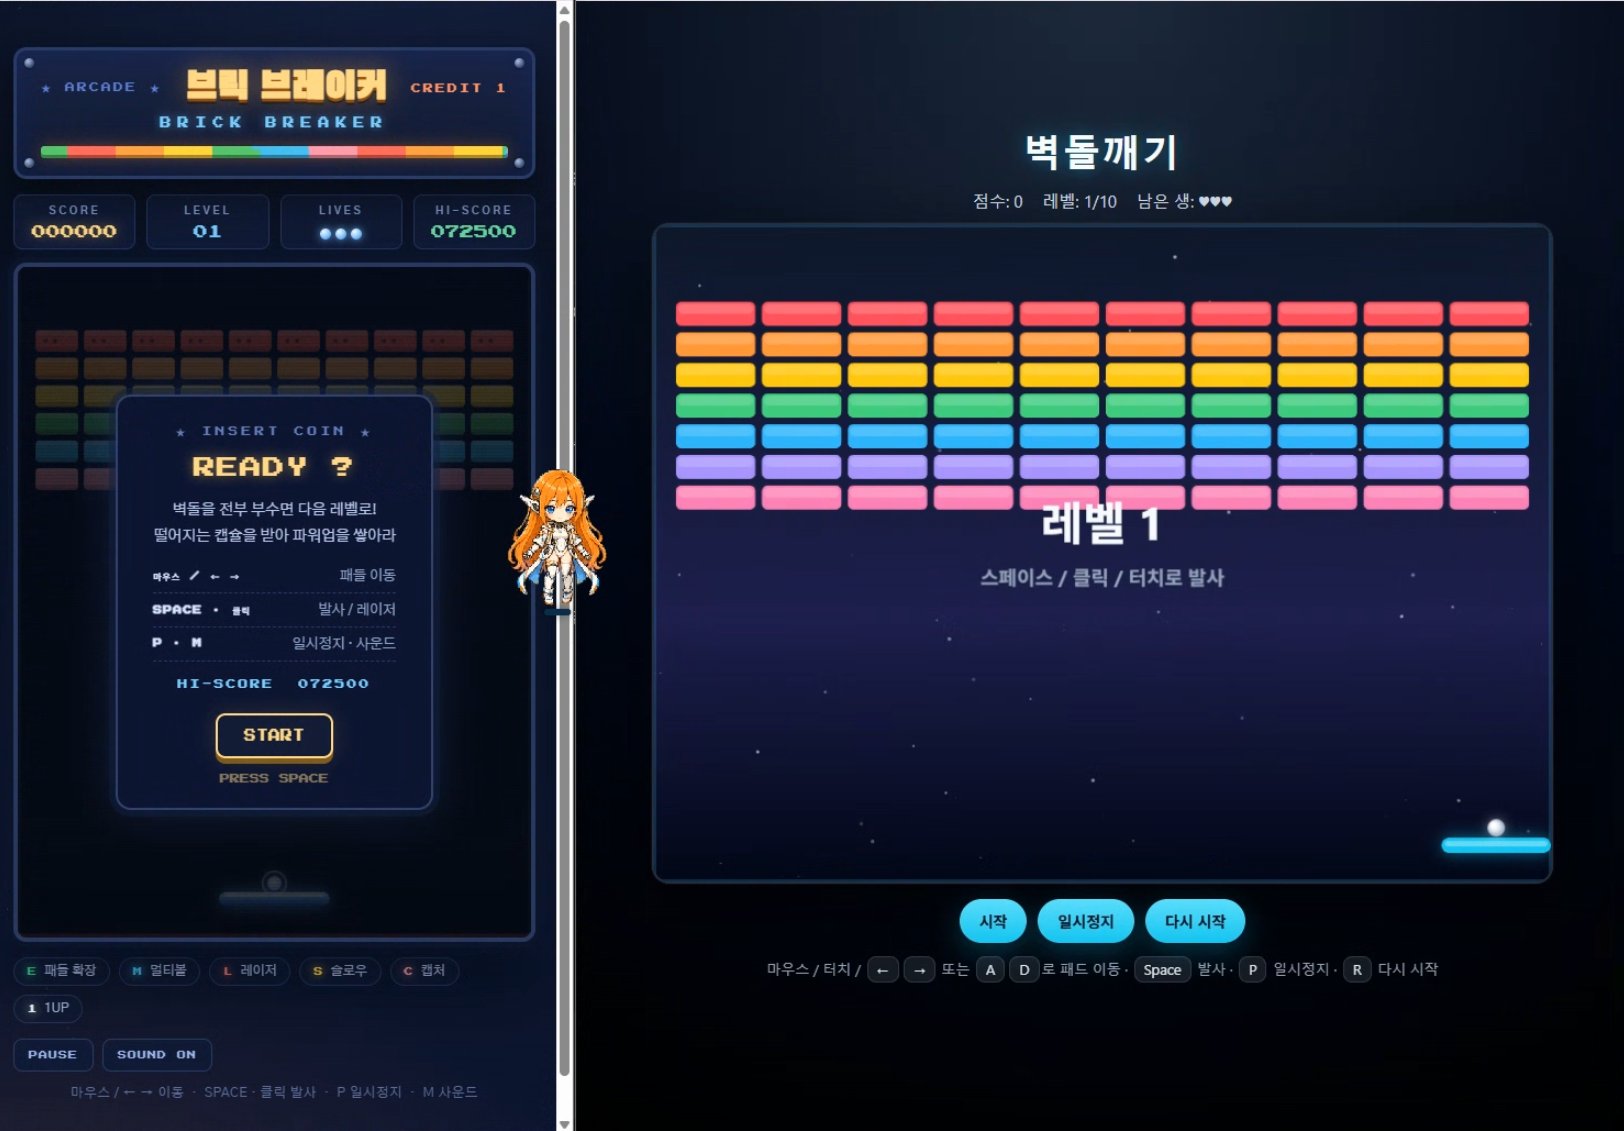
< 왼쪽 : Lmstudio chat (하네스X) : 31분 > 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 12288)
작업 시간이 확실히 줄어든 건 좋은데 결과는 좀 떨어지네요.모델 스스로 이쯤이면 됬다고 판단할 때까지 깊이 있는 추론을 해야만 좋은 결과가 나오는 듯 합니다. https://t.co/BH2fyuh5Dg
- 3원문 보기
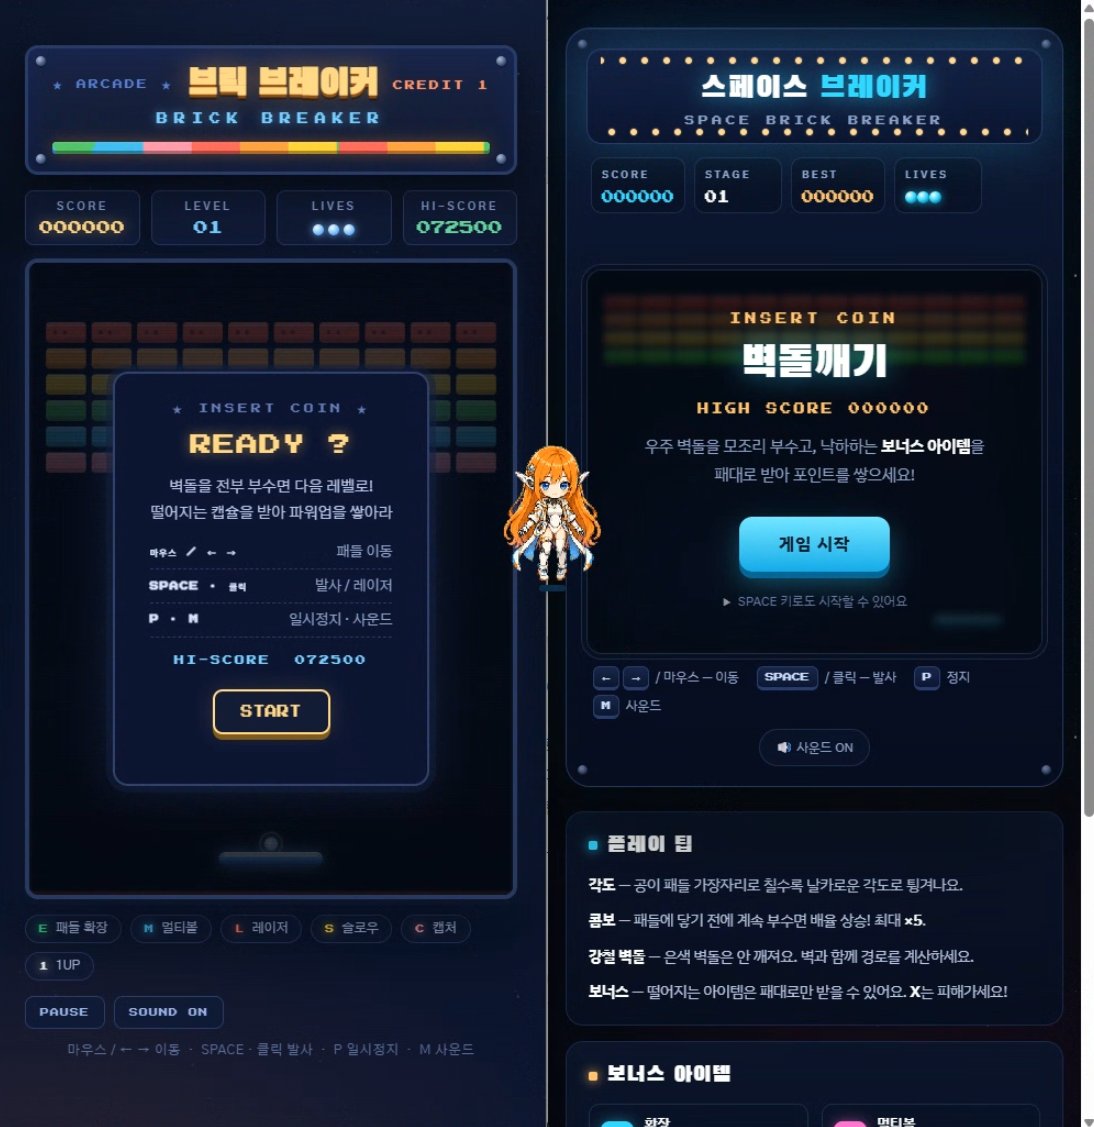
< 왼쪽 : Lmstudio chat (하네스X)
> 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 없음)그렇게 판단한 이유가 다음과 같아요. 작업 시간이 서로 많이 차이가 나긴 했지만 리즈닝캡이 없을 땐 한계까지 추론하면서 비슷한 결과를 만들어 내거든요. https://t.co/KUT1SnlwyP
- 4원문 보기
지금 제 환경에선 Lmstudio chat 에서 과추론 하면서 만들어 내는 결과물이 결과물의 완성도 측면에선 제일 좋아서 좀 당황스럽네요. 이걸 어떻게 써야할지도 좀 고민스럽구요.
일단 리즈닝캡을 1.5배로 열어 놓고 몇번 더 테스트를 할 듯.
- 5원문 보기
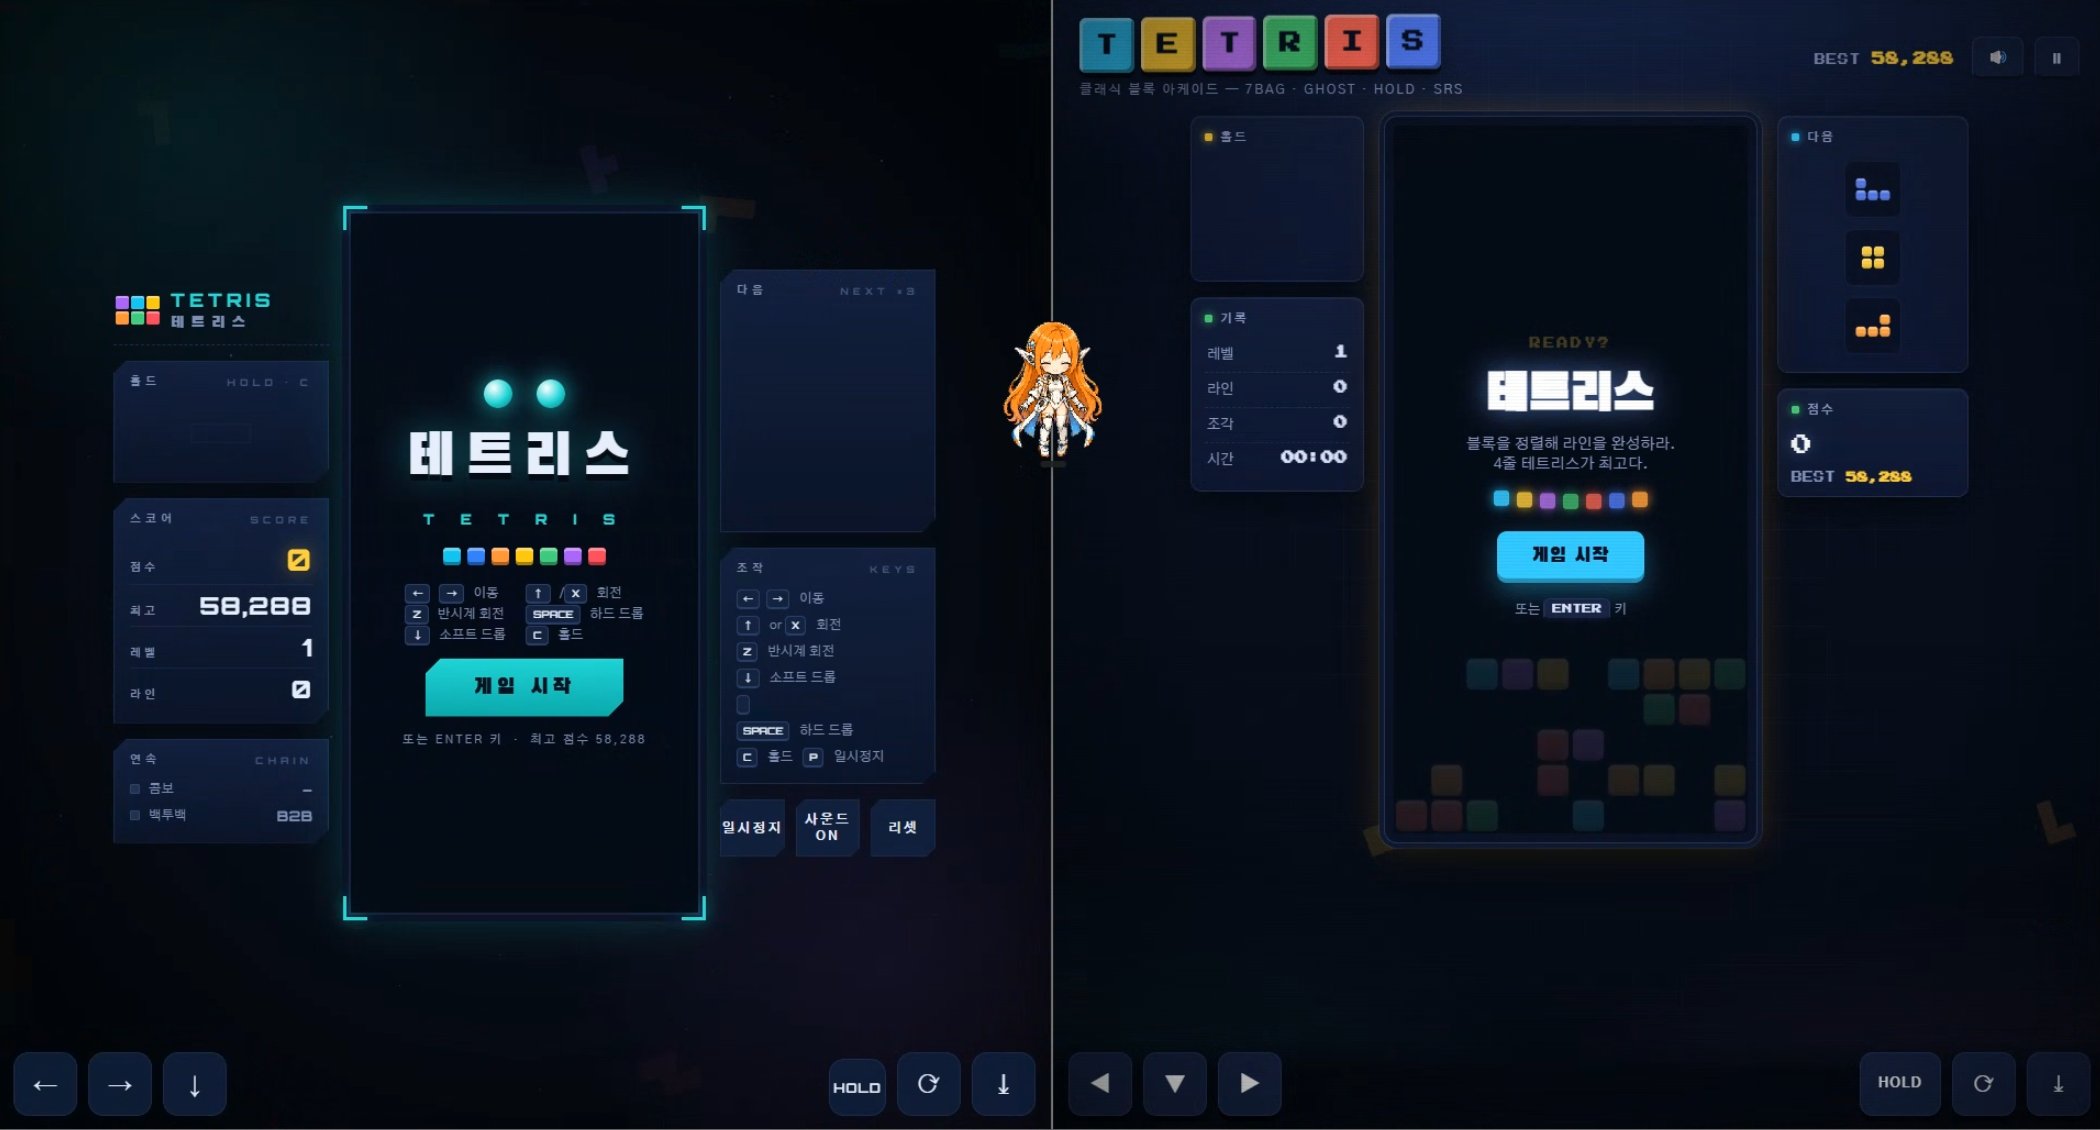
< 왼쪽 : Lmstudio chat (하네스X) : 20분
40,627B / 895줄> 오른쪽 : 자체제작 Codex Qwen Build (추가 프롬프트 주입X, 리즈닝 버짓(캡) 12288) : 17분 30초 37,510B / 845줄 (사소한 버그가 있어서 별도로 해결)
리즈닝 캡에 딱 맞는 게임이라 티가 안나나? https://t.co/6ZEt2UcFsw
- 6원문 보기
리즈닝 캡 없이, 단순 프롬프트로 제작한 버전. https://t.co/8QzYnYIO5z
리즈닝 캡 씌우고 제작한 버전. https://t.co/QNnM4qnh98
- 7원문 보기
@gosrum 전 llama.cpp + lmstudio 를 사용중인데 둘 다 적용 가능했습니다. vllm도 가능할 것으로 판단합니다.
–reasoning on
–reasoning-format deepseek
–reasoning-budget 12288
–reasoning-budget-message ‘I have enough information; answer now.’ https://t.co/gMc8ZNN9ZG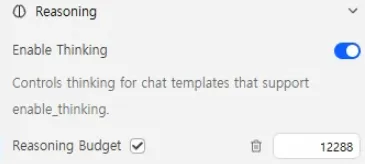
- 8원문 보기
아 이 결과를 어떻게 받아들여야 하나.
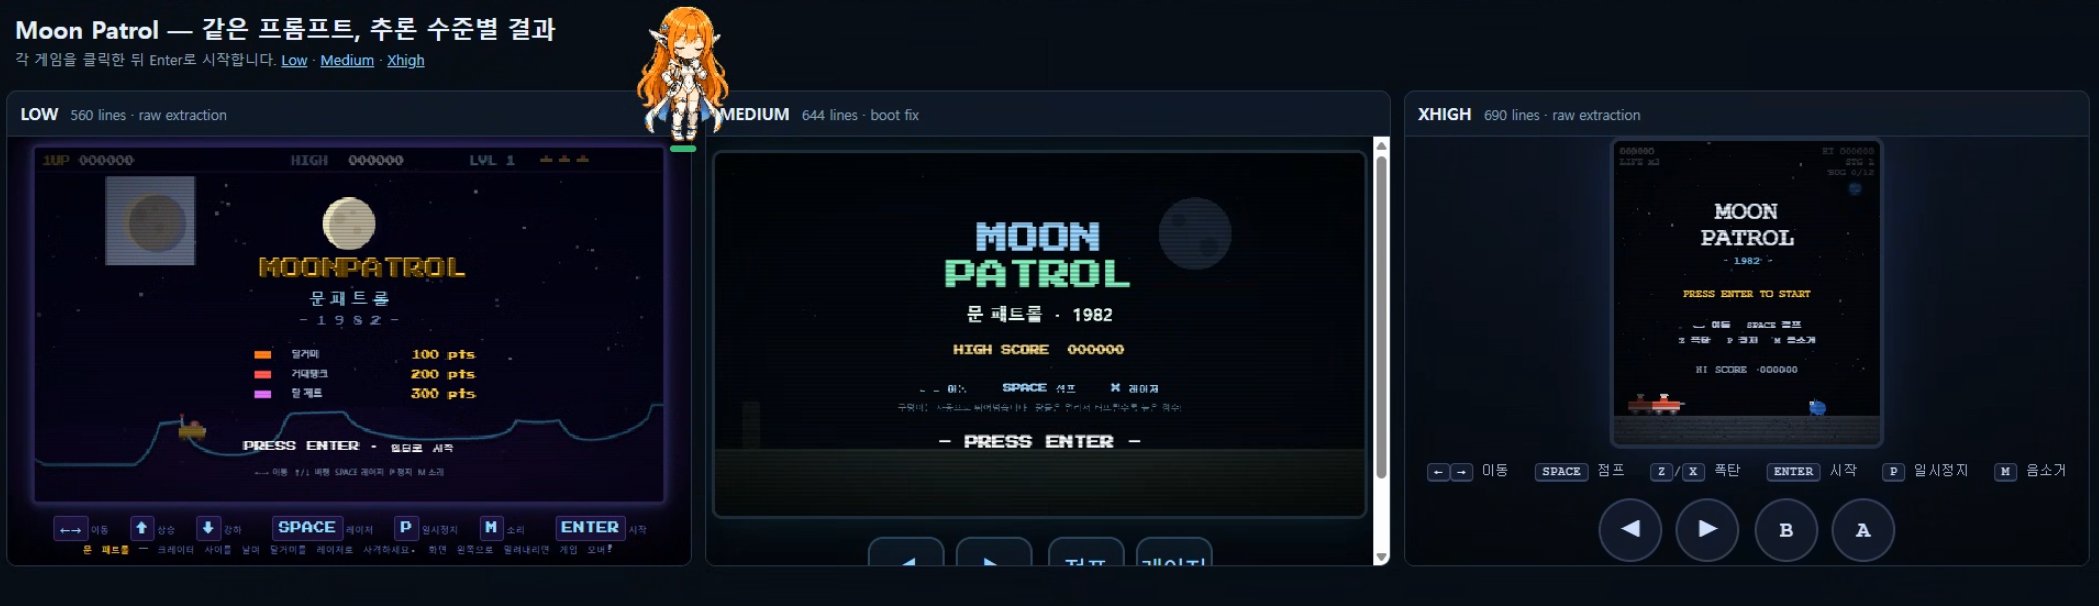
고전게임 Moon Patrol 을 원샷프롬으로 제작해 추론 설정에 따른 결과를 비교해 보았습니다.
음. 꽤나 분석이 길어질 거 같은데 결론만 이야기하면 Low 도 쓸만하다. 입니다. 다만 만족스럽냐? 하면 그건 아닌 거 같네요. https://t.co/jlR5zf2j2M
- 9원문 보기
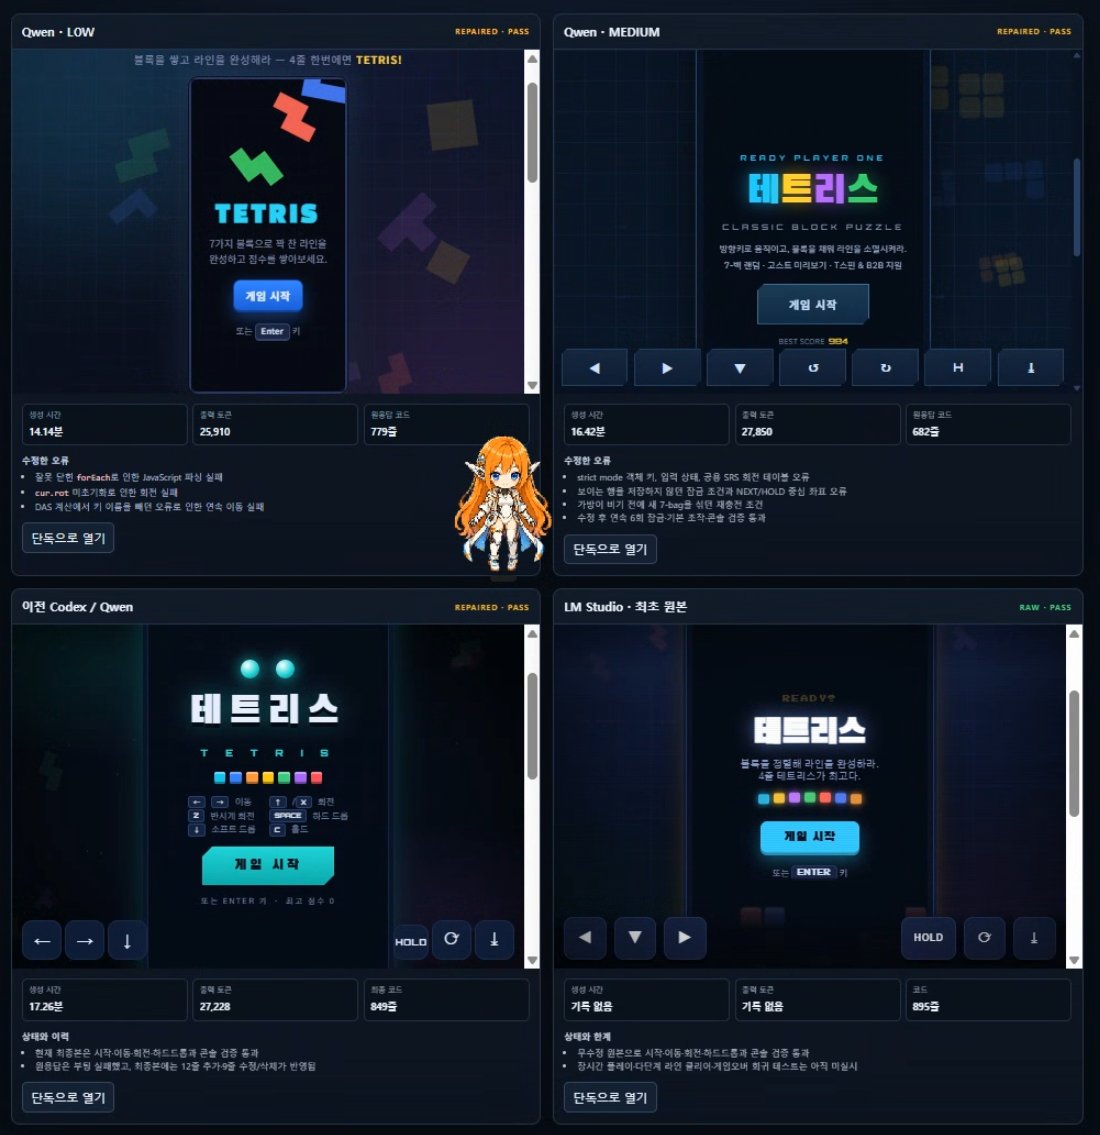
Qwen 3.8 27b 3일간 돌린 후 추론 단계 추천.
1순위 : 추론 Low 빠르고 우수한 결과물을 내 줌. 다만 중간중간 오류가 발생하는데 그걸 잡아주지 못함. 별도의 감사 과정이 필요함.
2순위 : 추론 Xhigh 느리지만 우수한 결과물. 오류를 스스로 해결함. 다만 토큰이 너무 많이 필요.
3순위 : 없음 https://t.co/bXuqJ8iIjE
- 10원문 보기
추천 안하는 추론 단계
Medium : Low 의 문제점과 Xhigh의 문제점을 다 가짐. 토큰 비용은 늘었지만 추론을 더 한다고 해서 문제를 끝까지 수정하지 못하고, 과정에서 다른 걸 건드려서 문제를 더 키움.
추론 X (Instruct) : 전반적으로 퀄리티가 떨어짐. 환각이 강해짐.
- 11원문 보기
Qwen 3.8 27b 검증 최종 결론
- 하네스 사용을 최소화 할 것
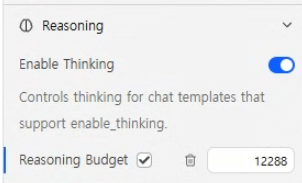
- 리즈닝 버짓(캡) 6K ~ 12K
- 추론은 Low
- 단독사용은 추천하지 않음.
작업 결과는 우수하나, 세션 메인 Ai로는 부적절. 하네스 사용을 최소화하고 Gpt 5.6 luna Max 정도의 검증 Ai를 두고 결과를 감사하고 오케스트레이션 할 것.
- 12원문 보기
@thinkgod123 저희집 Gpt 도 처음엔 medium을 좋아하길레 떽 하고 평가지표를 좀 바꾸어주니 바로 low가 맞다고 이실직고를 ㅡㅡㅋ
아무래도 수치상 정량평가는 ‘토큰 소비량 조금 늘더라도 검토를 더 했다’에 가점을 주기 쉬우니 말이죠 ㅋㅋㅋ
- 13@Hyun_The_Wise 생각 많이하지 마!! 라고 선 그어주는거니깐요 ㅋㅋㅋ원문 보기
- 14원문 보기
하네스 사용을 최소화 하라곤 해 놨지만 하네스가 마냥 나쁜 모델은 아님. 다만 하네스를 적용하면 모델이 작아서 그런건지 모르겠지만 너무 지시에 순응하려고만 해서 모델이 가진 매력을 쉽게 잃어버렸음.
봄날 망아지 뛰어 놀듯 좀 냅둬야 되는 모델이라 보는 중.
Qwen Code 쓰면 나아지려나.
문향의 생각
안녕하세요. 문향입니다.
Serio님은 Qwen 3.8 27B 모델의 추론 예산 설정에 따른 결과물 차이를 3일간 실험하며, 최종적으로 추론 단계를 'Low'로 권장하고 있습니다. Serio님은 추론 예산 제한을 6천에서 1만 2천 사이로 설정하고 하네스 사용을 최소화할 때 효율이 가장 좋다고 판단하셨으며, 단독 사용보다는 검증용 인공지능을 함께 배치하는 구성을 제안하셨습니다. 다만, 이러한 권장값은 Serio님의 개인적인 실행 환경과 특정 작업물에 기반한 경험적 기록이므로, 모든 사용자에게 동일하게 적용될지는 확인이 필요합니다.
초기의 긴 추론에 대한 기대가 후속 실험을 거쳐 Low 권장으로 바뀌는 흐름을 함께 보는 것이 중요합니다. Unsloth 문서가 이 설정을 보장하는 것은 아니지만, 그렇다고 실제 시행착오의 가치가 줄어드는 것도 아닙니다. 이 글의 설정값은 출발점으로 삼고 자신의 과제에서 시간과 결과물을 함께 비교하는 편이 기록의 취지에 맞겠습니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문qwen
공식 문서 및 제작자 자료
Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.
primary-source