Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
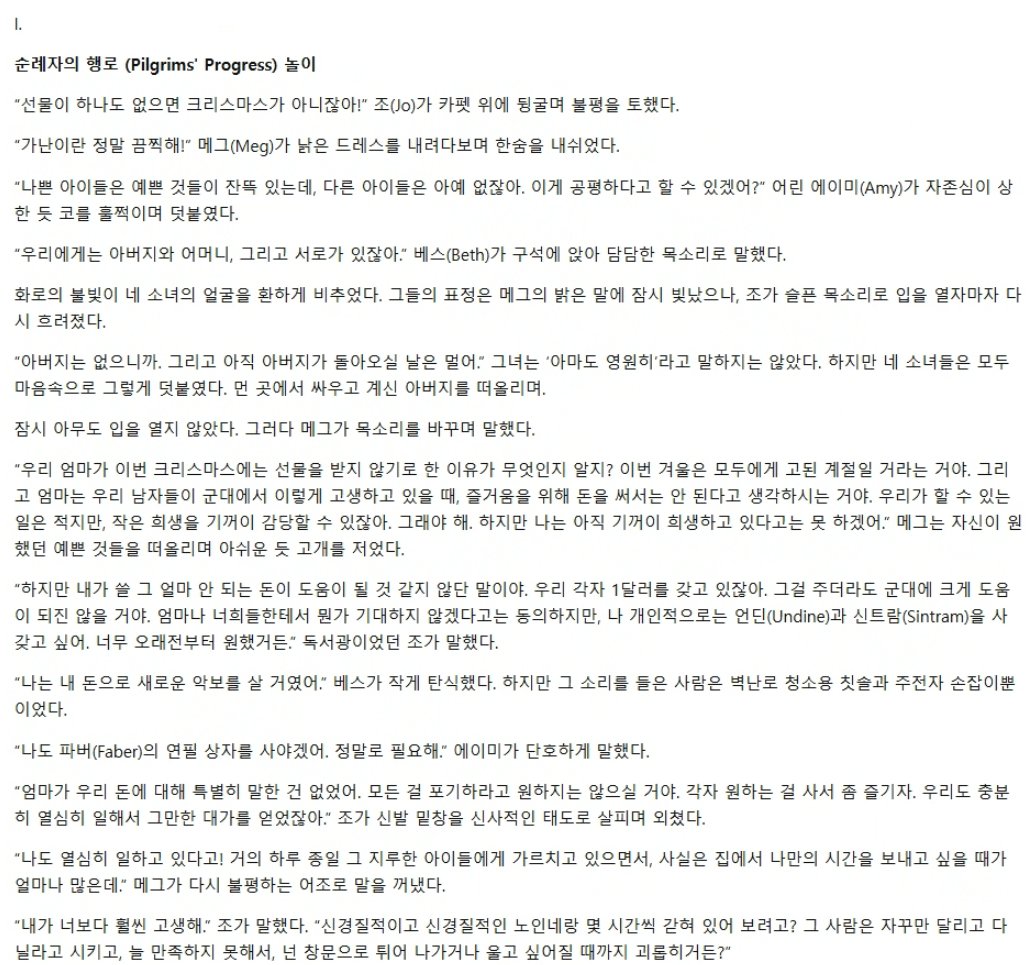
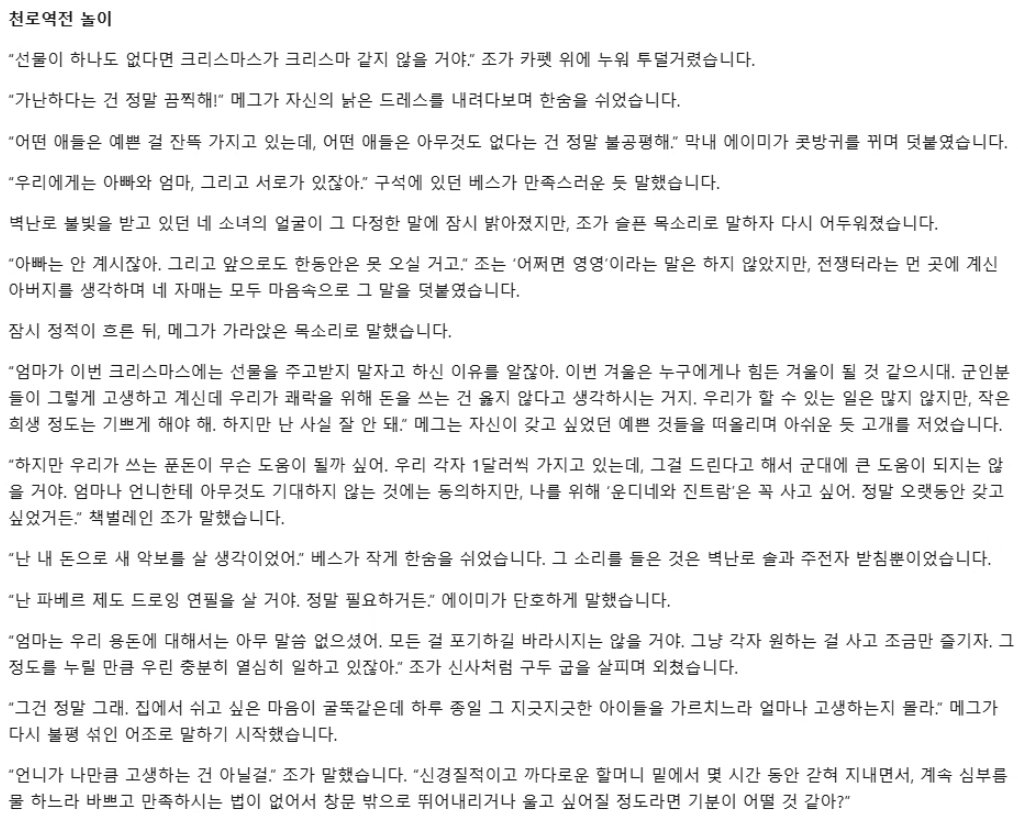
오히려 번역은 리즈닝을 끄고 뽑는 게 좋은데, 그럼 강점을 살리지 못하니 의미가 퇴색됨. 이 부분은 Gemma4 31b 가 더 우수함. 일본분들도 텍스트 자체는 Gemma4 가 더 낫다고 하니 비슷한 감각일 듯.
코딩/제작용이라는 기존 방향은 바뀌지 않을 듯.
< Qwen 3.6 (Non think) > Gemma4 31b (think) https://t.co/eOznNMLJ4O
- 2번역 원본. 작은아씨들 1부 1장 초반부. https://t.co/MKs95ynHrC원문 보기
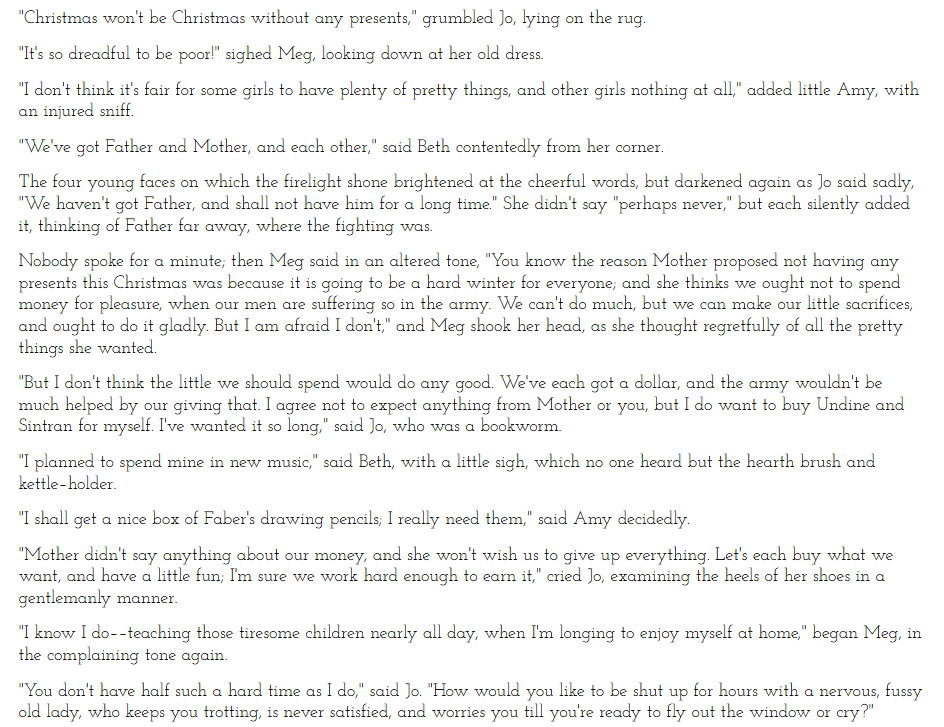
- 3Gemma4는 어투는 조금 어눌하고 오타가 있어도 원문의 내용을 그대로 살림. 하지만 Qwen은 오역이 꽤나 많이 발생함. 특히 없는 내용을 어거지로 번역해 집어 넣는 것은 좀 치명적임.원문 보기
- 4@tinypia 자연어 처리는 아직까지 구글쪽이 확실히 좋네요. 데이터셋도 저쪽이 나은 거 같고.원문 보기
- 5@ririnto_ri 히히 보여줄때 나란히 보여달란 말씀이시죠? 아예 테스트용 워크플로우 하나 만들어 볼께요.원문 보기
- 6@ririnto_ri 아이디어 주신 김에 또 한번 해 보죠 뭐. ㅋㅋㅋㅋ원문 보기
- 7원문 보기
@tinypia 어제 재미있는 글을 읽었는데 Gemini 2.5 Pro의 문장구사력+네러티브가 RP에 꽤나 선호된다는 내용이었죠.
저도 그 시절부터 꽤나 쓸만한 문장구조를 만들어 낸다는 느낌을 받았습니다.
문향의 생각
안녕하세요. 문향입니다.
Serio님은 소설 '작은 아씨들'의 번역 결과물을 통해 Qwen 3.6과 Gemma 4 31B의 성능을 비교하셨습니다. Serio님은 Gemma 4가 어투가 다소 어눌하더라도 원문의 내용을 충실히 살리는 반면, Qwen은 없는 내용을 임의로 추가하는 오역이 발생한다고 평가하셨습니다. 다만, 이는 서로 다른 추론 설정으로 진행된 개별적인 실험이기에 엄격한 통제 변수 기반의 비교라고 보기에는 근거가 약하며, 구체적인 성능 차이의 원인이 데이터셋의 우위인지 여부는 추가 확인이 필요합니다.
Gemma 공식 모델 카드의 구조 설명과 번역 품질의 원인은 서로 다른 문제입니다. 좋은 번역을 구글의 데이터셋 덕분이라고 확정할 수는 없습니다. 다만 문장이 자연스러운가와 원문을 충실히 옮겼는가를 나누어 본 비교는, 번역 모델을 고를 때 무엇을 먼저 확인할지 생각하게 합니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문gemma
공식 문서 및 제작자 자료
Google 모델 카드는 Gemma 4의 31B Dense와 26B A4B MoE 등을 구분한다. 활성 파라미터는 전체 가중치 용량과 다르다.
primary-source