Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
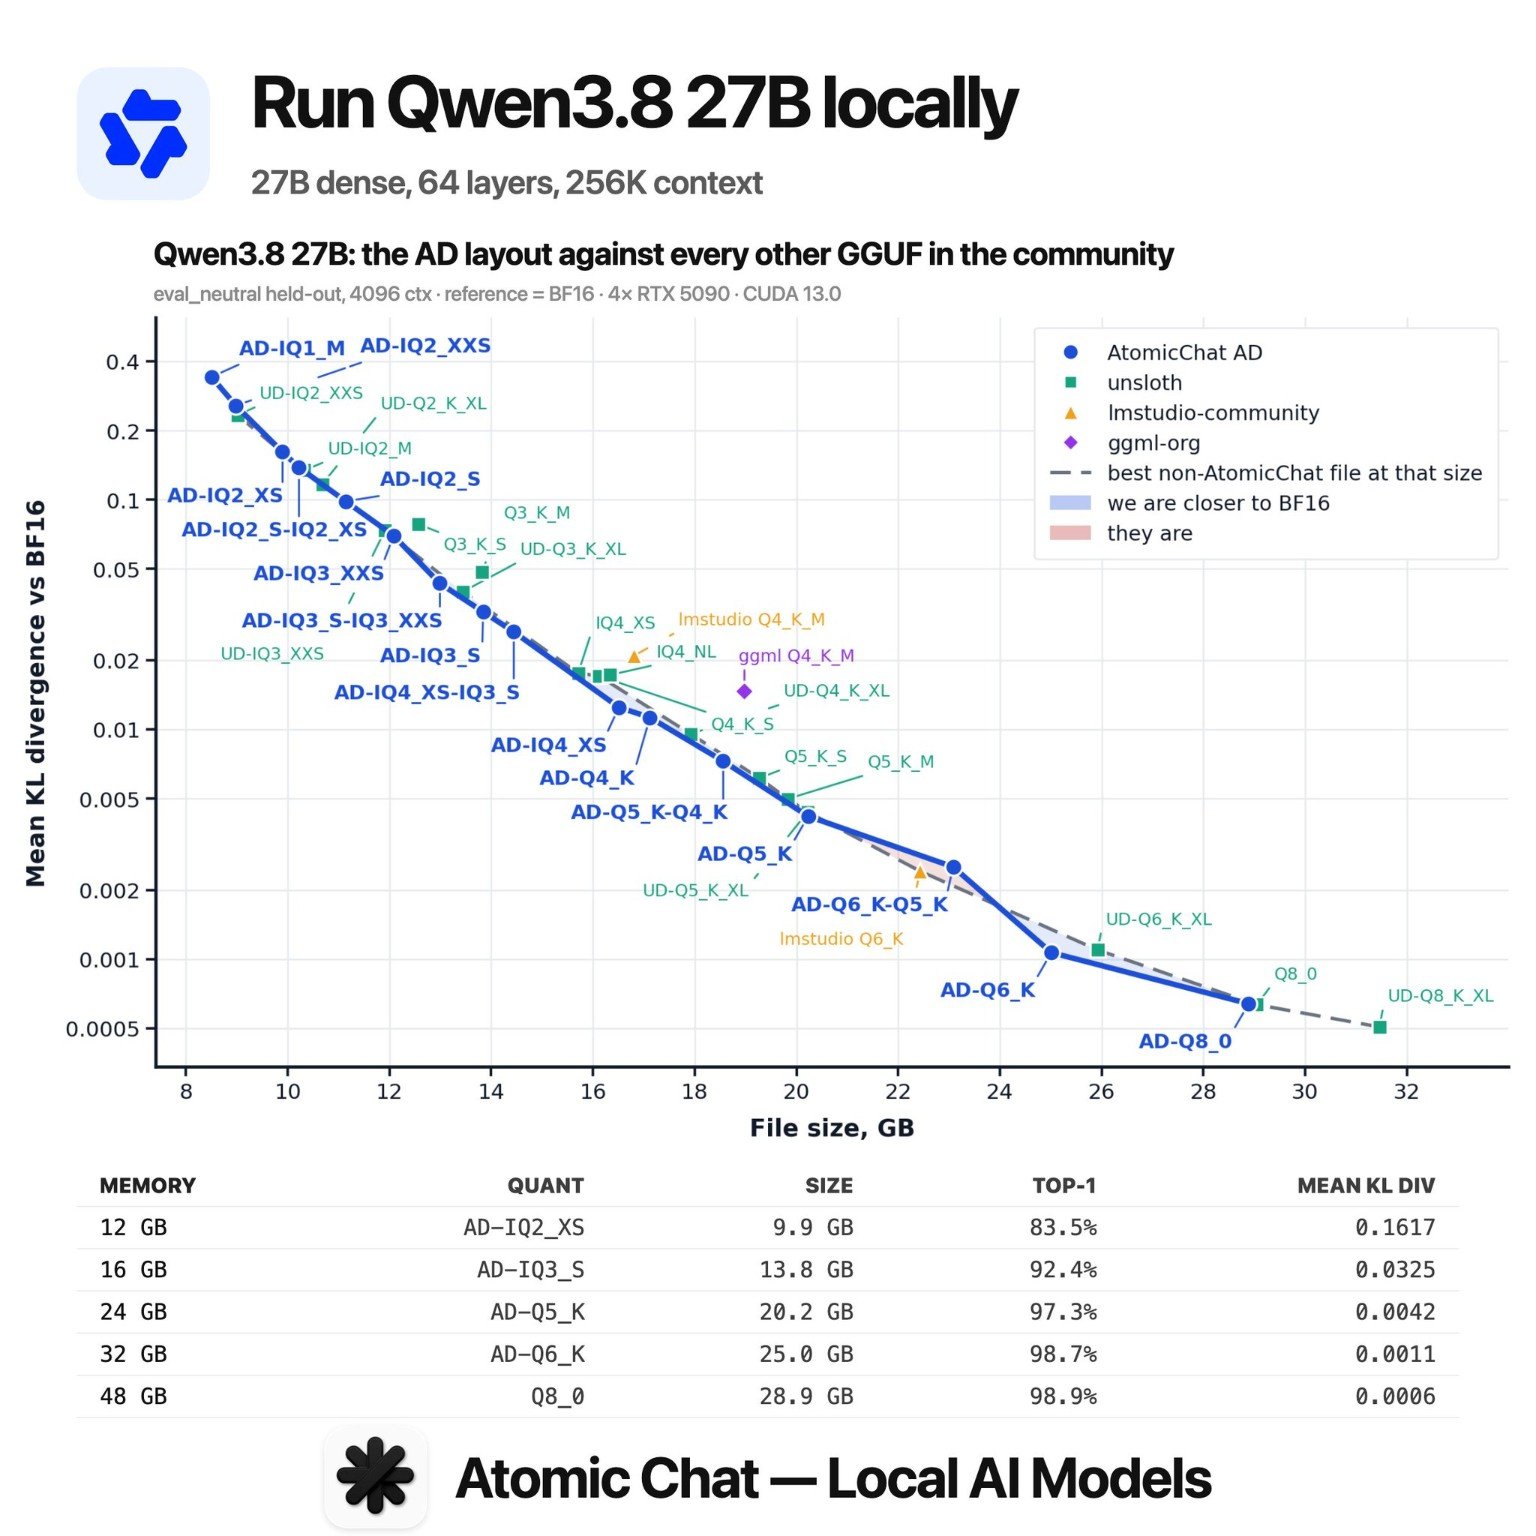
Qwen 3.8 27b를 쓰시는 분들은 이 이미지 저장해 두시면 좋겠습니다.
- 다들 Q4_K_S 많이 쓰실 거 같은데, 여유가 있어 램 용량 4G 정도 더 쓰면 BF 16기준 정확도를 약 3% 더 끌어올릴 수 있습니다.
- Kv 캐쉬는 Q4가 아니라 Q8을 쓰면 속도와 정확도의 균형을 잡을 수 있습니다. https://t.co/4Hzvfz3NNj
- 2원문 보기
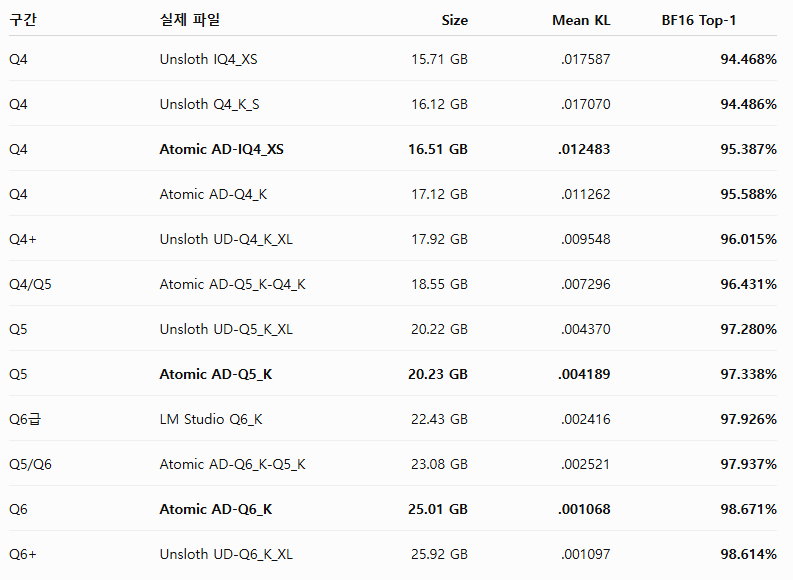
Q4~Q6 양자화 정리.
스윗스팟은 Q5~Q6 인 듯 합니다. 특히 Vram 램 여유가 있어 Q6를 올릴 수 있으면 베스트네요.
그 이상은 큰 의미가 없을 듯 합니다. https://t.co/o2nzaAdiNj
- 3@ramztd 정답입니다. 그래픽카드를 포함한 데스크탑이 째로 필요하죠.원문 보기
- 4원문 보기
@ramztd 다만 이게 돌고 돌아서, 맥을 사면 느린 프리필에 환장하고 Dgx Spark 를 사면 낮은 대역폭으로 답답함을 느끼고 그래서 데스크탑+그래픽카드를 사면 Vram 이 부족하고.
의 무한고리에 갇히게 되죠. 결국 다 사게 됩니다 ㅋㅋㅋㅋㅋㅋㅋㅋㅋ
- 5@tinypia 저도 24가 기본이라서요. ;ㅁ; 이리 쥐어짜고 저리 쥐어짜고 있어요.원문 보기
- 6원문 보기
@tinypia 디코드 속도 넉넉하시면 Kv Q4 로 메모리 챙기시는게 좋죠.
사실 루나맥스가 더 좋죠 ㅋㅋㅋ
- 7@ShankhadeepSho1 테스트 결과물을 모아 둔 것 뿐이에요. 저는 Q5 가 시스템 한계네요.원문 보기
- 8원문 보기
Qwen 2.8 27b를
-3090 단일 Q4 로 40Tok/s 로 쓸 것인가. -3090+추가 Vram(다른 그래픽카드 Split)으로 Q5 Kv Q8로 30Tok/s 로 쓸 것인가.
흠
- 9원문 보기
- 10@fucilator_3000 앗 거기선 Dense 27b 모델 실행이 어려울 거에요. 일단 로컬이 필요하면 gemma4 12b 모델을 써 보는 것을 추천해요.원문 보기
- 11원문 보기
@Abdullah_Cloak 당장 필요하다면 언슬로스의 UD-IQ3_XXS 12G 모델을 쓰면 KVQ4 로 싱글턴 작업 정도는 할 수 있을 여유 메모리를 확보할 수 있을 거에요.
말씀하신대로 35B Moe 가 조금 더 여유롭습니다.
- 12원문 보기
@fucilator_3000 Qwen Base 의 Qwopus 3.5 9b 도 코드품질은 꽤 우수할 꺼에요. (LFM은 제가 안 써봐서 잘 모르겠네요.)
맞는 모델을 찾는 게 중요해요~
- 13@MrWessss 제대로 보신 게 맞습니다 :)원문 보기
- 14@moppelmat 하하하 맞아요. 하지만 그 시스템을 구성하려면 보드도 지원해야 하니까요.원문 보기
- 15@Zila_Lava 지식이 갈수록 저렴해지고 있어요~원문 보기
- 16@thinkgod123 부럽당 전 3090이 메인이라 ㅠ_ㅠ원문 보기
- 17@Zila_Lava 지식의 축적과 경험의 방식은 과거랑 또 다른 변화를 겪을 것입니다. 지식의 New Era 인 것이죠.원문 보기
- 18@Bitcopath 7900XTX 면 24g Vram 이니 1기가를 알뜰살뜰하게 쓸만한 가치는 있는 것 같습니다. 일단 모델 양자화 수준을 낮추는것보단 Kv 캐쉬쪽이 효과가 더 좋은 듯 합니다.원문 보기
- 19@InvesterTurtle 아닙니다. 모델을 올려서 쓸 수 있는 모든 사용자에게 의미가 있습니다.원문 보기
- 20@Edward69544044 모델을 올릴 수만 있다면요. 다만, 에이전틱 작업을 위해선 컨텍스트 크기가 중요하다보니 마냥 올리는 것은 부정적입니다.원문 보기
- 21@cgfixit @grok 가급적 ollama 보다는 llama.cpp 를 직접 쓰는 것이 좋습니다. 그게 불편하면 lmstudio 나 unsloth studio를 쓰는 걸 권합니다.원문 보기
- 22@almostanhour https://t.co/NflojrvEdG원문 보기
- 23원문 보기
@AFGroyper9000 그 제품은 토큰 디코드가 문제라서 모델 자체를 버거워 할 껍니다. 사실 제품 설계가 좀 잘못 되었다고 생각합니다.
그래도 쓴다면 그냥 Q4 를 써보시는 걸 추천합니다.
- 24@Shoonee27 Q3 라도 꽤 성능이 좋습니다. 양자화 내성이 꽤 좋은 모델입니다.원문 보기
- 25@yetanotherxxx 해당 모델이면 양자화는 Q6도 괜찮겠지만, 디코드와 프리필에서 꽤 어려움을 겪으실 수 있을 겁니다.원문 보기
- 26원문 보기
@TsengSR 아 다들 기준값은 Q4_K_S입니다.
말씀하신 Q4_K_XL은 BF16 적합성이랑 용량적 측면에서 Q5 보다 매력이 조금 떨어지지 않나 추측해 봅니다.
- 27@ashwinkumar_v https://t.co/TapUfNodQ7원문 보기
- 28@Zila_Lava 완전 동의합니다. 일론의 바벨탑은 전 트위터를 하나로 묶었습니다. 그렇다고 트위터를 X로 부르고 싶진 않지만. :)원문 보기
- 29원문 보기
@yorumyokmu https://t.co/rvpcBmXtp7
- 30@Mikerhinos 곧 나온다고 생각하니 기다려 보세요. 저도 꽤 기대하고 있습니다.원문 보기
- 31@YourLastAlex 컨텍스트를 얼마나 어떻게 배치하느냐에 따라 좀 다릅니다. 24G Vram 으로 장기작업에 배치할거면 Q4나 Q3가 나을 수 있습니다. 정확도 3% 정도 손해보는 대신 컨텍스트와 KV캐쉬 그리고 속도에서 이득을 봅니다.원문 보기
- 32@vladaman Vram 은 한정적이니까요. 파레토 최적점은 로컬에도 적용됩니다.원문 보기
- 33@QuantumFlux36 Q6를 써 보시면 될겁니다. 문제 없이 풀컨텍스트에 도달할 겁니다.원문 보기
- 34원문 보기
@asdasdqweqaasd 전 개발서버쪽은 Lmstudio에서 스플릿레이어가 작동을 안해서 말씀하신 수준의 세팅을 하고 있고, Api 머신에선 작동을 해서 Q5 Kv8 풀컨텍스트로 사용하고 있습니다.
Qwen 3.8 27b 는 야생마 모드 (하네스 개입 최소화) 로 둔 뒤 결과를 감사하는 방식의 사용이 지금으로선 좋아 보입니다.
- 35원문 보기
@TM0fo 앗 못도와드릴 거 같은데요. 780M 의 토큰 생성량이 기대 이하라서.
토큰 생산이 지지부진하시면 Rocm 대신 불칸을 써 보시는 것도 방법이긴 합니다. 라데온쪽은 Rocm 컨트롤이 힘들었어요.
- 36@T3rceiraConta @Abdullah_Cloak Q3의 BF16 적중률이 꽤 높은 수준이라 이번 모델에선 Q3 도 추천 영역에 들어갈 거 같네요.원문 보기
- 37@808emanresu 하지만 Kv 캐쉬는 컨텍스트 증가에 따른 메모리 사용량의 주범이 되기 때문에 적절한 양자화는 필요하죠. Bf16으로 컨텍스트를 다 쓸 수 있으면 모르겠습니다만…원문 보기
- 38@asdasdqweqaasd 네 24기가에선 풀컨텍스트는 지금 공개 버전들에선 기리기리하게 어렵습니다. 그래서 풀컨텍스트 찍으려면 차라리 Q3로 다운을 해도 괜찮을 듯 합니다.원문 보기
- 39원문 보기
@AFGroyper9000 그정도까진 아니지만;;; 128G 라는 큰 Vram을 Gpu의 디코드 속도가 받쳐주지 못해요.
하지만 못 돌리는거랑 , 돌릴 수 있는 건 다르니까요.
- 40원문 보기
@TsengSR Q4_K_L 에 풀컨텍스트 MTP 다 넣으면 24G Vram 에 안올라가는 건 매 마찬가지라 Q4_K_S 가 일단 기본값이겠죠.
앞으로 더 많은 개선 방법이 올라오리라 봅니다.
- 41@moppelmat LOL 할 수 있는 최선을 다 하셨군요 ㅋㅋ NVME에 확장키트 ㅋㅋㅋ원문 보기
- 42원문 보기
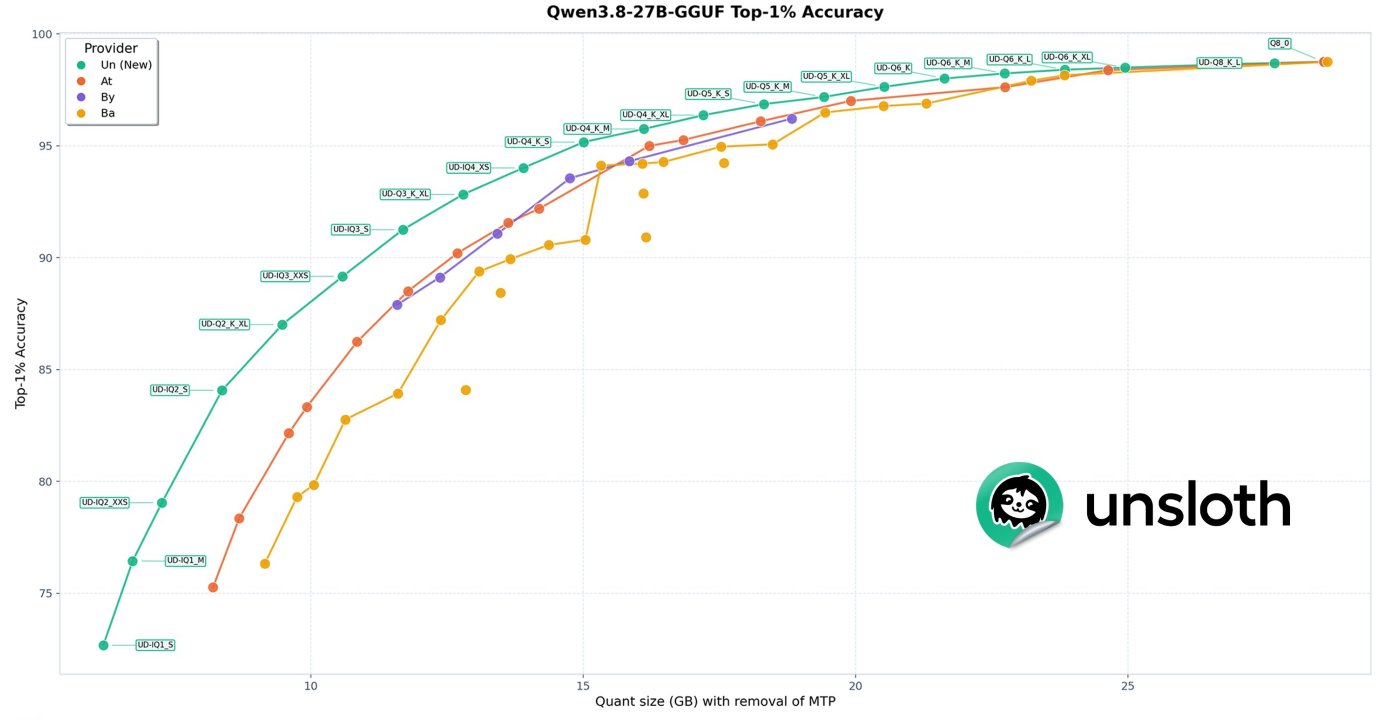
원조 GGuf 맛집 언슬로스가 Qwen 3.8 27B를 한번 더 개선했네요. 이정도면 새로 받으시는걸 추천합니다.
특히 양자화 수준이 높은 모델들의 성능 개선폭이 크네요. https://t.co/S9680u6YQv
문향의 생각
안녕하세요. 문향입니다.
Serio님은 Qwen 3.8 27B 모델을 로컬 환경에서 운용하며 양자화 수준과 VRAM 배분 사이의 최적점을 찾는 과정을 기록하셨습니다. Unsloth의 공식 문서가 27B 모델의 양자화와 실행 조건을 안내하고 있다는 점은 확인되나, Serio님이 제시한 구체적인 정확도 향상 수치나 장비별 권장값은 개인의 실험 결과이므로 독립적인 검증이 필요합니다. 특히 KV 캐시 양자화 설정이 속도와 정확도의 균형을 잡는다는 주장은 공식 자료로 확인되지 않은 경험적 기록입니다.
여기서 중요한 것은 하나의 양자화 수치가 정답이라는 결론보다, 모델 가중치와 KV 캐시가 같은 메모리 안에서 자리를 나눠 쓴다는 운용상의 고민입니다. 구체적인 속도와 품질 평가는 당시 설정과 함께 읽어야 합니다. 메모리에 올라간다는 조건과 원하는 길이의 작업을 무리 없이 처리한다는 조건을 나눠 보는 데 도움이 되는 기록입니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문qwen
공식 문서 및 제작자 자료
Unsloth의 Qwen3.8 문서는 27B 모델의 양자화와 로컬 실행 조건을 안내한다. 작성자의 장비별 실험 결과와 당시 권장값을 독립 검증한 자료는 아니다.
primary-source