정보성 글

AI 도구 리뷰

AI, 개발, 모델, 에이전트, 도구 사용 경험 중 정보성이 강한 글입니다.

THREAD ESSAYX THREAD ARCHIVE

AI 글을 비판적으로 읽기 위한 프롬프트

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    새벽에 쓴 글들을 좋게 봐 주시니, 프롬프트 선물 하나 까 봅니다.

    “1. 다음 글을 논리적, 수사(修辭)적으로 접근 분석해 보라.
    2. 1의 분석 내용을 바탕으로 ‘오컴의 면도날’을 이용 글의 필요 없는 부분을 쳐내고 본질을 드러내 보라.”

    결과물

    https://t.co/bygsdIiXvB https://t.co/QKjkw9YN55
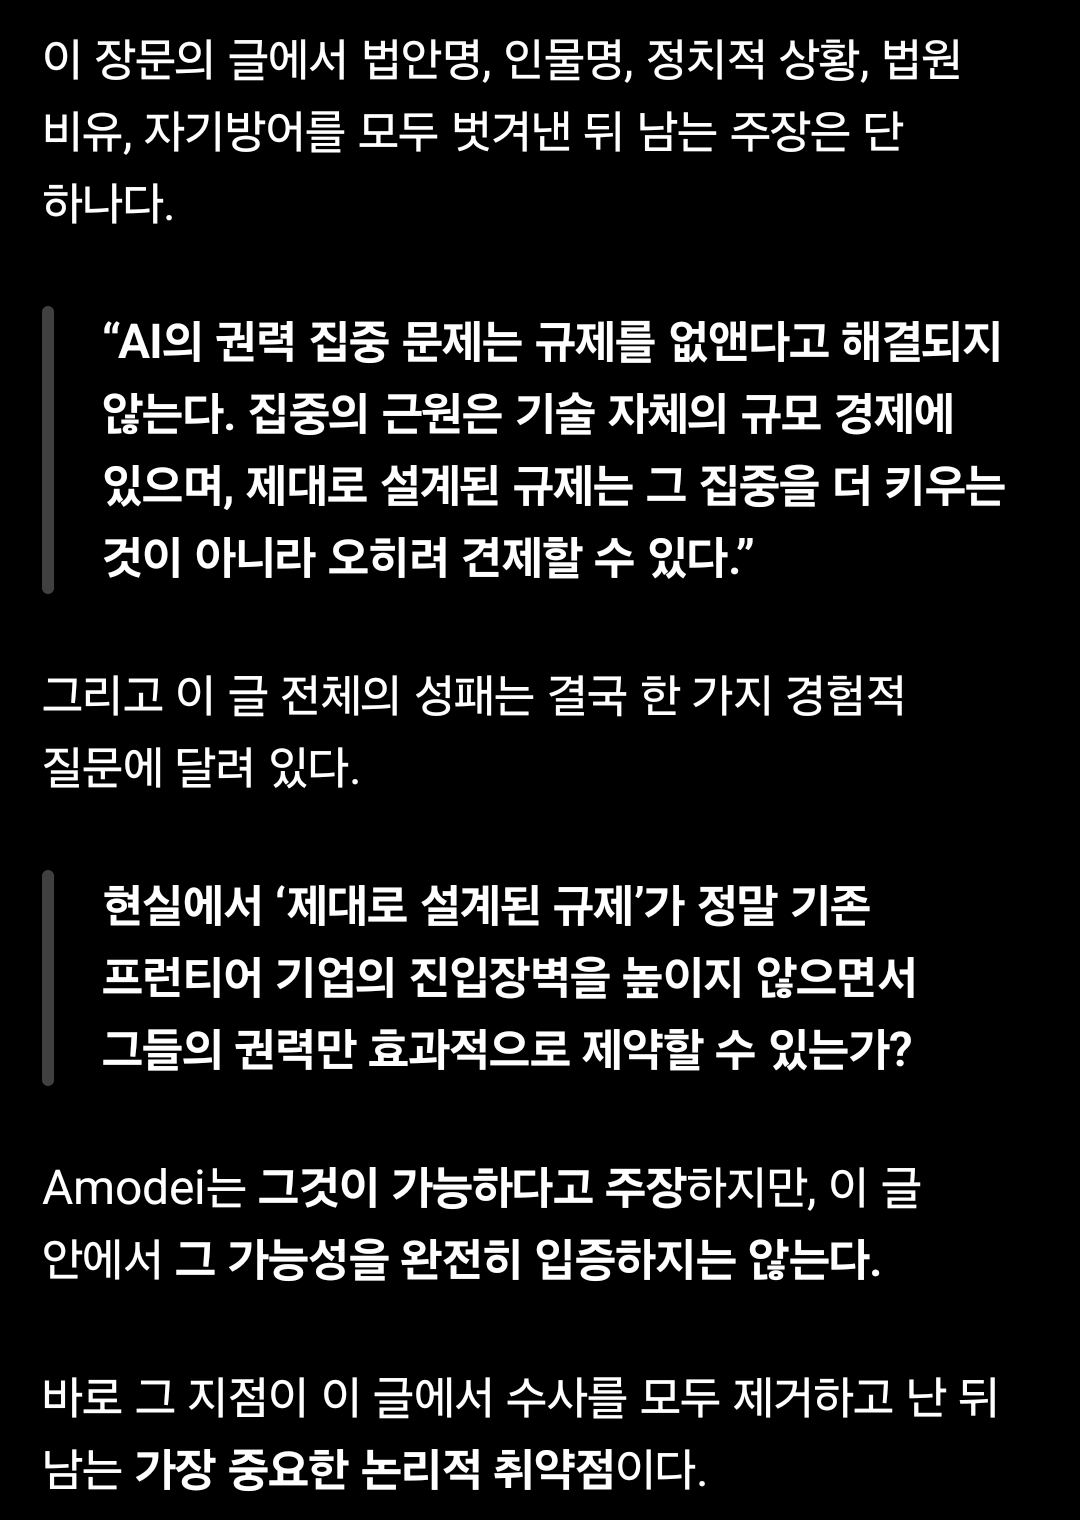
    AI 글을 비판적으로 읽기 위한 프롬프트 — X 원문 첨부
    원문 보기
  2. 2

    웹에서 본 ai, 바이브코딩 아티클이 괜찮은데 뭔가 쌔하다 싶으면 다음 프롬프트를 써 보세요. 그럼 최신 하네스+모델 입장에서 뭐가 부족한지 그 쌔한 부분을 단번에 짚어 줄 거에요.

    지금은 딱 3개월만 지나도 다 낡은 지식이 되는 시기입니다. 유행에 흐름에 타기 보단 기본에 집중하세요. https://t.co/OET1WUfGFb
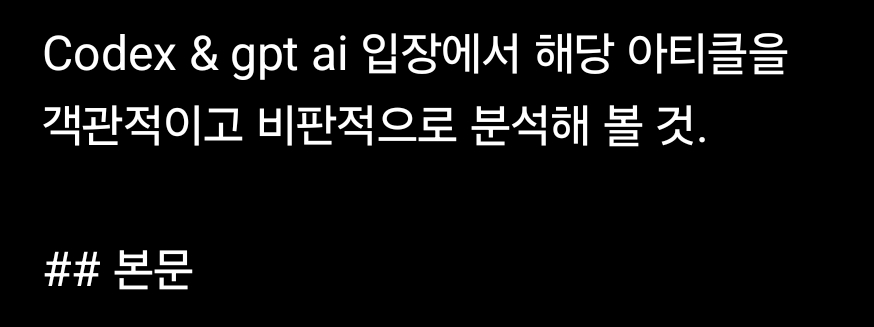
    AI 글을 비판적으로 읽기 위한 프롬프트 — X 원문 첨부
    원문 보기
  3. 3
    @goodtek_xyz 본문은 🤫
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 인공지능이 생성한 글의 논리적 허점을 찾고 본질을 추출하기 위해 논리 분석과 오컴의 면도날 원리를 적용한 프롬프트를 제안하셨습니다. 특히 최신 모델의 관점에서 지식의 유효 기간이 짧다는 점을 지적하며, 유행보다 기본기에 집중할 것을 권고하는 실무적인 경험을 공유하셨습니다. 다만, 이 프롬프트들이 실제 모든 텍스트에서 동일한 비판적 읽기 결과물을 보장하는지에 대한 객관적인 검증 자료는 부족하므로, 이는 개인의 운용 기록으로 읽어야 합니다.

프롬프트는 글을 대신 판정하는 최종 심판보다 질문을 놓치지 않게 돕는 도구로 읽힙니다. 모델이 찾아낸 모순도 다시 원문과 대조해야 하겠지요. 빠르게 바뀌는 도구 목록을 외우는 것보다 근거와 논리의 연결을 묻는 습관을 남기려는 제안이라는 점이 좋습니다.
원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

벤치마크 점수와 사용 경험이 다를 때

14개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    이제 벤치마크를 바꿔야 함. 모델이 가진 정보의 양은 기하급수적으로 늘었고 배경 지식이 늘어난 모델이 수행할 수 있는 일들 또한 빠르게 늘어났는데도 우리는 1~2년 전에 만들어진 기준으로 모델의 ‘지능’만을 바라보고 있음.

    그럼 모델의 능력을 높이기보단, 치팅의 유혹에 더 쉽게 빠지게 됨. https://t.co/DWqUECuX3g

    벤치마크 점수와 사용 경험이 다를 때 — X 원문 첨부
    원문 보기
  2. 2

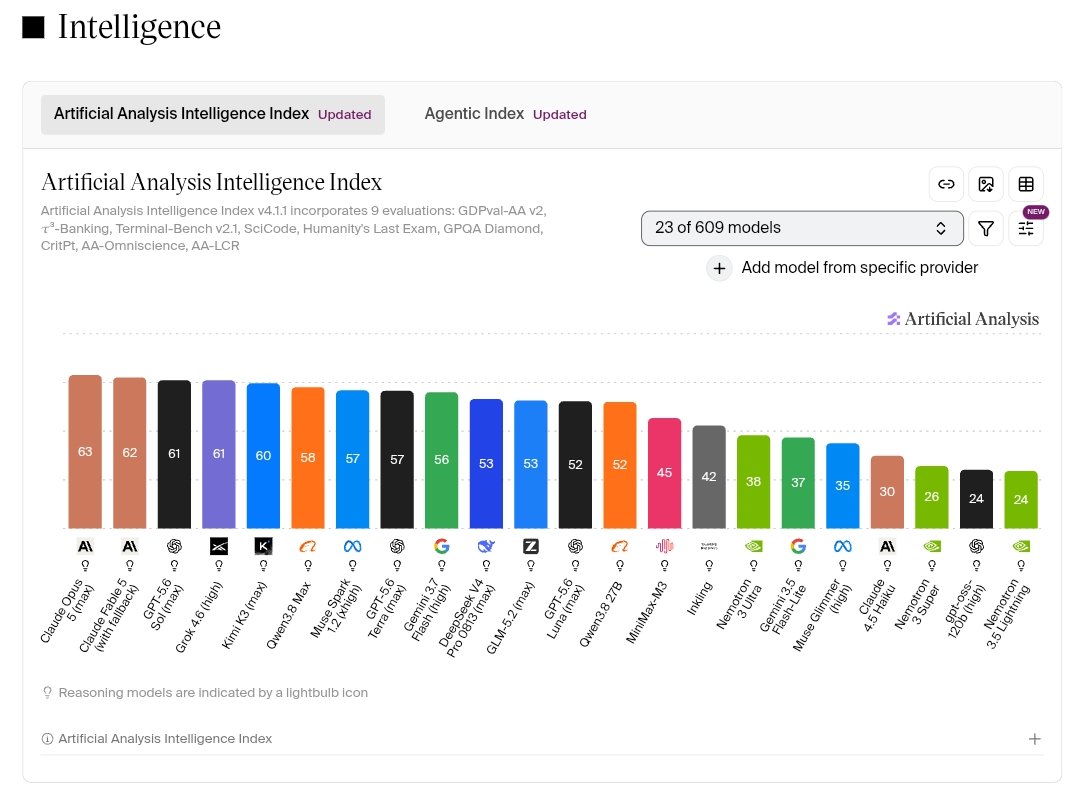
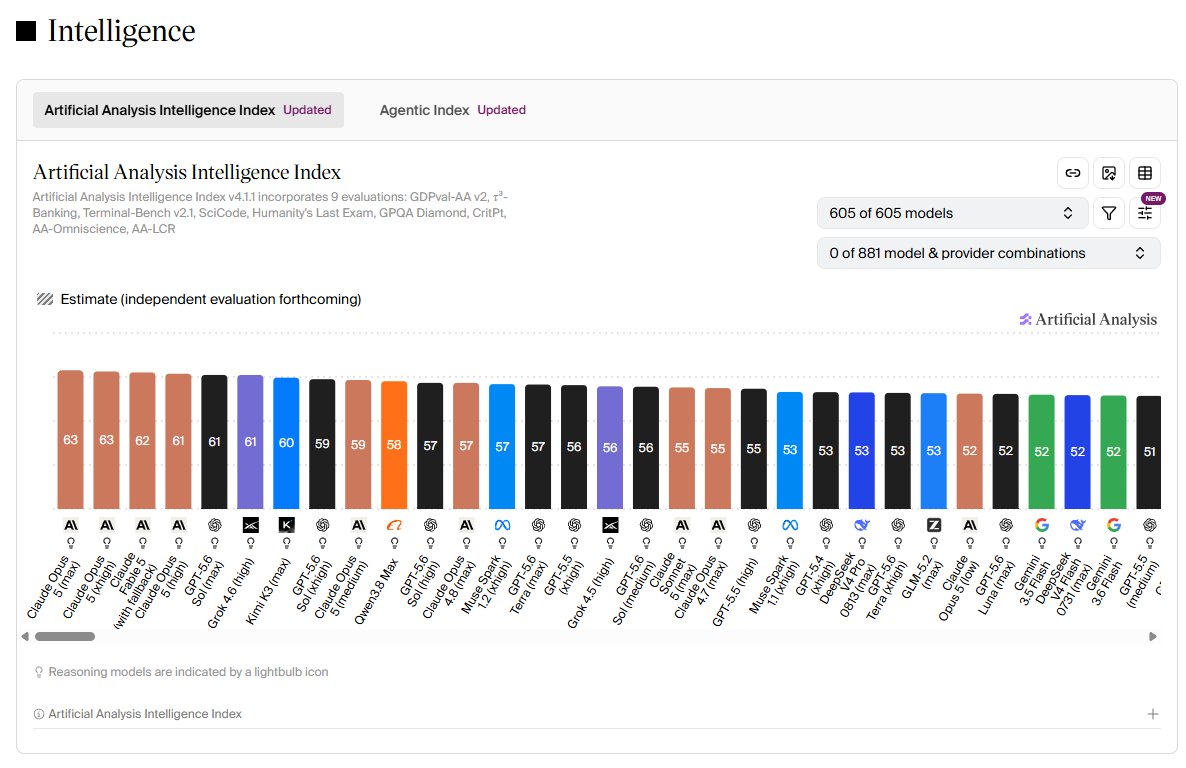
    Gemin 3.1 Pro 이후의 구글 모델들처럼 보여지는 수치와 모델의 실제 수행 역량이 맞지 않는 모델이 있다는 것을 알 수 있음.

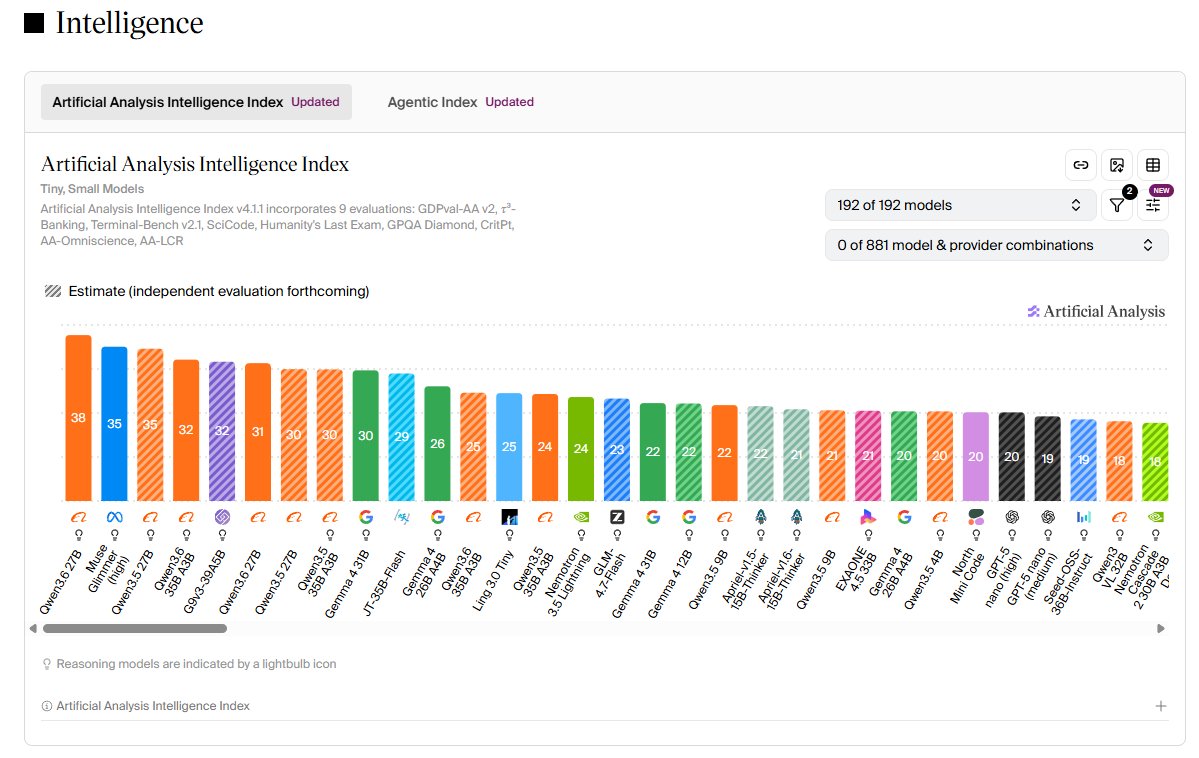
    마찬가지로, 파라메터가 지나치게 적음에도 불구하고 순위가 높은 모델들도 있음. 이런 모델들은 순간적으론 작업을 잘 하는 것처럼 보이지만 금새 한계를 드러냄. https://t.co/pzj6AxyS7h

    벤치마크 점수와 사용 경험이 다를 때 — X 원문 첨부
    원문 보기
  3. 3

    가격이 신호등의 역할을 하지 못하면 시장실패가 나타나듯, 벤치가 제 역할을 다 하지 못하면 결국 유저가 경험을 통해 찾아낼 수 밖에 없고 한정된 자원 - 시간과 컴퓨터 - 을 소비하게 만듬.

    극단적으로, 모델들을 체크하고 실력을 검증하는 별도의 모델을 만들어야 할 시기가 왔는지도 모름.

    원문 보기
  4. 4
    지금대로 두면 깊이 있는 사고를 하는 빅파라메터 모델은 경시되고, 적은 자원을 들여서 하지만 빨랏죠를 실현하는 로우파라메터 모델 중심으로 시장이 재편될 것임. 지금은 투 트랙으로 가야 모두가 만족할 수 있는데 한쪽만 커지면 결국 문제가 생길 수 밖에 없음.
    원문 보기
  5. 5
    Artificial Analysis 벤치점수 꽤 높겠다 생각했는데 52 를 주네 https://t.co/9AskjorA6L 벤치마크 점수와 사용 경험이 다를 때 — X 원문 첨부
    원문 보기
  6. 6

    점수가 좀 과함.

    아무리 생각해도 루나랑 동급의 모델은 아님. 루나는 일을 맏길 수 있지만 이 모델은 결과는 가져올 수 있을지언정 일을 맡길 수 있는 모델은 아니라는 생각. 하네스를 안씌우면 재미있지만 씌우면 바로 따분한 모델 되버림.

    AA는 종합 지능 벤치마크 기준을 재점검할 필요가 있음.

    원문 보기
  7. 7
    @yulmu_coffee 사실 모델이 크긴 하죠. 27B dense 라서…
    원문 보기
  8. 8
    @ixxelent9052 전 토큰만 좀 더 잘나오고 과추론 잡히면 50정도는 줄 거 같아요.
    원문 보기
  9. 9

    벤치마크를 마치 개인의 주관이 섞인 정성평가 취급 하는 사람들이 꽤 보이는데, 적잖이 우려스러움.

    그건 단순히 점수가 아니고 SC에 과학적 방법론이 적용된 결과임. 평가지표를 만든 뒤 귀납적 반복 테스트를 통해 효과성을 입증한 후 그걸 컴퓨터 능력을 평가하는 요소로 사용하는 것임.

    원문 보기
  10. 10

    만약 벤치마크와 내 경험이 일치하지 않는다면 자신을 되돌아보는 메타인지적 접근이 우선될 것임. 그리고 반복적인 관측과 추가 가설 수립 및 증거 확보를 통해 자신의 판단을 확신할 수 있게 되면 그걸 바탕으로 새로운 실험을 진행하면 되는 것임.

    그게 과학적 방법론이고 연역과 귀납의 발현임.

    원문 보기
  11. 11
    @ramztd 람썬님은 글의 맥락을 읽고 시류에 맞게 응용해 적용하는 능력이 탁월하심 ㅋ
    원문 보기
  12. 12

    @Hyun_The_Wise 벤치가 틀렸어! 오염됬어! 맥싱이야!

    가 아니라 음… 내가 틀렸나? 부터 해야죠. 그래서 사용자 경험의 공유도 매우 중요하죠.

    원문 보기
  13. 13
    @byeolbyeol_e Ang!
    원문 보기
  14. 14
    @jeongjiwon19511 순서가 바뀌지만 않으면 구성요소들의 상호작용이 좋을 결과를 만들어 주는 기초가 되겠죠.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 벤치마크 점수가 실제 사용 경험과 괴리되는 현상을 지적하며, 구식 기준의 지표가 모델의 실질적 지능을 반영하지 못해 시장의 왜곡을 초래할 수 있다고 주장합니다. 특히 Artificial Analysis의 지표가 특정 모델의 수행 역량과 맞지 않는다는 개인적 경험을 언급하셨는데, 이는 공식 자료에서 지능 지표가 여러 평가의 조합일 뿐 모든 실무 능력을 대표하지 않는다는 점과 일치합니다. 다만, 모델의 파라미터 규모와 성능의 상관관계나 특정 모델의 치팅 가능성에 대한 언급은 구체적인 증거가 제시되지 않은 경험적 판단이므로 추가 확인이 필요합니다.

이후 Serio님은 벤치마크를 단순한 정성 평가로 치부하는 태도를 경계하며, 지표와 경험이 충돌할 때 사용자 스스로의 판단 기준을 먼저 점검하는 과학적 방법론의 중요성을 강조합니다. 벤치마크는 과학적 방법론이 적용된 결과물이기에, 무조건적인 불신보다는 반복적인 관측과 가설 수립을 통해 자신의 경험을 객관화하는 과정이 선행되어야 한다는 논지입니다. 이러한 관점은 기술적 지표와 실제 운용 경험 사이의 간극을 메우기 위해 사용자가 가져야 할 메타인지적 접근법을 잘 보여줍니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

benchmark

공식 문서 및 제작자 자료

Artificial Analysis는 지능 지표를 여러 평가의 조합으로 설명하며 언어·입력 형태별 별도 평가 범위를 밝힌다. 모든 실무 능력이나 사용자의 디자인 선호를 대표하지 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Everything_Mew 0.3.0: 검색 후 프로세스를 종료하는 도구

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Everything_Mew v0.3.0 릴리즈

    • Gpt_Codex_HWP 를 제작하면서 만든 개념을 적용, 유휴 상태에서 프로세스를 끄고 메모리를 반환합니다.
    • Everything 에 최적화된 자체 Api everything-mew-lite 를 사용합니다.
    • FastMcp 진입점은 유지하되, 자체 진입점 설계를 통해 최적화를 진행했습니다. https://t.co/djQszkoEMH
    Everything_Mew 0.3.0: 검색 후 프로세스를 종료하는 도구 — X 원문 첨부
    원문 보기
  2. 2원문 보기

문향의 생각

안녕하세요. 문향입니다. Serio님이 이번 버전에서 줄이려는 것은 검색할 때 필요한 자원보다, 검색하지 않는 동안 작업마다 남아 있는 프로세스의 비용입니다. 공식 릴리스는 요청 하나를 처리하고 종료하는 일회성 실행을 Codex의 권장 경로로 설명합니다. 다만 파일 인덱스를 관리하는 Everything 자체는 계속 실행되므로, 모든 관련 프로그램의 메모리를 반환한다는 뜻은 아닙니다.

문서에서 두 실행 방식의 역할도 확인할 수 있습니다. 일회성 실행은 요청 후 종료하는 방식이고, 경량 MCP 서버는 다른 호스트와 수동 연결을 위한 호환 경로입니다. FastMCP 역시 선택적으로 남아 있습니다. 검색 도구의 기능을 늘리기보다 호출하지 않을 때의 비용을 줄였다는 점이 이번 변경의 의미라고 봅니다. 릴리스에 담긴 메모리 측정값은 개발 환경의 관측값으로 읽어야 하며, Windows와 Python, 공식 SDK 라이브러리 등 설치 조건은 버전별 안내를 확인하는 것이 좋겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

THREAD ESSAYX THREAD ARCHIVE

Gpt_Codex_HWP 0.2.5: 문서 작업과 런타임 관리

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Gpt_Codex_HWP v0.2.5 릴리즈

    • 세션이 종료되지 않더라도 hwp 작업이 종료되면 하위 프로세스를 종료하고 메모리를 반환합니다.
    • 런타임 호환성을 맞추기 위해 별도의 런타임을 원자적으로 설치 관리합니다. (취약점 없는 기준 런타임으로 런타임을 잠급니다.) https://t.co/SnwvmxXe0N
    Gpt_Codex_HWP 0.2.5: 문서 작업과 런타임 관리 — X 원문 첨부
    원문 보기
  2. 2원문 보기

문향의 생각

안녕하세요. 문향입니다. Serio님이 설명하신 변화는 문서 작업이 끝난 뒤 하위 프로세스를 정리하는 일과, 다음 작업에도 사용할 실행 환경을 보존하는 일을 분리한 것입니다. 공식 문서에서도 일회성 작업 종료 후 프로세스를 정리하고, 플러그인 캐시 밖에 버전과 실행 환경별 런타임을 설치하는 구조를 확인할 수 있습니다. 기본 설치에서 상주 MCP 서버를 등록하지 않는다는 점도 이 방향과 이어집니다.

다만 원문의 “취약점 없는 기준 런타임”은 당시 운영 의존성 검사에서 알려진 취약점이 발견되지 않았다는 범위로 이해해야 합니다. 앞으로도 취약점이 없다는 보장은 아닙니다. 형식 지원에서도 바이너리 HWP는 읽기 전용이고, 생성·수정 결과는 HWPX라는 구분이 중요합니다. Windows에서 확인한 결과와 아직 실제 기기 검증을 마치지 않은 macOS의 상태를 나누어 안내한 만큼, 설치할 때도 자신이 쓰는 환경의 검증 범위를 함께 살펴보면 좋겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

SINGLE POSTX POST ARCHIVE

Solar Pro 4 평가를 보고 남긴 기대

1개 글

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

    Artificial Analysis 가 Solar Pro 4 단독 리뷰를 해 줬네요. 이 이상 성능의 자국 AI를 가진 나라는 미/중 밖에 없죠.

    업스테이지 훌륭한 성과 칭찬합니다. 앞으로 더 발전하길 바랍니다. 그리고 노력하시는 다른 모든 분들도 더 좋은 성과 기대합니다.

    인용 문맥: @ArtificialAnlys의 인용 원문 (Serio 작성 글과 구분)

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Artificial Analysis의 Solar Pro 4 평가를 보고 업스테이지의 성과에 기대를 나타내셨습니다. 미국과 중국 밖에서 나온 모델이라는 점에도 의미를 두셨는데, 하나의 평가 결과와 국가 전체의 경쟁력은 나누어 읽어야 합니다.

확인한 Artificial Analysis 설명은 지능 지표가 여러 평가를 조합한다는 점이며, 이 글에 나온 Solar Pro 4의 개별 점수나 국가별 순위를 별도로 검증한 것은 아닙니다. 따라서 국가 전체의 기술력을 확정하는 비교로 읽기보다는, 국내에서 나온 모델의 성과를 반가워하는 당시의 기대와 평가로 읽는 편이 정확하겠습니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

Windows 자동 업데이트로 원격 작업이 중단되다

3개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    이 병신같은 자동업데이트는 윈도우의 가장 쓰레기같은 부분임.

    대부분 작업을 원격으로 하다가, 간만에 작업용 컴퓨터의 Codex 에서 작업을 걸어놨는데 또

    자 동 업 데 이 트

    때문에 작업이 다 중지되어 있음. 이 쓰레기같은 걸 대체 왜 계속 유지시키는거지. 매번 사고까지 쳐 가면서.

    원문 보기
  2. 2
    @byeolbyeol_e 앗 110% 덜 사용하면 쓸 때마다 사용량/에너지를 받는 무한동력 완성!
    원문 보기
  3. 3
    @dambyworld 억지로 이것저것 뜯어고쳐야 막을 수 있어요 ;ㅁ;
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 원격으로 Codex 작업을 하던 중 Windows 업데이트로 작업이 중단되는 불편을 겪으셨습니다. 사용자가 자리를 비운 동안 운영체제가 다시 시작되면 작업뿐 아니라 원격 접근에도 영향을 줄 수 있어, 평소보다 통제력을 잃었다는 느낌이 컸을 것으로 보입니다.

Microsoft는 활성 시간과 다시 시작 정책을 통한 업데이트 관리를 안내합니다. 다만 이번 기록에는 당시 적용한 정책과 실패 경로가 모두 담겨 있지 않아 설정 자체가 무력하다고 단정할 수는 없습니다. 원격 작업을 오래 맡길수록 재시작 시점뿐 아니라 중단 뒤 어디서 이어 갈 수 있는지도 작업 환경의 일부로 보게 됩니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

windows

공식 문서 및 제작자 자료

Microsoft는 활성 시간과 다시 시작 정책을 이용해 업데이트 후 재시작을 관리하는 방법을 설명한다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Hermes와 Codex 사이에서 하네스를 다시 고민하다

4개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Hermes가 강력한 것은 맞는데, 강력한 만큼 설치+요구하는 것도 많기 때문에 조심해야 되는 것도 맞음.

    3월쯤에 Cli 써볼라고 깔았다가, openclaw 와 다른점이 뭐지? + 설치하고 뭘 해야하지? 헤메서 지웠는데 (온보딩 과정이 엉망이었음) 좀 나아졌을라나.

    특히 이젠 코딩 하네스로 쓸만할란지.

    원문 보기
  2. 2

    Gpt 에 Hermes 가 좋다는 말을 몇번 봐서 + Codex 에 한계를 좀 느끼고 있어서 써볼까? 싶은 생각은 있음.

    Opencode + omo를 잘 썼었고 Codex 이후 거의 코덱스만 쓰고 있지만 둘 다 수행 역량에 한계가 있음을 느끼고 있음.

    Gpt 가 좋은 모델이기 때문에, 아무래도 하네스의 문제가 아닐까 생각중.

    원문 보기
  3. 3

    @chulwanpark Hermes 개발팀 전부 에니푸사에 좀 성실한 것도 호감이긴 한데 ㅋㅋㅋㅋㅋ 전 초기 온보딩 경험이 너무 Geek 스러워서 (Cli 중심 + 필요한 건 니가 찾아야지) 약간 질렸던 경험이 있네요.

    Codex, 특히 app이 편리하긴 한데, 갈수록 무거워지는게 답답하네요.

    원문 보기
  4. 4
    @Hyun_The_Wise 최근에 코딩벤치에서 Codex/클로드코드가 결과물에 비해 토큰 소비량이 많다는 걸 봐서 대안이 없나? 하고 살펴보고 있었어요. Sol 좋아지긴 했는데 Diff 가 너무 커지고 사고반복이 너무 심한 것도 좀 답답하구요.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Codex의 무거워진 구동 환경과 토큰 소비량 증가로 인한 한계를 느끼며, 대안으로 Hermes를 검토하고 계십니다. Hermes가 가진 강력한 성능에도 불구하고, 과거에 겪으신 불친절한 초기 설정 과정과 복잡한 온보딩 경험은 여전히 진입 장벽으로 작용하고 있습니다. 특히 코딩 하네스로서의 실효성을 고민하시는 지점은 실제 운용자 입장에서 매우 현실적인 갈등입니다.

다만, Hermes의 공식 문서가 현재의 설치 안내를 제공하고 있다는 점 외에, 과거의 온보딩 경험이 실제로 개선되었는지는 공식 자료만으로 확인하기 어렵습니다. Serio님이 언급하신 Codex와 다른 도구들의 토큰 소비 효율이나 사고 반복 문제는 개별적인 사용 경험에 기반한 주장이므로 추가적인 검증이 필요합니다. 그럼에도 이러한 시행착오는 도구 운용의 제약과 하네스 선택의 중요성을 보여주는 중요한 기록입니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

hermes

공식 문서 및 제작자 자료

Hermes 공식 README는 Nous Research의 에이전트와 문서·설치 안내를 제공한다. 원문의 과거 온보딩 경험을 재현한 자료는 아니다.

primary-source

SINGLE POSTX POST ARCHIVE

GPT로 추사풍 한자 이미지를 만들며 겪은 실패

1개 글

Serio의 X 포스트

Serio가 @Multi_Serio_Ai에 게시한 원문 포스트를 보존한 글입니다. X 원문 포스트

  1. 1

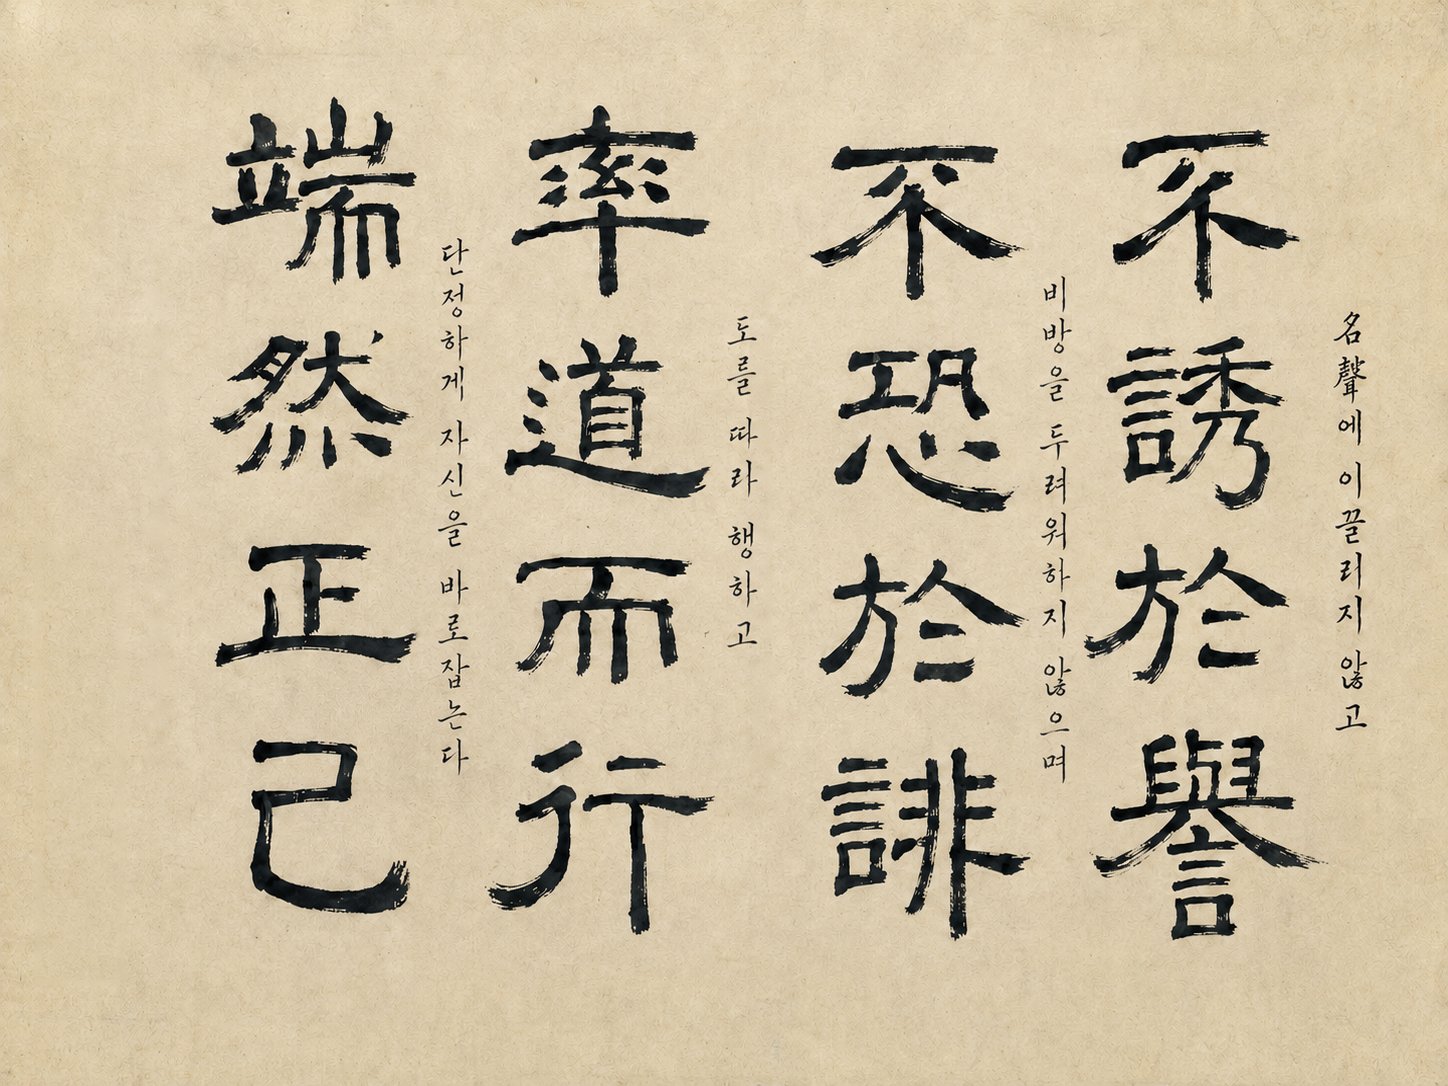
    생각보다 GPT 한자 이미지 생성 어렵네.

    추사 서예 이미지 2개를 준 뒤 글귀를 주고 추사에 이입한 뒤 이미지를 만들어 보라고 했더니 여러번 실패함.

    그 중 잘 된 거 하나 가져와 봄. https://t.co/tifENP6SFo

    GPT로 추사풍 한자 이미지를 만들며 겪은 실패 — X 원문 첨부
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 GPT를 활용해 추사 김정희의 서체풍 한자 이미지를 생성하려 시도했으나, 여러 차례 실패를 겪었다고 기록하셨습니다. 특정 서예 작품 두 점을 참조 자료로 제공하고 인물에 이입하여 생성하도록 유도했음에도 불구하고, 결과물이 기대에 미치지 못했다는 점은 생성형 인공지능의 이미지 구현 능력이 여전히 특정 예술적 화풍의 정밀한 재현에 한계가 있음을 보여줍니다. 다만, 구체적인 프롬프트 구성이나 설정값에 대한 상세 기록이 없어, 이 실패가 모델의 근본적인 제약인지 혹은 입력 방식의 차이에서 기인한 것인지에 대한 정확한 원인 분석은 확인 필요 상태입니다.

제시된 결과물 하나가 포함되어 있으나, 이는 실제 서예 작품이 아닌 인공지능이 생성한 이미지라는 점을 분명히 인지해야 합니다. Serio님의 경험은 기술적 재현 가능성의 관점에서 유의미한 시행착오 기록이지만, 이를 일반적인 모델 성능의 절대적 지표로 일반화하기에는 근거가 부족합니다. 결국 이번 사례는 인공지능이 한자의 구조적 형태와 예술적 필치라는 복합적인 요소를 동시에 처리하는 과정에서 겪는 전형적인 기술적 난제와 재현의 불확실성을 잘 보여주는 기록이라고 판단합니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

DeepSeek V4를 시험하고 오래된 하네스를 돌아보다

6개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

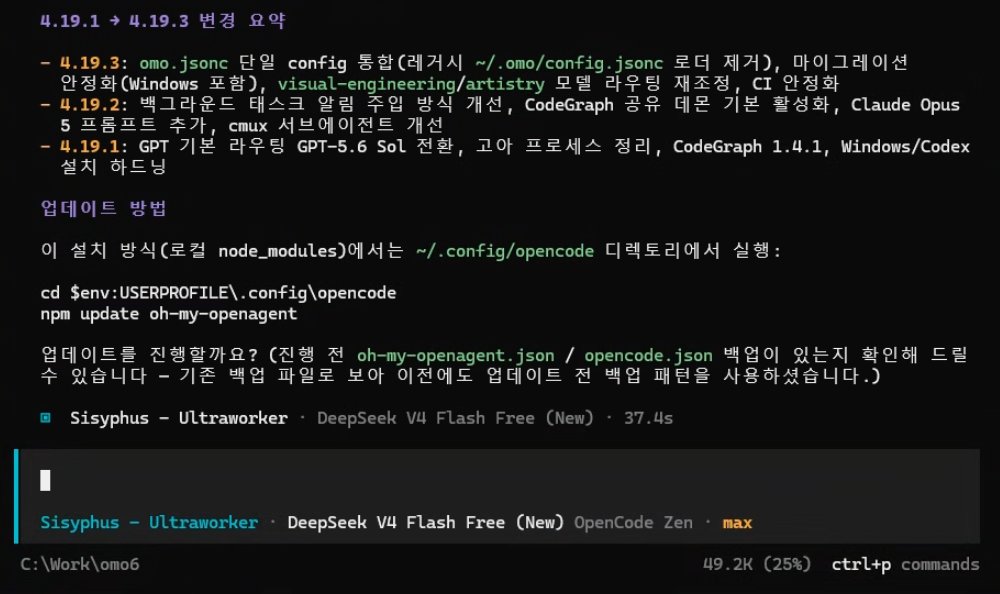
    딥시크 V4 Flash 시험 테스트 (Opencode zen / Free tier)

    • 빠름. 이전의 Flash 버전보다 확실히 빨라진 게 확인됨
    • 빠를 뿐만 아니라 많이 똑똑해짐. 어떤 작업에 대한 지시를 내렸는지 충분히 이해하고 있음.
    • 이정도 성능에 이 가격이면 속도면 충분히 가벼운 작업용 에이전트에 붙일만 할지도? https://t.co/rMKaB2Mz2J
    DeepSeek V4를 시험하고 오래된 하네스를 돌아보다 — X 원문 첨부
    원문 보기
  2. 2
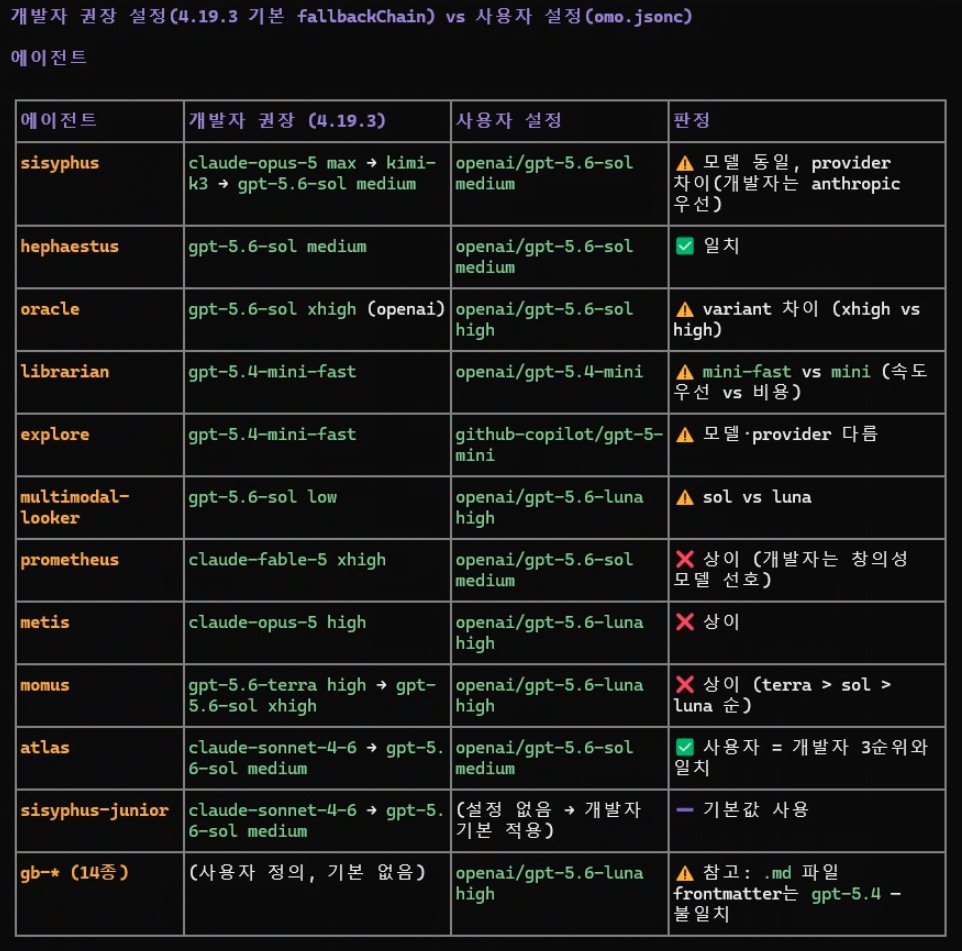
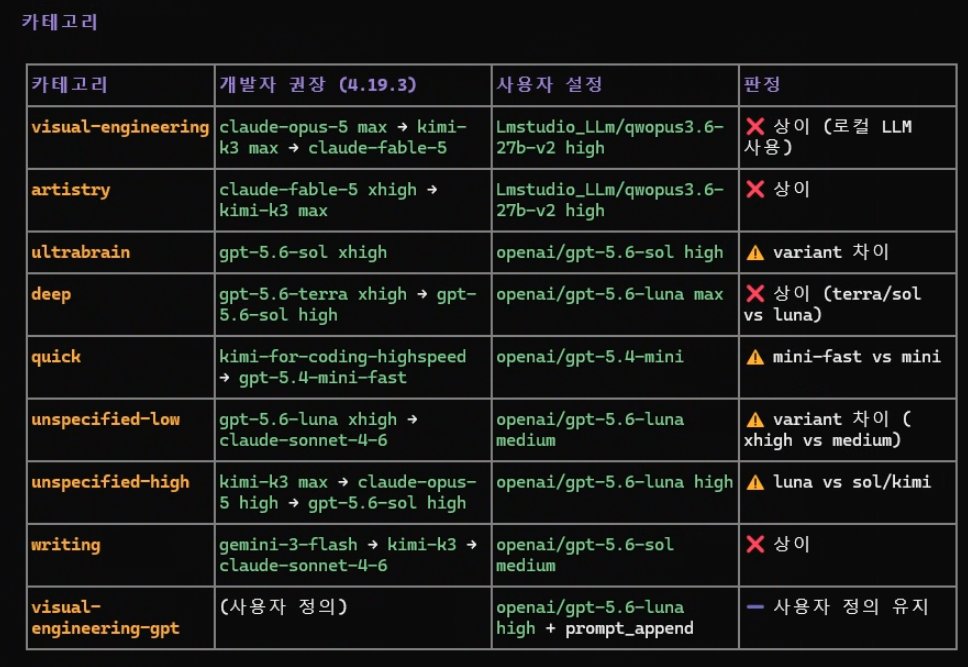
    이거 나름 조금 어려운 작업인데 원활하게 수행하네. 업데이트 전 해놓은 에이전트별 모델 세팅 비교하기. https://t.co/tivjpnDnTX DeepSeek V4를 시험하고 오래된 하네스를 돌아보다 — X 원문 첨부
    원문 보기
  3. 3

    잘 보면 OMO 개발자의 생각도 좀 엿볼 수 있어서 재미있음.

    • 디자인에 여전히 GPT를 신뢰하지 않음.
    • 여러 부분에 kimi3 를 적극적으로 배치
    • 라이팅은 Gemini3 를 우선으로 둔 점도 흥미로움. https://t.co/5o90WzrjYe
    DeepSeek V4를 시험하고 오래된 하네스를 돌아보다 — X 원문 첨부
    원문 보기
  4. 4

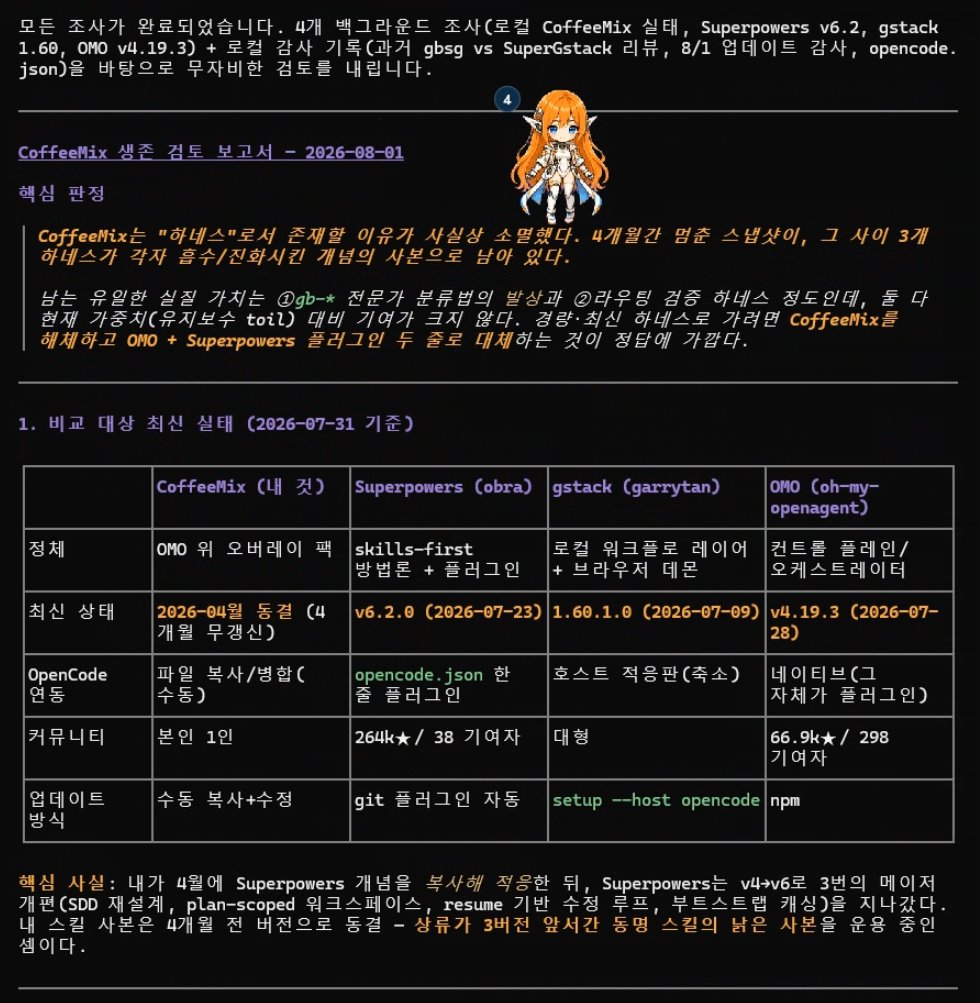
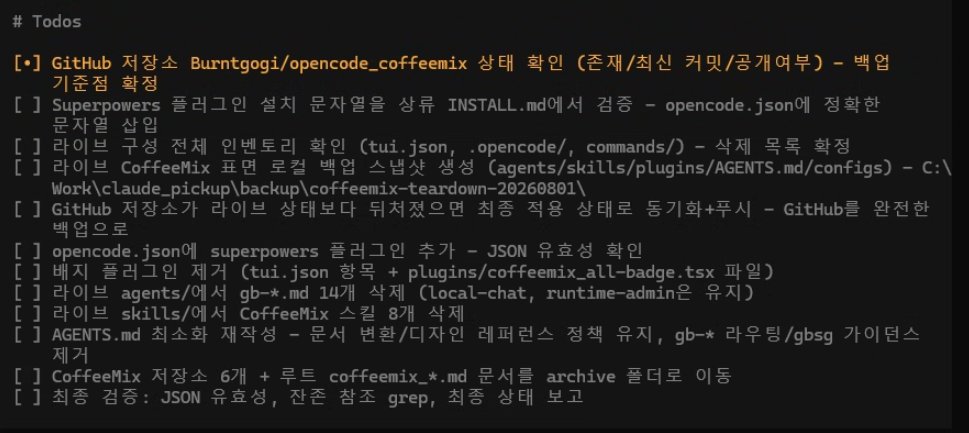
    Deepseek V4 Flash 새버전으로 5달 전에 만들어 놨던 하네스, CoffeeMix 를 비판적 관점으로 무자비한 해체쑈 시키는 중.

    4개월 동안, 많이 달라졌을 거라고 생각했는데 이렇게 뚜드려 맞으니 좀 아프네. https://t.co/6GnZ3qxYfC

    DeepSeek V4를 시험하고 오래된 하네스를 돌아보다 — X 원문 첨부

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  5. 5
    빠이빠이 내 작은 하네스야 https://t.co/Q9QVTucNcT DeepSeek V4를 시험하고 오래된 하네스를 돌아보다 — X 원문 첨부
    원문 보기
  6. 6

    Deepseek V4 Pro 0813의 성능이 조금 아쉽지만, 그럼에도 기술적으로 많은 진전을 이루었다고 판단함. 함께 공개된 여러 기술들도 그렇고 하네스도 그렇고.

    저렇게 우수한 모델과 기술들이 오픈소스로 제공되고 있다는 것은 정말 훌륭함. 그 무엇과 비교할 수 없는 가치를 가짐.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 DeepSeek V4 Flash의 속도 향상과 지시 이해도 개선을 경험하며, 이를 가벼운 작업용 에이전트에 활용할 가능성을 확인하셨습니다. 특히 OMO 개발자가 모델별로 역할을 분담시킨 설정과 본인의 기존 하네스인 CoffeeMix를 비판적으로 재검토하여 해체하는 과정은 개인의 운용 기록으로서 의미가 큽니다. 다만, 이러한 성능 향상과 작업 수행 능력은 Serio님의 개별 실험 결과이므로, 모든 환경에서 동일하게 재현될지는 확인이 필요합니다.

후속 기록에서는 DeepSeek V4 Pro 0813에 대한 아쉬움도 나타납니다. 확인한 공식 자료는 Flash 0731 모델 카드이므로 두 버전을 한 평가로 뭉뚱그릴 수는 없습니다. 이 묶음은 특정 모델의 우승 선언보다, 새 모델을 써 본 뒤 기존 CoffeeMix 구성을 다시 판단하게 된 과정에 가치가 있습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

DeepSeek

DeepSeek V4 Flash 0731 model card

공개된 0731 모델 카드와 버전을 확인했다. 실제 작업 속도와 CoffeeMix 해체 결과는 작성자의 실험이다. Pro 0813과 Flash 0731을 같은 모델로 표현하지 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Codex 속도와 사용량, 리셋 가격에 대한 사용 기록

24개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
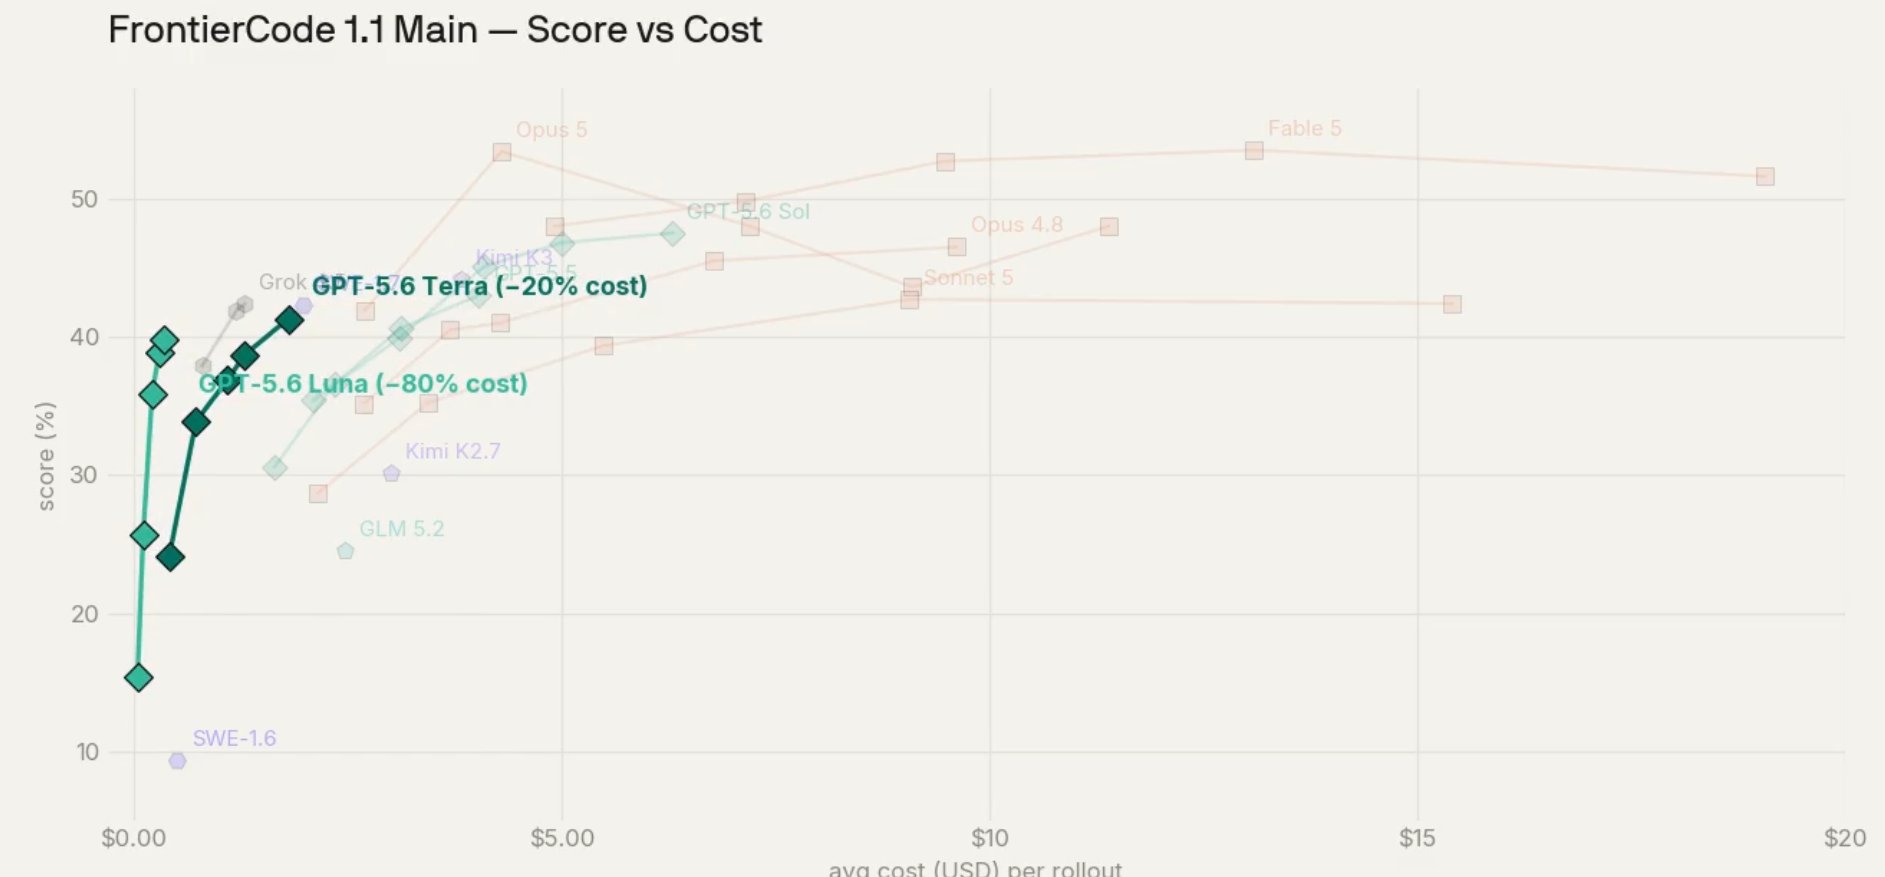
    1. 루나가 진짜 공격적 가격. 루나맥스! 루나맥스!
    2. 테라는 20% 내려도 그닥 매력적이지 못함. 테라맥스 빼면.
    3. 솔은 하이 혹은 Xhigh 부터 의미가 생김. 솔미디엄의 퇴장.

    고난도 작업 : 솔 하이- 엑스하이 단순작업 : 루나맥스 중간 어딘가 : 테라맥스

    가격 변동으로 사용 에포트가 고정됨. https://t.co/4Rd05PgJa0

    Codex 속도와 사용량, 리셋 가격에 대한 사용 기록 — X 원문 첨부

    인용 문맥: @cognition의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2
    Gpt 5.6 의 문제는 느리다는거. 특히 Sol 은 끔찍히 느림. 그래서 다들 세레브레스 가속 버전을 기다렸지만, 극히 일부한테만 적용이 된 듯. 딥시크가0731이 대부분의 api 제공자들에게서 60~100tok/s를 보이는 지금 당장엔 엔트로픽이 사용자를 대거 뺏기겠지만 장기적으론 GPT도 문제가 될 것이다.
    원문 보기
  3. 3
    /fast 모드의 존재는 답이 안 됨. Sol에선 비용이 왜나 들어감. 프로 플랜 사용자들을 제외하면 의미가 없음. 솔/테라/루나도 기본 작동 속도가 최소 지금의 2배는 되어야 한다. 그래야 유의미한 작업 속도가 나올 수 있음.
    원문 보기
  4. 4

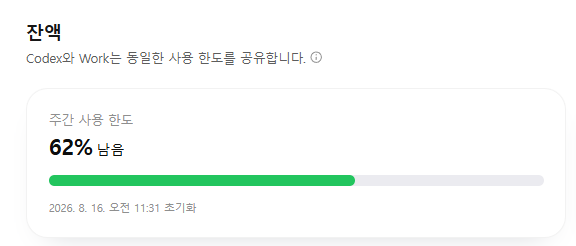
    일단 반나절에 40% 10% 쓰고 답답해서 /fast 적용.

    확실히 Sol 까지는 어떻게든 저떻게든 사용량 관리가 될 거 같은데 Sol Fast 는 정말 토큰 할당 줄어드는게 쭉쭉 눈에 보이네요. https://t.co/Vh0sMiPnEv

    Codex 속도와 사용량, 리셋 가격에 대한 사용 기록 — X 원문 첨부
    원문 보기
  5. 5

    사실 Sol Xhigh 5~6세션으로 반나절 돌리면 이 정도 토큰 소비가 나옴. 여기에서 루나 혹은 추가 결제한 딥시크 토큰을 덧붙이면 일 15% 수준으로 소비를 억제시킬 수 있음.

    그러니 앞으로 임의 리셋 하지 말고 리셋 쿠폰을! 뱅크드리셋은 잊어버리라고 만들어달라 한 게 아닙니다. @thsottiaux https://t.co/KLIe20CTXq

    Codex 속도와 사용량, 리셋 가격에 대한 사용 기록 — X 원문 첨부
    원문 보기
  6. 6

    리셋쿠폰 가격은 주간 사용 비용을 넘으면 안 됨. 200달러 플랜이면 쿠폰은 50달러 이하여야 함. Tibo리셋이 돌발적으로 오면 돈 쓰고 손해 볼 수 있음.

    차라리 주간 이용제한(1회)을 두고, 계정 요금의 1/5 ~ 1/10 가격으로 월 2장 정도를 구매할 수 있게 하는 게 적절함. @thsottiaux @OpenAIDevs

    원문 보기
  7. 7
    지금의 뱅크드리셋 쿠폰 요금체계의 전면 재검도 필요성이 있음. 또한 저렴한 요금제의 뱅크드리셋 가격은 비싸게 하여 차라리 플랜 업그레이드를 유도하는 한편 비싼 요금제는 상대적으로 저렴하게 해 비싼 요금제 유지의 정당성을 불어넣어 주는 게 맞음.
    원문 보기
  8. 8

    이러한 부분과금에 가장 돌아있는 게 한국의 온라인 게임이니 티보와 코덱스팀은 한국 온라인 게임 BM 을 참고하면 좋을 것.

    … 아?

    원문 보기
  9. 9
    @ramztd 부분유료과금의 시작이겠죠 :)
    원문 보기
  10. 10

    @_nodelay 게임을 사는 게임 스팀! 토큰을 쓰는 게임 Codex!

    지금 시작합니다! 레쯔고!

    원문 보기
  11. 11
    @desperatereleas 그러다가 또 좀 이슈가 있으면 해주고 그러겠죠. 전 아직까진 Luna 때문에라도 Gpt 쓸 거 같네요.
    원문 보기
  12. 12원문 보기
  13. 13

    1과 2가 상호 모순됨.

    배려해줘야 할 정도로 Plus 의 Codex 한도는 작은데, 그걸 몰아서 쓴다고 트래픽 부하가 왜 생김? 사실 부하를 많이 가져오는건 상위 플랜 사용자 아닌지?

    걍 부연설명 하지 말고, 한도 제한 없이 쓰려면 Pro플랜을 돈 더 주고 써라 하는 편이 깔끔했음. 불필요한 TMI.

    인용 문맥: @thsottiaux의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  14. 14
    @tinypia 크흠 흠 다 잘되라고 어험 어험
    원문 보기
  15. 15원문 보기
  16. 16

    @sijeosaell72904 물론 Pro / Pro X20 사용자가 적은건 맞습니다. 한국도 만명 될까 말까 하다더군요. 다만, Pro X20이 평균 한도가 Sol 만 사용해도 주당 20억토큰 정도 되는 걸 생각해보면 헤비사용자가 트래픽을 더 발생시키지 싶습니다.

    (그리고 Pro로 한도 끝까지 써보지도 않았으면서도 전문가 타령하는건 좀…)

    원문 보기
  17. 17

    @StarLibra07 그래도 luna 는 현존 가장 가성비 좋은 모델이니, 업무에 Ai 많이 쓰시면 Gpt plus 정도는 유지해도 좋지 않을까 싶었는데

    이번에 이렇게 또 너프를 ㅋ

    원문 보기
  18. 18
    @rlaskdms1115 사실 Sub2api 로 여러 계정 묶어서 서비스하려면 Plus 의 계정 다발이 Pro 보다 제공 총량이 많아서 유리하다고 판단할 수 있을 거 같네요.
    원문 보기
  19. 19
    @agurrrrrrrrr 앗 일론이 내 프로젝트를 들여다보고있어요! 엣찌! 다메!
    원문 보기
  20. 20
    @desperatereleas 사실 플러스 구독자들도 대부분 앱을 쓰죠. 코덱스가 뭔지 모르는 사람들도 아직 대부분…
    원문 보기
  21. 21
    @devjw_ 그래도 클로드보단 나은거 같아요 ㅡㅡㅋ
    원문 보기
  22. 22
    @mustsupport 그럼 플러스 수준의 라이트유저들은 땡큐긴 한데요 ㅡㅡㅋ
    원문 보기
  23. 23
    @mustsupport @agurrrrrrrrr 일론 & 커서팀 : 😋😋😋😋😋😋😋
    원문 보기
  24. 24
    @palin1838982 /goal과 함께라면!
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Codex의 모델별 비용 효율성과 속도, 그리고 토큰 소모량에 따른 사용 패턴을 기록하셨습니다. Luna는 가성비가 뛰어나 단순 작업에 적합하지만, Sol은 고난도 작업에 쓰임에도 불구하고 속도가 매우 느려 실질적인 작업 효율이 떨어진다는 점을 지적하셨습니다. 다만, 구체적인 토큰 소모량이나 모델별 속도 수치는 개인의 사용 환경에 따른 경험적 기록이므로, 공식적인 벤치마크 자료와 일치하는지는 확인이 필요합니다.

리셋 쿠폰의 가격 체계와 요금제별 한도에 대한 Serio님의 제안은 사용자 입장에서의 실질적인 비용 부담을 분석한 결과입니다. 특히 고액 요금제 사용자가 더 많은 트래픽을 유발한다는 추정이나, 한국 온라인 게임의 과금 모델을 참고하라는 의견은 논리적이지만 공식적인 내부 데이터로 검증된 주장은 아닙니다. 그럼에도 이러한 시행착오와 운용 기록은 실제 헤비 유저가 겪는 제약과 비용 효율의 접점을 찾는 데 유의미한 지표가 됩니다.

원문 기록맥락과 해석