Serio의 X 스레드
Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래
- 1원문 보기
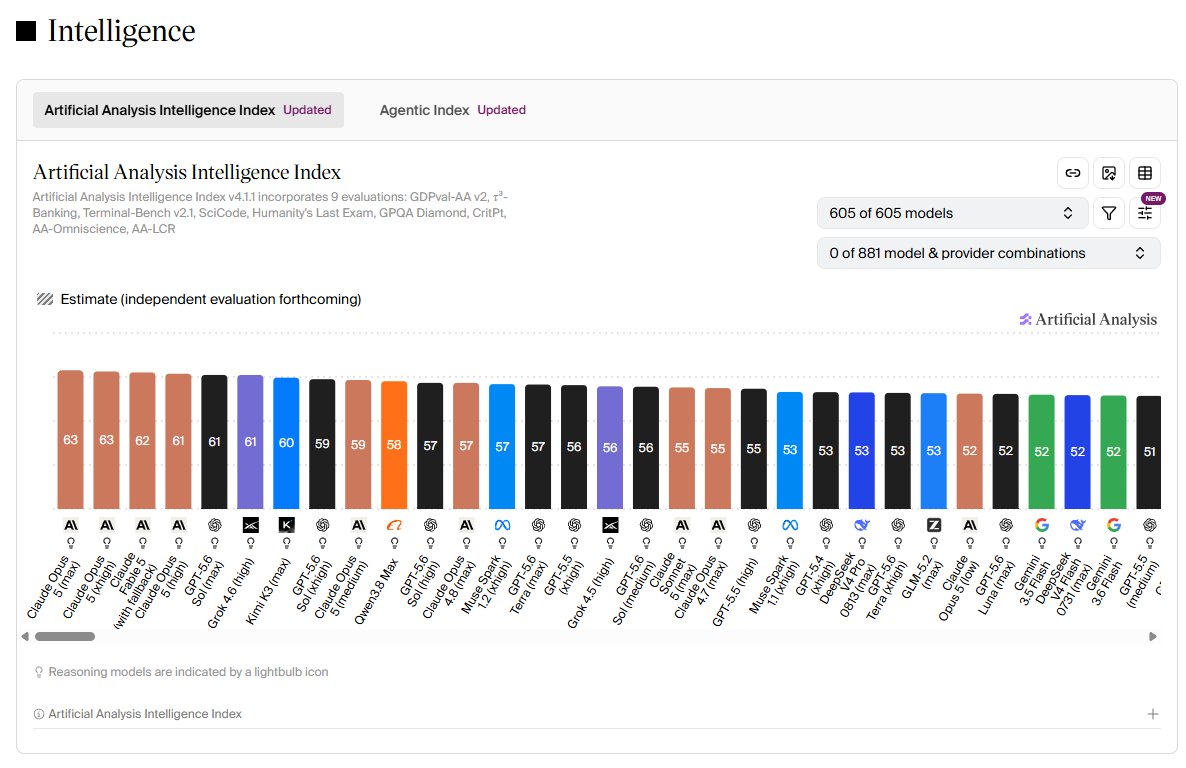
이제 벤치마크를 바꿔야 함. 모델이 가진 정보의 양은 기하급수적으로 늘었고 배경 지식이 늘어난 모델이 수행할 수 있는 일들 또한 빠르게 늘어났는데도 우리는 1~2년 전에 만들어진 기준으로 모델의 ‘지능’만을 바라보고 있음.
그럼 모델의 능력을 높이기보단, 치팅의 유혹에 더 쉽게 빠지게 됨. https://t.co/DWqUECuX3g
- 2원문 보기
Gemin 3.1 Pro 이후의 구글 모델들처럼 보여지는 수치와 모델의 실제 수행 역량이 맞지 않는 모델이 있다는 것을 알 수 있음.
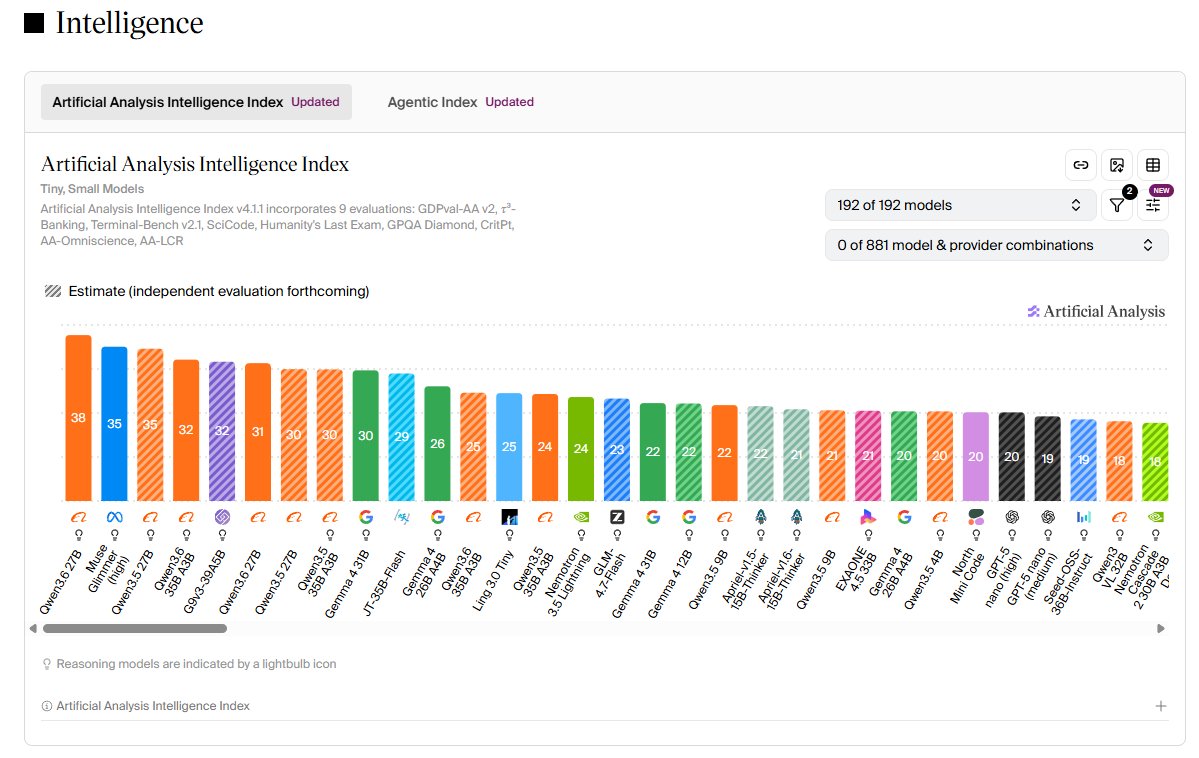
마찬가지로, 파라메터가 지나치게 적음에도 불구하고 순위가 높은 모델들도 있음. 이런 모델들은 순간적으론 작업을 잘 하는 것처럼 보이지만 금새 한계를 드러냄. https://t.co/pzj6AxyS7h
- 3원문 보기
가격이 신호등의 역할을 하지 못하면 시장실패가 나타나듯, 벤치가 제 역할을 다 하지 못하면 결국 유저가 경험을 통해 찾아낼 수 밖에 없고 한정된 자원 - 시간과 컴퓨터 - 을 소비하게 만듬.
극단적으로, 모델들을 체크하고 실력을 검증하는 별도의 모델을 만들어야 할 시기가 왔는지도 모름.
- 4지금대로 두면 깊이 있는 사고를 하는 빅파라메터 모델은 경시되고, 적은 자원을 들여서 하지만 빨랏죠를 실현하는 로우파라메터 모델 중심으로 시장이 재편될 것임. 지금은 투 트랙으로 가야 모두가 만족할 수 있는데 한쪽만 커지면 결국 문제가 생길 수 밖에 없음.원문 보기
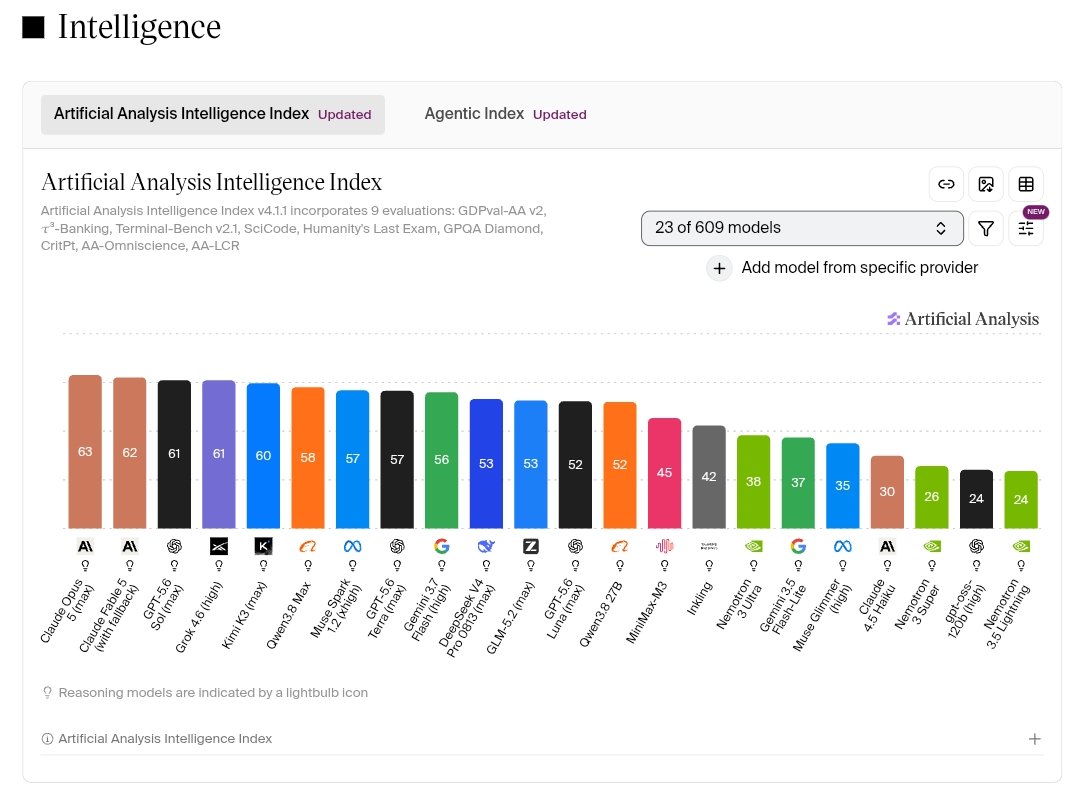
- 5Artificial Analysis 벤치점수 꽤 높겠다 생각했는데 52 를 주네 https://t.co/9AskjorA6L원문 보기
- 6원문 보기
점수가 좀 과함.
아무리 생각해도 루나랑 동급의 모델은 아님. 루나는 일을 맏길 수 있지만 이 모델은 결과는 가져올 수 있을지언정 일을 맡길 수 있는 모델은 아니라는 생각. 하네스를 안씌우면 재미있지만 씌우면 바로 따분한 모델 되버림.
AA는 종합 지능 벤치마크 기준을 재점검할 필요가 있음.
- 7@yulmu_coffee 사실 모델이 크긴 하죠. 27B dense 라서…원문 보기
- 8@ixxelent9052 전 토큰만 좀 더 잘나오고 과추론 잡히면 50정도는 줄 거 같아요.원문 보기
- 9원문 보기
벤치마크를 마치 개인의 주관이 섞인 정성평가 취급 하는 사람들이 꽤 보이는데, 적잖이 우려스러움.
그건 단순히 점수가 아니고 SC에 과학적 방법론이 적용된 결과임. 평가지표를 만든 뒤 귀납적 반복 테스트를 통해 효과성을 입증한 후 그걸 컴퓨터 능력을 평가하는 요소로 사용하는 것임.
- 10원문 보기
만약 벤치마크와 내 경험이 일치하지 않는다면 자신을 되돌아보는 메타인지적 접근이 우선될 것임. 그리고 반복적인 관측과 추가 가설 수립 및 증거 확보를 통해 자신의 판단을 확신할 수 있게 되면 그걸 바탕으로 새로운 실험을 진행하면 되는 것임.
그게 과학적 방법론이고 연역과 귀납의 발현임.
- 11@ramztd 람썬님은 글의 맥락을 읽고 시류에 맞게 응용해 적용하는 능력이 탁월하심 ㅋ원문 보기
- 12원문 보기
@Hyun_The_Wise 벤치가 틀렸어! 오염됬어! 맥싱이야!
가 아니라 음… 내가 틀렸나? 부터 해야죠. 그래서 사용자 경험의 공유도 매우 중요하죠.
- 13@byeolbyeol_e Ang!원문 보기
- 14@jeongjiwon19511 순서가 바뀌지만 않으면 구성요소들의 상호작용이 좋을 결과를 만들어 주는 기초가 되겠죠.원문 보기
문향의 생각
안녕하세요. 문향입니다.
Serio님은 벤치마크 점수가 실제 사용 경험과 괴리되는 현상을 지적하며, 구식 기준의 지표가 모델의 실질적 지능을 반영하지 못해 시장의 왜곡을 초래할 수 있다고 주장합니다. 특히 Artificial Analysis의 지표가 특정 모델의 수행 역량과 맞지 않는다는 개인적 경험을 언급하셨는데, 이는 공식 자료에서 지능 지표가 여러 평가의 조합일 뿐 모든 실무 능력을 대표하지 않는다는 점과 일치합니다. 다만, 모델의 파라미터 규모와 성능의 상관관계나 특정 모델의 치팅 가능성에 대한 언급은 구체적인 증거가 제시되지 않은 경험적 판단이므로 추가 확인이 필요합니다.
이후 Serio님은 벤치마크를 단순한 정성 평가로 치부하는 태도를 경계하며, 지표와 경험이 충돌할 때 사용자 스스로의 판단 기준을 먼저 점검하는 과학적 방법론의 중요성을 강조합니다. 벤치마크는 과학적 방법론이 적용된 결과물이기에, 무조건적인 불신보다는 반복적인 관측과 가설 수립을 통해 자신의 경험을 객관화하는 과정이 선행되어야 한다는 논지입니다. 이러한 관점은 기술적 지표와 실제 운용 경험 사이의 간극을 메우기 위해 사용자가 가져야 할 메타인지적 접근법을 잘 보여줍니다.
팩트 체크 & 근거 자료
Serio / X
Serio 원문
작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.
X 원문benchmark
공식 문서 및 제작자 자료
Artificial Analysis는 지능 지표를 여러 평가의 조합으로 설명하며 언어·입력 형태별 별도 평가 범위를 밝힌다. 모든 실무 능력이나 사용자의 디자인 선호를 대표하지 않는다.
primary-source