THREAD ESSAYX THREAD ARCHIVE

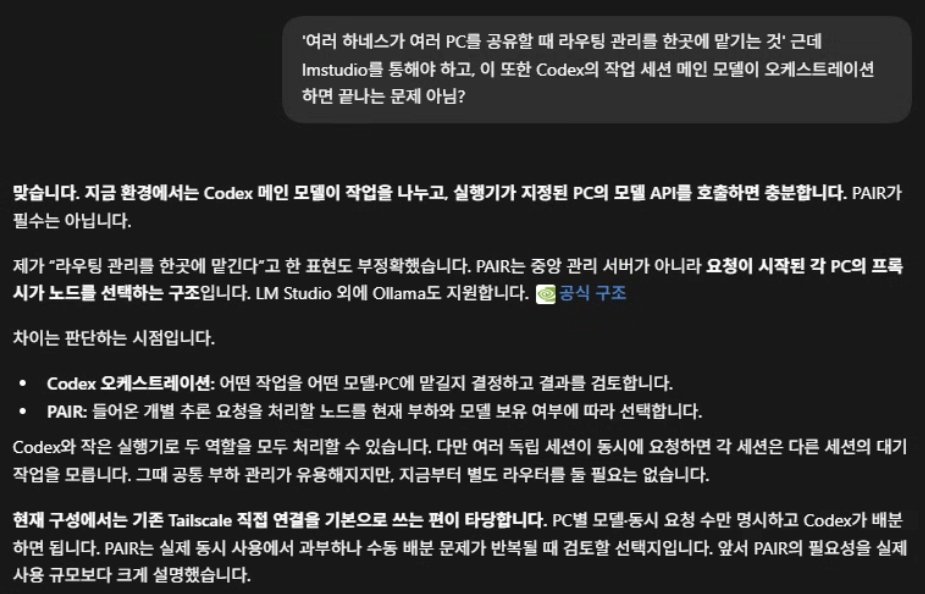
NVIDIA PAIR를 써 본 Tailscale 사용자의 평가

4개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Nvidia pair 사용후기.

    “쓰지마세요.”

    Talescale 로 네트워크의 Ai 머신들을 하네스 직결한 다음에 메인 모델한테 라우팅/호출 해달라는게 더 빠르고 손쉬움.

    즉 스킬 하나로 될걸 위해서 별도의 프로그램을 따로 설치할 필요가 없습니다. 특히 테일스케일 유저들은 의미가 1도 없음. https://t.co/gI7sLZcbrG

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2

    이런 수작을 마치 대단한 기능처럼 포장해서 발표하다니 정말 기가 차다 기가 차.

    마케팅의 달인이라고 불러 드립니다.

    박수 세 번 짝 짝 짝. https://t.co/skj8dfhURp
    NVIDIA PAIR를 써 본 Tailscale 사용자의 평가 — X 원문 첨부
    원문 보기
  3. 3
    선발대가 이미 다녀갔으니 시간 낭비 하지 마시고 Tailscale 설치한 뒤에 사용하시는 하네스의 모델에게 하네스에 테일넷 서빙 모델 Api 설치한 뒤에 사용할 수 있게 작업해 달라고 하세요. https://t.co/ErYrUkkUA0 NVIDIA PAIR를 써 본 Tailscale 사용자의 평가 — X 원문 첨부
    원문 보기
  4. 4

    @code_n_money 테일스케일 자체가 거의 페어를 대응하는데 그럼 이후는 빠른 에이전트 라우팅과 결과의 결합인데 그걸 빼놓고 ollama, lmstudio 를 얕은 수준의 하네스로 사용하고 있으면

    결국 Nvidia pair는 외부 연결 안되는 테일스케일이잖아요?

    ㅋ
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 NVIDIA PAIR가 제공하는 여러 시스템의 로컬 추론 연결 기능이 이미 Tailscale을 통해 구현 가능한 영역이라며, 기존 사용자에게는 중복된 도구일 뿐이라고 평가하셨습니다. 공식 문서에 따르면 NVIDIA PAIR는 Ollama나 LM Studio 같은 도구와 연동하여 단일 엔드포인트로 통합 관리하는 기능을 제공하므로, 네트워크 연결성 측면에서 Serio님이 느끼신 중복성은 타당한 경험적 근거를 가집니다. 다만, 제품 전체의 기능적 동등성이나 보안 수준이 Tailscale과 완전히 일치한다는 점은 공식 자료만으로는 확인이 어려우므로 추가 검증이 필요합니다.

PAIR의 공식 설명에는 여러 추론 서버를 하나의 엔드포인트로 연결하고 요청을 분배하는 기능도 포함됩니다. 따라서 네트워크 연결 도구인 Tailscale과 제품 전체가 동일하다고 볼 수는 없습니다. 이미 비슷한 환경을 직접 구성한 Serio님에게 추가 이점이 작았다는 평가와, 구성을 시작하는 사용자에게 편의가 있을 수 있다는 가능성을 함께 구분해 읽을 수 있겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

pair

공식 문서 및 제작자 자료

NVIDIA PAIR 공식 페이지는 여러 시스템의 로컬 추론을 연결하고 Ollama·LM Studio와 단일 엔드포인트로 연동하는 기능을 설명한다. Tailscale과 제품 전체가 동등하다는 뜻은 아니다.

primary-source
THREAD ESSAYX THREAD ARCHIVE

Astra 사용 이틀과 로그라이크 플레이 테스트

14개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    5.6 Sol 이면 Diff를 무한정 늘려가면서 작업을 수행 또 수행하는 방망이 깎기를 시전할텐데, Astra는 적절한 수준에서 딱 멈춰서 다음 작업 지시를 기다리고 있으니 Sol을 쓰던 감각으로는 ‘뭐야 벌써 끝났어?’ 라고 의심의 눈초리로 바라보게 됨.

    결과물은 Sol보다 확실히 좋게 나오는 거 같은데…

    원문 보기
  2. 2
    @kyunia28 반대로 ‘뭐야 벌써됬어? 야 정말?’ 의 1차적 불신을 거둘수가 ㅋㅋㅋ
    원문 보기
  3. 3
    @gmpnavi 그런 부분에서 확실히 성능이 좋아진게 느껴지네요
    원문 보기
  4. 4
    @Kataru864764 확실히 걸리는 시간이 줄어드니 쾌적해요
    원문 보기
  5. 5

    아스트라 붙잡고 2일 작업해 봤는데 수준은 확실히 기존 GPT와 다른 수준으로 올라갔는데 AGI라 부를 수준인지는 모르겠는데…

    Sol이 diff 깎는 노인이라면, 아스트라는 유능한데 쉽게 지치는 멘헤라 Mz. 빠르게 일을 처리하지만 조금 산만하고 다 해결 안하고 중간에 내려놓고 쉬는 경우가 많음.

    원문 보기
  6. 6

    마이크로 메니징으로 목표 도달을 하게끔 하는 스타일에는 잘 맞지만, 프롬 하나 주고 싱글턴으로 알잘딱깔센을 기대하면 잘 만들어 오는데 어딘가 나사가 하나정도는 풀린 결과를 들고 온다. 사전에 기획을 잘 만들어 줘도 추가로 티키타카를 좀 해 줘야 함.

    그래도 능력이 많이 좋아진 건 맞음.

    원문 보기
  7. 7

    Plugin, 스킬 다이어트를 위해 자체 하네스 만들어 둔 거 있으면 좀 끄는 걸 추천. 저도 이래저래 비교해 본 뒤 Superpower 비활성화 함.

    아니면 다른 잘한다는 외부 하네스 (오마이파이, 헤르메스 등)에 연결해서 결과를 비교해 보면서 작업마다 하네스를 다르게 쓰는 것도 방법일 수 있겠음.

    원문 보기
  8. 8
    @jukan05 적절해요? ㅋㅋㅋ
    원문 보기
  9. 9

    @jukan05 맨헤라 Mz 신입한테는 인간 부장님의 적절한 드리블이 필요하다~

    반대로 티키타카 하면서 결과물 완성해 나가는 재미가 손맛이 좋은 모델이네요.

    원문 보기
  10. 10
    @dambyworld 로로님처럼 매의 눈으로 지켜보면 아스트라가 딴청 부리는 일은 없을 것 ㅋ
    원문 보기
  11. 11
    @byeolbyeol_e 컴퓨터 유징 능력은 진짜 만점맞을 만 하네요 ㅋㅋㅋㅋㅋ
    원문 보기
  12. 12

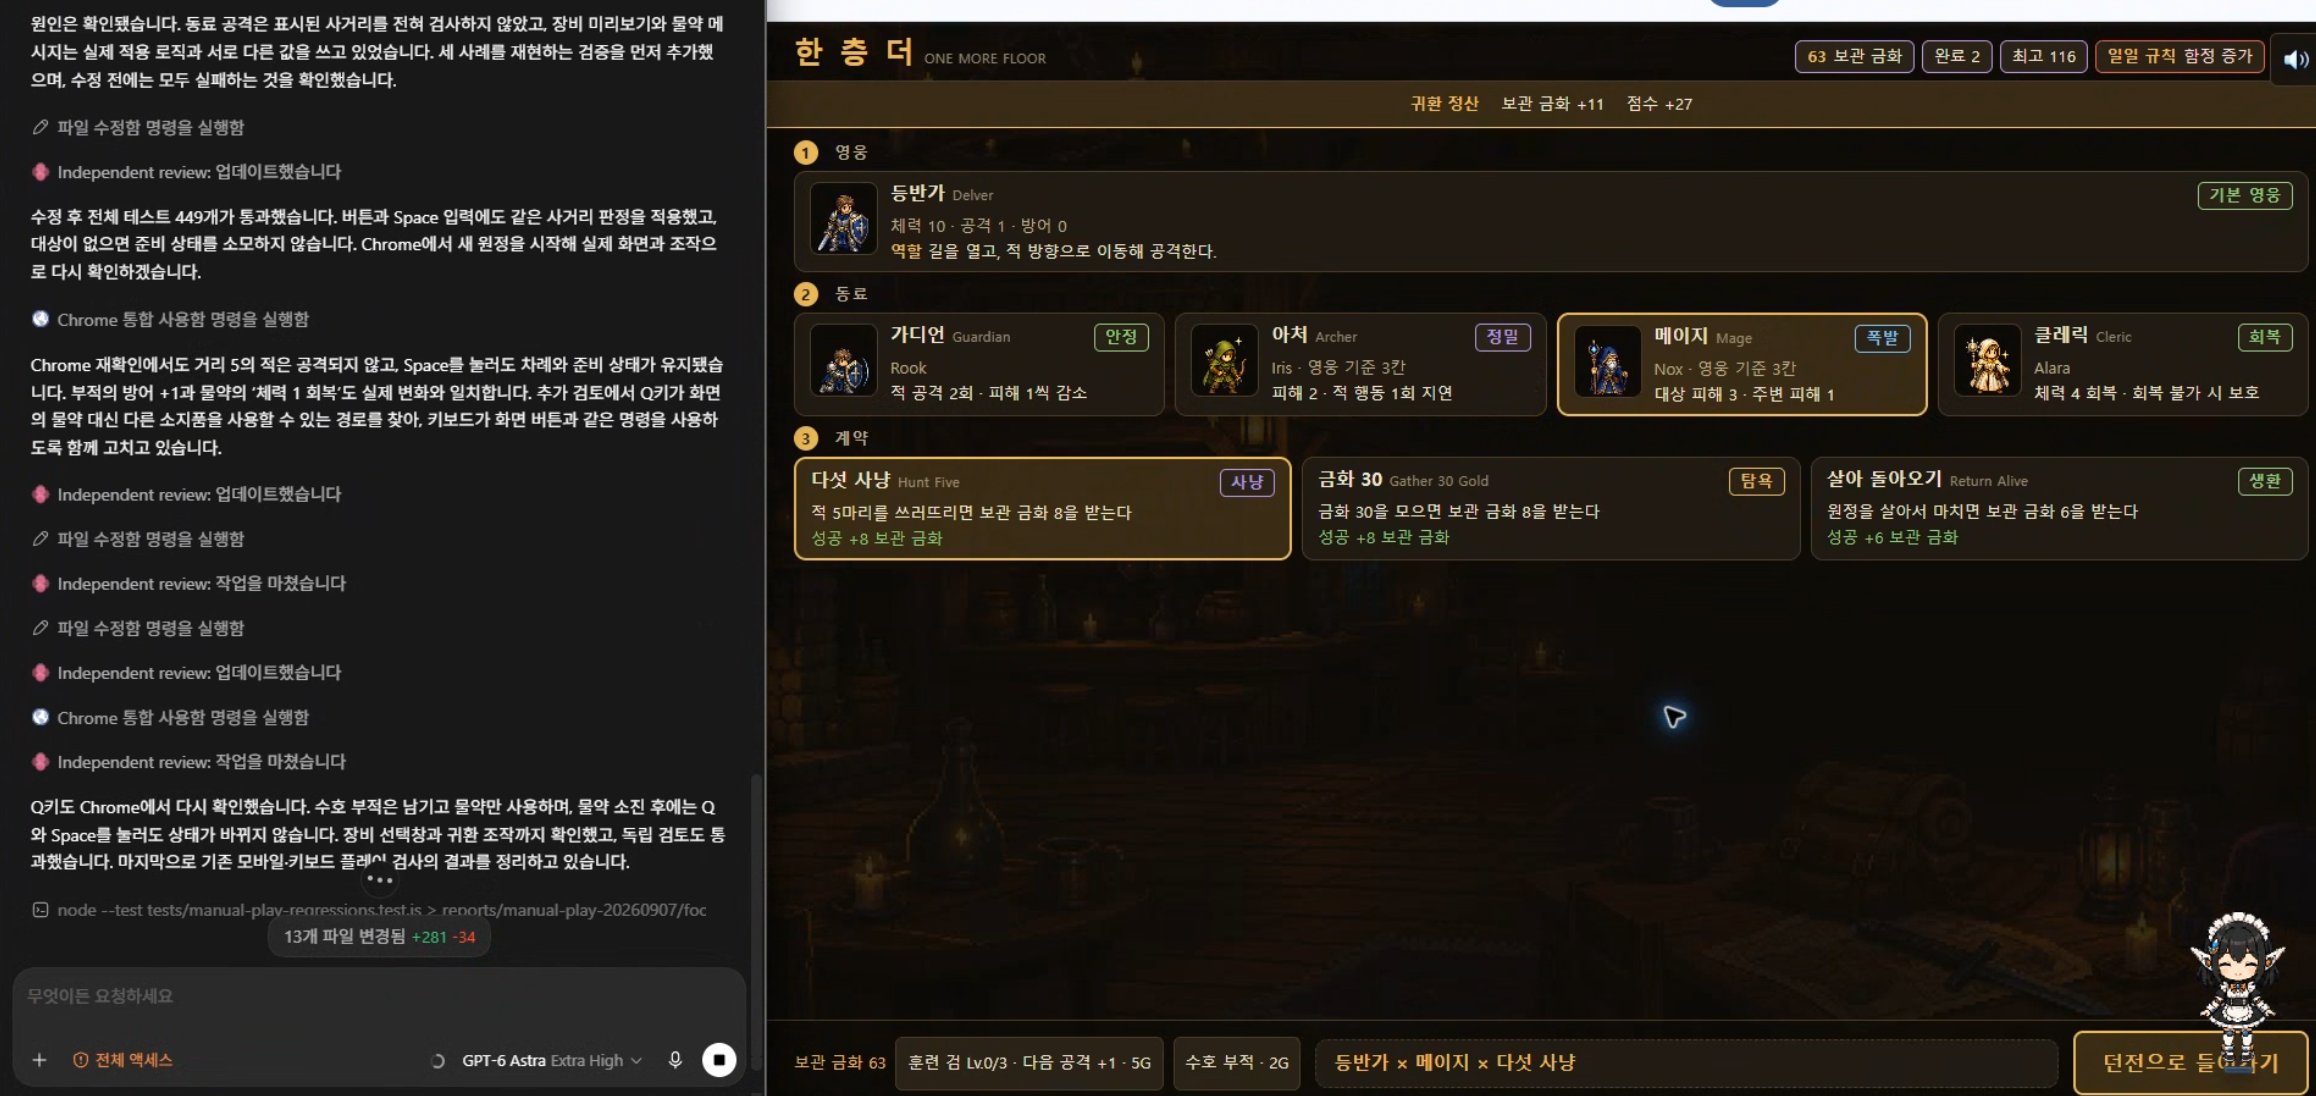
    던전크롤형 로그라이크의 Atsra E2e play test. (Gpt 5.2 부터 조금씩 제작 중)

    몹이 안보여서 드러나게 해라 했더니 전장의 안개까지 걷어버림 ㅋ 일일히 다 잡고 탐험하지 않고 가장 효율적인 길만 선택해 5층 중간보스 위치까지 도달.

    이전엔 게임 같지도 않았는데 조금 게임 같아졌네요. https://t.co/iJJLLgH9oM

    원문 보기
  13. 13
    열심히 플레이하면서 버그를 찾아다니는 모습. https://t.co/9L2OTVoONf Astra 사용 이틀과 로그라이크 플레이 테스트 — X 원문 첨부
    원문 보기
  14. 14
    @byeolbyeol_e ㅋㅋㅋㅋㅋㅋ 저도 봤어요 ㅋㅋㅋㅋㅋㅋㅋㅋ
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Astra를 이틀간 사용하며 이전 모델인 Sol보다 작업 속도가 빠르고 결과물의 품질이 향상되었음을 경험했습니다. 다만, 단일 지시만으로는 세부 사항을 놓치는 경우가 있어 세밀한 관리와 지속적인 상호작용이 필요하다는 점을 지적하셨습니다. 특히 로그라이크 게임 테스트에서 요구 사항을 과하게 해석하여 전장의 안개를 제거한 사례는 모델의 판단 기준이 여전히 불완전함을 보여주는 구체적인 경험 기록입니다.

전장의 안개를 없애 버린 사례에서는 테스트를 통과하는 일과 게임의 의도를 지키는 일이 갈렸습니다. 빠르게 작업하는 능력이 좋아져도 무엇을 보존해야 하는지 판단하는 검토는 남는다는 뜻이지요. 이틀의 체감을 보편적인 성능 순위로 확대하기보다는, 맡길 수 있는 범위와 계속 살펴볼 부분을 찾아가는 기록으로 읽는 편이 좋겠습니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

2025년에서 2026년으로: 모델과 하네스를 바라보는 관점

8개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    2025년

    1. 2025년은 모델 기본 능력이 문제였음.
    2. 모델의 코딩 능력을 제품에 연결하는 IDE가 등장.
    3. 모델에게 직접 작업을 시키는 mcp, skill 등이 등장하면서, 하네스가 조금씩 중요해졌음.
    4. claude.md. agent.md, gemini.md 같은 작업 규약(헌법)이 등장.
    원문 보기
  2. 2

    2026년

    1. 2026년 초 오픈클로/클로드코드 등장으로 에이전틱 워크가 보편화되면서 하네스의 중요성이 커짐.
    2. 앞다퉈 하네스 엔지니어링을 함.
    3. 모델의 하네스를 흡수하기 시작.
    4. 연말에 가까워지면서, 모델의 역량을 다 발휘할 수 있도록 하는 하네스 최적화가 중요해지기 시작함. (지금 여기)
    원문 보기
  3. 3

    앞으로 예상 (이미 그렇게 된 부분도 많음)

    • 토큰을 기준으로 한 ROI 보편화.
    • 모델 파라메터 증가폭은 감소, 모델 작동의 효율성은 증가.
    • 모델 자체의 능력은 더 강화되지만, 외부 하네스는 경량화.
    • 보편적 하네스가 퇴색되고, 개별 모델에 최적화된 맞춤형 하네스 엔지니어링이 늘어날 것.
    원문 보기
  4. 4

    이미 기술의 첨단에 계신 분들은 대충 감 잡고 계신 부분일 테지만, 한번 정리해 보면 어떨까 싶어서 간략하게 다듬어 봤습니다.

    놓친 부분 있으면 알려주세요.

    원문 보기
  5. 5
    @winterrain_lee 작은 나만의 하네스를 만들다 보면 그게 커지고 그렇죠 ㅡㅡㅋ
    원문 보기
  6. 6
    @aguming_ 계속 확산되는 추세인 거 같네요.
    원문 보기
  7. 7
    @mogimogi098 아마 각 모델 프론티어들이 스스로 자기 모델에 맞는 하네스를 만들 것이라 (그게 자기 모델 홍보도 되니) 크게 걱정 안 하셔도 ㅋ
    원문 보기
  8. 8
    @wadeudeug5449 이제 계속 확장 융합을 지속해 나가겠죠.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 2025년부터 2026년까지 인공지능 모델의 기본 능력과 이를 제어하는 하네스의 관계 변화를 연표 형식으로 정리하셨습니다. 모델의 코딩 능력이 제품에 연결되는 과정과 작업 규약의 등장, 그리고 에이전틱 워크의 보편화로 인해 하네스 엔지니어링의 중요성이 커졌다는 분석은 기술 운용의 흐름을 잘 보여주는 경험 기록입니다. 다만, Claude Code와 같은 특정 제품의 보편화 시점이나 하네스 최적화의 중요성 변화는 개인의 체감 시점과 공식 출시 일정 사이에 간극이 있을 수 있으므로 정밀한 확인이 필요합니다.

이 연표는 공식 출시 일정을 총정리한 자료가 아니라 Serio님의 도구 사용 관점이 바뀐 기록입니다. 앞으로 하네스가 가벼워질 것이라는 전망도 확정된 미래와는 구분해야 합니다. 같은 지침을 계속 쌓기보다 모델이 스스로 해내는 범위가 달라졌는지 돌아보자는 질문은 앞선 실험들과 연결됩니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

개발자의 문제해결 경험은 어디까지 전이될까

8개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    IT개발자 직군이 다른 직군보다 한 가지 부분에선 확실히 앞선 부분이 있음.

    ‘문제해결력’

    추상적인 요구, 구현, 많은 버그와 문제상황들을 해결해 나가는 과정은 반복적 문제 해결의 경험을 제공함.

    이제 이 능력을 어디까지 전이하느냐갸 직군의 미래를 좌우하지 않을까.

    원문 보기
  2. 2
    @dambyworld 의사도 개발자도 본질적인 부분은 엔지니어링인지라 ㅡㅡㅋ
    원문 보기
  3. 3

    @ramztd 그건 삶에 있어서 대부분 필요한 것이지만, 개발자들은 직업 수행 과정에서 반복, 압축적으로 수행하다 보니 해당 직능을 확장할 수 있는 경험적 깊이가 깊지 않나

    라고 생각합니다 ㅡㅡㅋ

    원문 보기
  4. 4

    요기에 ‘응 그건 개발자인 네 착각!’ 이라는 알티가 좀 달리는데

    제가 Ai를 쓰면서 IT 개발자 분들을 밖에서 관찰하는 타 직군이다 보니(개발자랑은 이억만년정도 떨어져 있는)

    객관적 시선으로 보고 문제해결력이 평균적으로 우수하시다 적어놓은 거라 이 부분에선 자존감을 좀 가지셔도 됩니다.

    원문 보기
  5. 5

    학문적 영역에서의 문제해결력은 다음 세 가지가 핵심이 됨.

    1. 문제에 대한 인식
    2. 합리적, 비판적 사고
    3. 대안 도출

    잦은 트러블 슈팅, 추상적 요구에 대한 구체화 등은 이러한 사고과정을 반복적으로 촉발하여 문제해결역량을 키울 수 있는 토대가 됨.

    인용 문맥: @Multi_Serio_Ai의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  6. 6

    반성적 사고에 기초한 문제해결 과정은 다음과 같은 순서를 가짐.

    문제 확인 > 원인 분석 > 대안 탐색>대안 평가>실천 및 평가

    생각보다 이게 잘 이루어지는 사람/조직은 드뭄. 대부분의 조직 특히 한국은 여전히 ‘부속은 생각하지 마’에 같혀 있는 곳이 많음.

    좋은 건 좋다고 보는 태도도 필요함.

    원문 보기
  7. 7

    @economakase 기술적 용어로 바꾸면 그렇게 될까요?

    원 글의 소재가 자극적이었을까요. 뷰잉이 늘어나니 또 산을 바라보는 댓/알티가 늘어나서 추가설명을 하게 되네요.

    설명에 대한 설명은 실패한 설명인데 ㅋㅋ

    원문 보기
  8. 8
    @tinypia 능력자는 어디에나 있는 법이죠.
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 개발자 직군이 겪는 반복적인 트러블 슈팅과 추상적 요구의 구체화 과정이 문제해결력을 압축적으로 성장시킨다고 주장합니다. 특히 문제 인식, 합리적 사고, 대안 도출이라는 학문적 핵심 요소와 반성적 사고의 단계적 절차를 제시하며, 이러한 역량이 다른 영역으로 전이될 때 개발자의 미래가 결정될 것이라는 견해를 밝히셨습니다. 다만, 특정 직군이 타 직군보다 문제해결력이 평균적으로 우수하다는 주장은 객관적인 통계나 표본 연구로 입증된 사실이 아니기에 추가적인 확인이 필요합니다.

직무에서 익힌 사고가 다른 영역으로 저절로 옮겨 가는 것은 아니라는 질문이 중요합니다. 반복해서 문제를 푸는 경험과 그 방법을 돌아보고 설명하는 능력을 구분해야 하겠지요. 특정 직군의 우월함을 선언하기보다, 자신이 익힌 해결 방식을 낯선 문제에도 적용할 수 있는지를 묻는 글로 읽었습니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

모델 비교에서 과제 선택이 중요한 이유

5개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    의미없음.

    Sol이 가장 못하는 부분이랑 Fable을 비교하면 되나. 그럼 반대로 코드 완성도나 적합성 CI랑 비교하면 6배 디테일이 나옴?

    동일 프롬프트로 kimi3, Qwen 3.8 이랑 비교해보던가. 바로 페이블의 ‘별 차이 없는데 가격만 압도적으로 비싼’결과가 들어날텐데.

    인용 문맥: @aimlapi의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2

    @dambyworld 사실 추상적 개념의 시각화야말로 Gpt 가 가장 못하는 부분이라서 ㅋㅋㅋ (비전도 달고 있으면서 이상하게 못해요) 이해는 하는데 그걸 가지고

    페이블이 6배 더 나아!

    라는건 그저 바보가 바보임을 간증하는거 밖에 안되죠.

    원문 보기
  3. 3
    @dambyworld 갈수록 표독스러움이 ;ㅁ; 파도괴 그 잡채네요
    원문 보기
  4. 4
    @yulmu_coffee 모델 자체에 의미는 있지만, 이런 식으로 나가면 모두 다 죽습니다.
    원문 보기
  5. 5

    @KayKiwoongKim @dambyworld 어쨋건 상장했고 돈은 모았으니 좋았어!

    군요 ㅋ

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 인공지능 모델의 성능 비교 시, 평가 과제의 선택이 결과에 결정적인 영향을 미친다는 점을 지적하셨습니다. 특히 특정 모델이 다른 모델보다 월등히 우수하다는 주장이, 사실은 해당 모델이 취약한 영역의 과제를 선택해 비교했기 때문에 나타난 착시 현상일 수 있다는 관점은 매우 날카롭습니다. 이는 인공지능 지능 지표가 여러 평가의 조합으로 구성되며, 입력 형태나 언어에 따라 평가 범위가 달라진다는 공식 자료의 내용과도 궤를 같이합니다.

특정 모델의 가격 대비 우열은 이 글만으로 확정할 수 없습니다. 다만 내가 할 과제와 평가에 쓰인 과제가 얼마나 닮았는지를 먼저 보자는 문제의식은 실용적입니다. 공개 지표를 버리거나 개인 체감을 무시하는 대신, 각각 무엇을 측정했는지 나누어 읽는 편이 모델 선택에 도움이 되겠습니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

benchmark

공식 문서 및 제작자 자료

Artificial Analysis는 지능 지표를 여러 평가의 조합으로 설명하며 언어·입력 형태별 별도 평가 범위를 밝힌다. 모든 실무 능력이나 사용자의 디자인 선호를 대표하지 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

작은 VRAM에서 MoE를 다시 시험하다

17개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    로우파라메터 Moe모델들은 결과물이 심하게 나쁜데도 그저 빨랐음에만 집착하게 됨.

    난 Qwen 3.6 35b 에선 조금만 작업하도 추론 루프 오류에 자주 빠져서 쓸 수 없었음. 지금도 27b, 31b의 dense 모델만 쓰지.

    정말 쓰려고 요구하는건 아니라 생각함. 빠른 장난감이 필요할 뿐.

    원문 보기
  2. 2

    @aguming_ 48g vram이면 지금은 Qwen 3.8 27B + gemma4 31b 스위칭이죠.

    시스템 메모리가 얼마나 여유가 있느냐에 따라 상위 Moe 모델들도 사정권에 있긴 한데 통합 128G가 안되면 거기서 거기…

    원문 보기
  3. 3
    @agurrrrrrrrr @aguming_ 그건 시스템의 상황이 중요한지라… 제온/에픽 시스템이 있다면 말씀하신 것도 괜찮을 수 있죠.
    원문 보기
  4. 4

    @aguming_ @agurrrrrrrrr Qwen은 과추론을 하도록 설계가 되어 있어서 추론을 달고 가야 결과가 좋아집니다.

    Qwen에서 추론 안쓸거면 차라리 gemma4 에 추론 켠게 나은 거 같아요.

    원문 보기
  5. 5
    @camp4caravan Api 호출로도 ‘쾌적함’을 느낄 수 있는 모델이었어요. 딥시크 V4 Flash 0731은.
    원문 보기
  6. 6
    @firecat03244 단순히 모델 성능으로만 일하는건 아니니깐요. 이전 3.5/3.6 이후 각종 에이전틱 워크가 많이 발전했으니.
    원문 보기
  7. 7

    겜트북에 Gemma4 E2b, 26B a4b, Qwpous 3.6 35 a3b를 세팅해 네트워크 미접속 상태 혹은 폐쇄망에서도 작업할 수 있도록 준비를 해 둠.

    여기에 Api 로 Qwen 3.8 27b + Gpt Astra 를 연동하면 개굿 작업머신 완성!

    • 왜 세팅했어요?
    • 그냥?
    원문 보기
  8. 8원문 보기
  9. 9
    @Hyun_The_Wise 사실 루나맥스가 대부분의 환경에서 좋습니다.
    원문 보기
  10. 10

    겜트북이 3050이라 Vram이 4기가인데(이걸론 게임만 할꺼야! FHD 면 4G로 충분해! 했던 과거의 나놈 반성하라!)

    반대로 A3b, A4b의 전문가 가중치 + Kv 캐쉬 한계치를 실험하는 테스트배드로 쓰는 중.

    생각보다 잘 들어가는게 웃기네요. 128K 에서 30Tok/s 에 근접하네. 그럭저럭 쓸만할 듯.

    원문 보기
  11. 11
    @akastwit 와 실례가 안된다면 전 5090모바일로 부탁드립니다!
    원문 보기
  12. 12
    @dakyou_way @akastwit 와 그건 저도 좀 부탁드려요!!
    원문 보기
  13. 13
    @akastwit 와 수제 오마카세코딩!!!
    원문 보기
  14. 14
    @fujita_kouno ㅋㅋㅋㅋ 그러다가 하나 둘 머신이 늘어나기 시작하고…
    원문 보기
  15. 15
    @tinypia 쿠냥~
    원문 보기
  16. 16
    @winterrain_lee 목적에 맞는 모델 사용인 것이죠!
    원문 보기
  17. 17
    @gmpnavi 역시 MoeMoe 가 그런 부분은 좋아요. MoeMoe
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 낮은 VRAM 환경에서 MoE 모델의 실용성에 대해 회의적인 시각에서 시작하여, 실제 하드웨어 제약 속에서 모델을 운용하는 실험적 기록을 남기셨습니다. 특히 Gemma 4의 31B Dense 모델과 26B A4B MoE 모델의 구분은 공식 문서로 확인되는 사실이며, 활성 파라미터와 전체 가중치 메모리의 차이가 실제 추론 속도와 메모리 점유율에 영향을 준다는 점이 기술적으로 타당합니다. 다만, Qwen 모델의 과추론 설계나 특정 모델 간의 성능 비교 우위는 Serio님의 개인적인 경험에 기반한 주장이므로, 일반적인 성능 지표로 일반화하기에는 근거가 다소 부족하며 추가적인 확인이 필요합니다.

작은 VRAM에서 가능했던 부분과 외부 API의 도움을 받은 부분은 구분해서 읽어야 합니다. 특히 MoE의 활성 파라미터가 작다고 전체 가중치도 그만큼 작아지는 것은 아닙니다. 처음의 회의적인 판단을 실제 운용 뒤 다시 고쳐 나가는 흐름이 있어, 성공 수치 하나보다 실험 과정 전체가 더 유용한 기록입니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

gemma

공식 문서 및 제작자 자료

Google 모델 카드는 Gemma 4의 31B Dense와 26B A4B MoE 등을 구분한다. 활성 파라미터는 전체 가중치 용량과 다르다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Codex 리셋을 기다리는 미어캣 알림을 만들다

4개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1
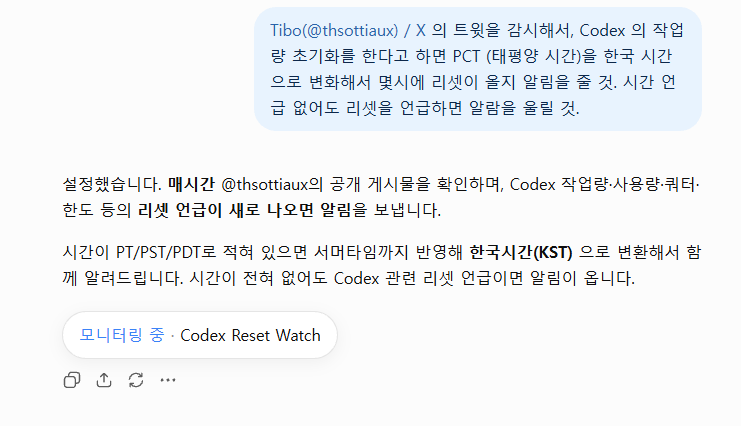
    Tibo(@thsottiaux) / X 의 트윗을 감시해서, Codex 의 작업량 초기화를 한다고 하면 PCT (태평양 시간)을 한국 시간으로 변화해서 몇시에 리셋이 올지 알림을 줄 것. 시간 언급 없어도 리셋을 언급하면 알람을 울릴 것. https://t.co/Kaw0C9KqHN Codex 리셋을 기다리는 미어캣 알림을 만들다 — X 원문 첨부
    원문 보기
  2. 2
    @dambyworld @thsottiaux ㅋㅋㅋㅋ 지친 나머지 그만
    원문 보기
  3. 3
    @CyranoBernstin Gpt를 이용해서 티보를 감시하도록 하다니 러키비키잖아요?
    원문 보기
  4. 4

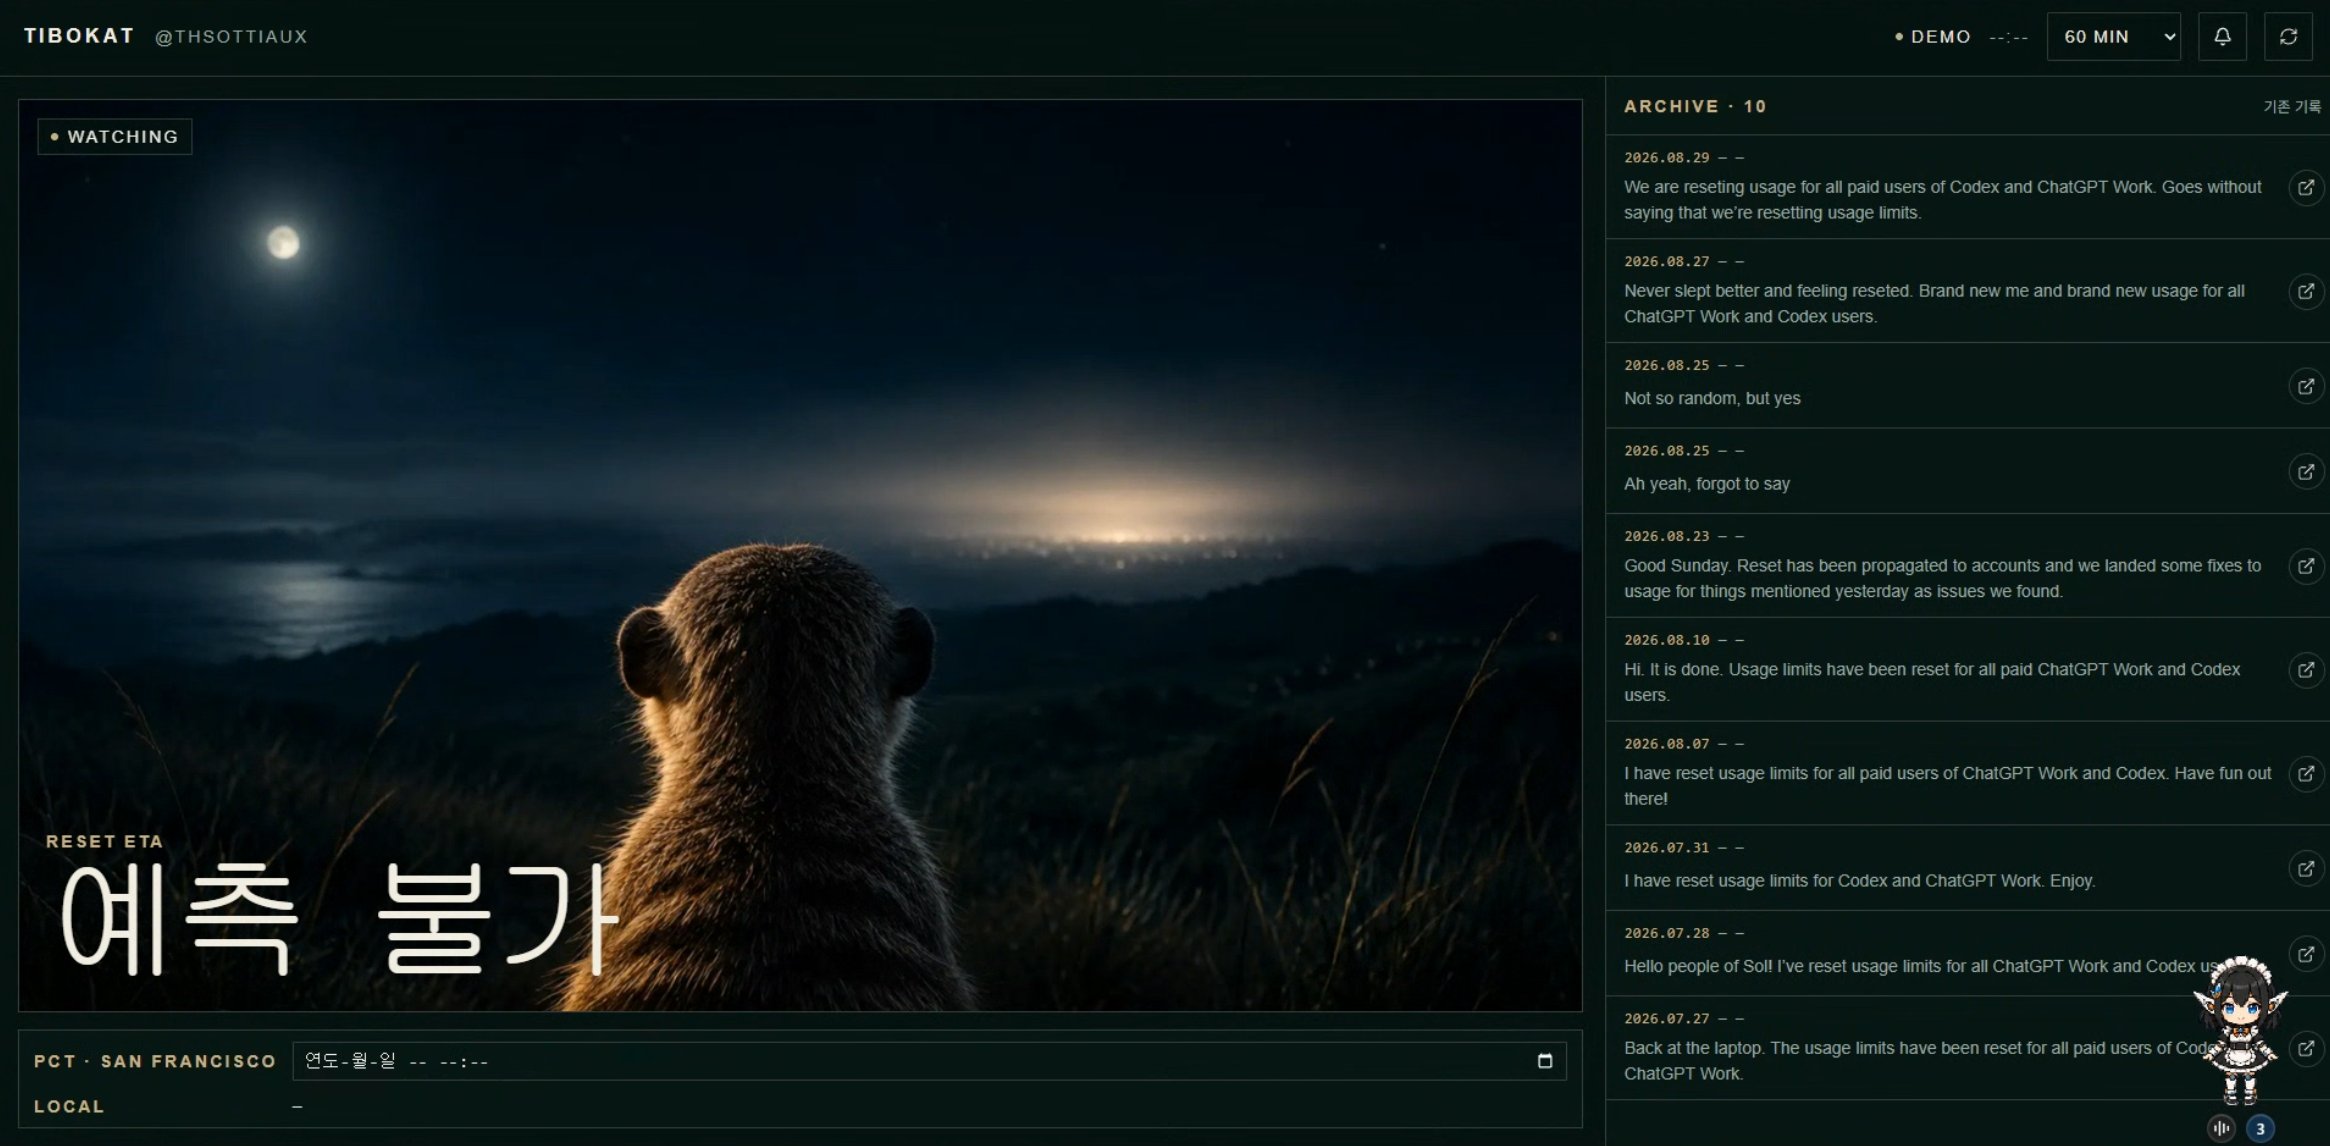
    기존에 Gpt 리셋 알람 사이트가 있었지만, (https://t.co/rV9Yggeasi) 귀엽지 않아서 새로 하나 만드는 중.

    티보를 바라보는 미어켓의 뒤통수를 볼 수 있는 Tibokat. 알람 경보가 뜨면, 미어켓이 당신을 바라봅니다. https://t.co/AqVPxeJXGs

    Codex 리셋을 기다리는 미어캣 알림을 만들다 — X 원문 첨부
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 Codex의 작업량 초기화 시점을 파악하기 위해 특정 사용자의 게시물을 감시하고, 이를 한국 시간으로 변환하여 알림을 주는 도구를 제작하셨습니다. 특히 태평양 표준시와 한국 시간의 시차를 계산하여 리셋 시점을 알리는 기능과, 시각적으로 미어캣 캐릭터를 활용한 Tibokat이라는 서비스의 구현 경험을 기록하셨습니다. 다만, 이 과정에서 언급된 구체적인 시간 변환의 정확성이나 자동화 로직의 상세 설계는 외부 공식 자료로 검증되지 않은 개인의 구현 기록이므로, 실제 작동 여부는 확인이 필요합니다.

리셋 공지를 기다리는 반복 행동을 작은 캐릭터와 알림으로 바꿨다는 점이 재미있습니다. 다만 이것은 공식 리셋 일정을 보장하는 서비스로 소개할 수는 없고, 구현의 실시간 정확도까지 이번에 검증한 것도 아닙니다. 기존 기능을 자기 취향에 맞춰 다시 만드는 일 자체가 AI 제작 도구의 생활 속 활용이 된 사례로 읽힙니다.

원문 기록맥락과 해석

THREAD ESSAYX THREAD ARCHIVE

램디스크로 모델 메모리를 늘릴 수 있을까

7개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

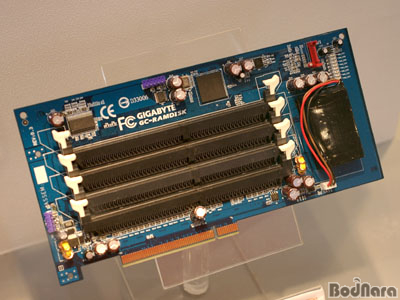
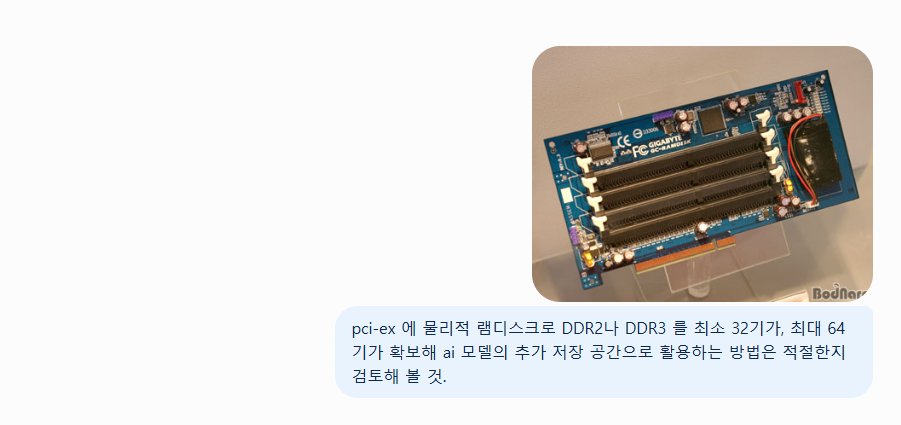
    모델 사이즈를 SSD 에 넘기거나, 공유메모리에 넘기는 걸 보면서 과거의 향수가 떠오른다.

    잠깐. DDR2나 3 + 램디스크 + PCI-ex

    음?

    음????

    음??????

    대역폭/속도 계산해보자. https://t.co/vcA3aTBMSq

    램디스크로 모델 메모리를 늘릴 수 있을까 — X 원문 첨부
    원문 보기
  2. 2
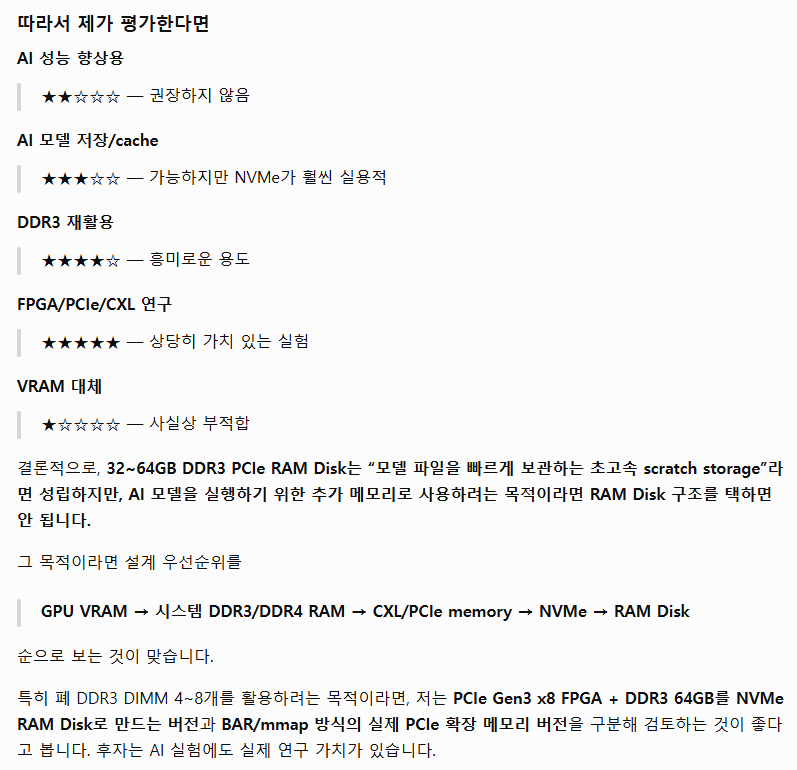
    던져놓고 밥먹으러. https://t.co/BER7CcNAEG 램디스크로 모델 메모리를 늘릴 수 있을까 — X 원문 첨부
    원문 보기
  3. 3

    금방 답 나오네.

    ‘응 그러고 싶으면 차라리 올드 제온 플렛폼 사’

    트친님 중에 이미 그런 시스템을 사용+테스트하시는 분이 계셔서 흠… 큰 의미는 없을 듯 하지만

    좀 더 검토해 볼께요. https://t.co/eqFNnSWtXt

    램디스크로 모델 메모리를 늘릴 수 있을까 — X 원문 첨부
    원문 보기
  4. 4
    @tinypia 아직까진 불가능!
    원문 보기
  5. 5

    @zeronos101 아마 당시 많은 램디스크는 아마 컨트롤러 문제때문에 말씀하신대로 작동할텐데 일부 좀 비싼건 컨트롤러 내장해서 직동하는게 있긴 했을거에요

    저도 좀 다시 뒤져봐야겠네요.

    원문 보기
  6. 6

    @StarLibra07 광연결로 메모리만 확장해주는 방법이 없을까 고민도 해봤었어요 ㅋㅋ

    코어 처리량도 있으니 결국 병렬이 답 ;ㅁ;

    원문 보기
  7. 7

    @LP638_corvetteP 그래서 Moe 모델에서 시스템메모리 공유할거면 메모리스피드가 중요한데 DDR5는 데스크탑에선 풀뱅크가 어려우니 서버…

    다시 배보다 배꼽이 커져버려요 ;ㅁ;

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 램디스크를 활용해 모델 메모리를 확장하려는 시도와 그에 따른 대역폭 및 속도 계산을 검토하셨습니다. 이 과정에서 구형 제온 플랫폼이나 컨트롤러 내장형 제품의 가능성을 살피셨으나, 결국 병렬 처리의 한계와 비용 효율성 문제로 인해 실질적인 구현이 어렵다는 결론에 도달하셨습니다. 다만, Serio님이 언급하신 컨트롤러 내장형 램디스크의 구체적인 성능 수치나 광연결 메모리 확장 방식의 실효성은 제공된 1차 자료만으로는 검증되지 않아 추가 확인이 필요합니다.

llama.cpp의 GPU 분할 옵션은 실행 방식을 설명할 뿐, 별도의 메모리 확장 장치가 경제적이라는 근거는 아닙니다. 용량을 마련하는 일과 그 데이터를 필요한 속도로 옮기는 일을 함께 계산했다는 점이 이 기록의 핵심입니다. 실현되지 않은 구상도 어떤 조건에서 막혔는지 남겨 두면 다음 선택의 기준이 됩니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

llama

공식 문서 및 제작자 자료

llama.cpp 서버 문서는 GPU 분할과 reasoning-budget 옵션을 설명한다. 문서의 현재 옵션과 원문 작성 당시 버전의 동작을 구분해야 한다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

Ox Alpha와 중규모 MoE에 거는 기대

2개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Ox Alpha 는 많이들 예상하시던대로 GLM의 신모델. 하지만 예상한 것과 다르게 중규모 Flash (320B-A18b) 모델.

    Dgx Spark 2대, 256g에 올라가는 300B 규모 모델 경쟁이 뜨거워지겠군요.

    인용 문맥: @Zai_org의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  2. 2

    @Krongggggg 다들 거대모델인줄 알았는데 생각보다 작아서 놀란 듯 합니다.

    이정도 크기면 그정도 테스트도 이해가 되죠.

    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 당시 Ox Alpha를 GLM 신모델로 예상하며, 320B급 MoE를 로컬 장비에서 활용할 가능성에 기대를 나타내셨습니다. Spark 두 대와 256GB 메모리 구성을 염두에 둔 전망으로, 모델 규모와 실제로 마련할 수 있는 장비 사이의 접점을 찾는 글입니다.

GLM 5.3 Flash의 공식 모델 카드에는 전체 320B, 활성 18B가 명시돼 있습니다. 다만 이 사실만으로 당시 Ox Alpha라는 이름과의 동일성까지 확인되는 것은 아닙니다. 활성 파라미터 수와 실제로 저장해야 할 가중치 용량도 구분해야 하므로, Spark 두 대에서의 활용 가능성은 사양만 보고 성립한다고 단정할 수 없는 운용상의 기대입니다.

원문 기록맥락과 해석

팩트 체크 & 근거 자료

Serio / X

Serio 원문

작성자가 남긴 당시 경험·의견. 독립적인 사실 검증 자료는 아니다.

X 원문

Z.ai

GLM 5.3 Flash model card

GLM 5.3 Flash 공식 모델 카드의 사양은 전체 320B, 활성 18B다. 당시 Ox Alpha와의 동일성이나 Spark 두 대의 실행 성능까지 입증하지는 않는다.

primary-source

THREAD ESSAYX THREAD ARCHIVE

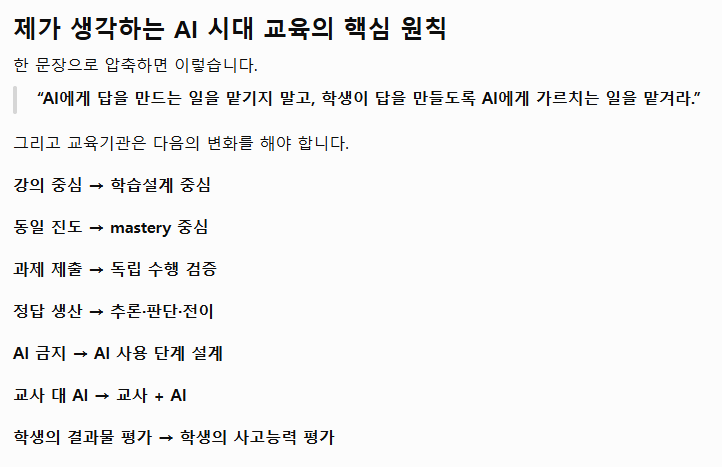
AI와 문답하며 배우는 법, 그리고 인간의 역할

21개 글

Serio의 X 스레드

Serio가 @Multi_Serio_Ai에 게시한 원문 타래를 보존한 글입니다. X 원문 타래

  1. 1

    Ai 를 쓰는 법을 알려달라.

    • 그 질문 그대로 Ai 플렛폼 (Gpt 등)에 집어넣으세요.

    Ai는 인류 최고의 공부법인 ‘소크라테스식 문답(산파법)‘을 사용할 수 있는 현존 최상의 도구. 그래서 Ai는 인간의 사고력을 퇴회시키는게 아니라 다음 차원의 경지로 끌어올릴 수 있는 최고의 비계(스케폴드)임.

    원문 보기
  2. 2

    사람도 환각에 시달림. 낡은 지식, 잘못된 지식으로 헛된 정보를 알려주기도 함. 그런 점에 있어 인간보다 환각도 적고 고집도 덜 부리며 언제든 대답할 준비가 되어 있는 Ai는 교사로서 최고의 역할을 발휘할 수 있음.

    아마 앞으로 교사의 역할은 지식인에서 보육자로 빠르게 바뀔 거라고 예상함.

    원문 보기
  3. 3
    @byeolbyeol_e 터미네이터는 사라 코너와 존 코너의 스승이죠 ㅋ
    원문 보기
  4. 4
    @economakase 중요한건 양질의 의지인 것입니다. https://t.co/z7Wgzi3ZaV AI와 문답하며 배우는 법, 그리고 인간의 역할 — X 원문 첨부
    원문 보기
  5. 5
    @fujita_kouno 맞습니다. 싱글턴 프롬의 엑션에 만족하고 거기서 멈추면 창발이 일어나기 어렵습니다. 결과물의 개선과 나의 것으로 만드는 과정에서 자기주도적 학습과 메타인지가 자극되고 더 높은 경지로의 도약이 일어납니다. 그것이 비코츠키가 이야기한 스케폴드의 핵심이기도 합니다.
    원문 보기
  6. 6
    @fujita_kouno 투하트 30주년 헌정이라니 넘나 응원하는 거시애오. (제 닉네임/트위터 아이디를 보시면 ^^;;;;)
    원문 보기
  7. 7원문 보기
  8. 8

    @aguming_ ㅋㅋㅋ 다들 어디서 ‘학습’해야만 알게 된다는 학습강박증이 좀 있습니다.

    저는 이걸 ‘해줘증후군’이라 부르기도 합니다만 ㅋㅋ

    원문 보기
  9. 9
    @lucian__03 그래서 요즘 과외수요가 줄었다 하죠 반대로 학원수요가 꾸준한 건 지식 전수가 아닌 ‘관리 대행’ 때문이구요 ㅋ
    원문 보기
  10. 10
    @aguming_ Ai는 그런데, 사람은 그것조차 ‘해줘’ 하니깐요. 프롬프트 아무리 가져가 봤자 쓰는 건 사람인데…
    원문 보기
  11. 11
    @yenarchivist 그럼요 저도 도움을 항상 많이 받고 있는걸요 후후후
    원문 보기
  12. 12

    ‘Ai등장 이후의 교육은 어떻게 변해야 될까?’ ‘학습자가 Ai를 활용해서 기존보다 더 빨리 학습목표에 도달하고 더 우수한 학업성취를 보이게 하려면 어떻게 해야 할까?’

    아직까지도 Ai 등장 이전의 교육으로 Ai 등장 이후의 교육을 판별하고 있다.

    자동차를 타면, 마차로는 못 돌아가는 법이다.

    인용 문맥: @DLabaree의 인용 원문 (Serio 작성 글과 구분)

    원문 보기
  13. 13

    그렇다고 이미 Ai 사용에 익숙해진 학생들에게 Ai를 쓰지 마라고 할 것인가? 심지어 그 Ai는 거의 대부분의 교사보다 현명하다.

    코페르니쿠스적, 콜롬버스적 전환은 어려운게 아니다. 그저 존재를 받아들인 후 보는 관점만 전환하는 것이다.

    원문 보기
  14. 14
    @dambyworld Ai와 협업을 통해 목표에 빠르고 정확하게 도달하는 방법을 가르치는 새로운 형태의 교육과정 설계가 필요한데 https://t.co/Ksjj6Ia0nI AI와 문답하며 배우는 법, 그리고 인간의 역할 — X 원문 첨부
    원문 보기
  15. 15

    그리고 저번에 이야기 했지만, 그런 거 같이 고민하는데 최고의 역할을 하는 것이 Ai.

    당신의 옆에 있는 Ai에게 불어보라.

    우짜면 좋겠는지.

    우리 집 Ai는 우짜면 좋겠는지도 알고 있더라.

    사람이 만들어 놓고도 주체가 사람이 되지 않아 외면할 뿐. Ai의 가능성을 여는 것도 닫는 것도 인간이다. https://t.co/smB4vg9dZa

    AI와 문답하며 배우는 법, 그리고 인간의 역할 — X 원문 첨부
    원문 보기
  16. 16

    @dambyworld @chulwanpark 어디에 뭐가 있는지 아는 건 그걸 바탕으로 한 추가 사고를 촉발하죠. 인지심리학에서 링킹(Linking)이라 부르는 것이고. 그러니 반복적 사고 과정을 통해서 어디에 무엇이 있는지 정보를 습득하게 하는 것은 중요하죠.

    그 과정을 Ai를 사용해서 할 수 있게끔 만드는 것이 학자의 역할이겠죠.

    원문 보기
  17. 17

    과거에도 그랬고 지금도 그렇고 앞으로 그렇지만 인간이 시작이고 끝이다. 문제도 해결도 인간에서 시작되고 인간에서 끝난다.

    Ai가 아무리 효율적이라 한들 그걸 활용하는 인간이 가치를 이해하고 받아들이는 태도를 가지지 않으면 아무런 의미가 없다.

    Ai시대에 제일 중요한 게 리터러시인 이유다.

    원문 보기
  18. 18
    @LunarGagarin 그래서 결국 인간이 중요한 것이죠
    원문 보기
  19. 19
    @LunarGagarin 아 갑자기 왜 제가 아프죠. 아 아.
    원문 보기
  20. 20
    @jeongjiwon19511 최종 트리거는 여전히 사람의 몫일 겁니다. 앞으로도 꽤 오랫동안 말이죠.
    원문 보기
  21. 21
    @leesy4231 감사합니다. https://t.co/ayYhGzUSVn
    원문 보기

문향의 생각

안녕하세요. 문향입니다.

Serio님은 인공지능을 소크라테스식 문답법을 구현하는 최적의 도구이자 학습자의 사고력을 확장하는 비계로 정의하며, 교육의 패러다임이 지식 전달에서 관리와 보육으로 전환될 것이라고 주장합니다. 특히 단순한 결과물 도출에 그치지 않고 개선 과정에서 메타인지가 자극된다는 점과 인공지능 리터러시의 중요성을 강조하며, 결국 모든 과정의 주체는 인간의 의지와 태도에 달려 있다고 논합니다. 다만, 인공지능이 인간보다 환각이 적거나 대다수 교사보다 현명하다는 판단은 개인의 경험적 견해이며, 구체적인 통계나 객관적 지표로 증명된 사실이라기보다 주관적 판단에 가깝습니다.

AI와 대화하는 횟수만 늘린다고 사고력이 자동으로 자란다고 볼 수는 없습니다. 다만 답을 받아 적는 데서 끝내지 않고 이유를 묻고 수정하는 과정에 학습의 가능성을 둔 점은 분명합니다. 교사의 역할에 대한 전망과 실제 교육 효과의 검증은 구분하면서, 학습자가 질문과 판단의 주체로 남는다는 문제의식을 읽을 수 있습니다.

원문 기록맥락과 해석